
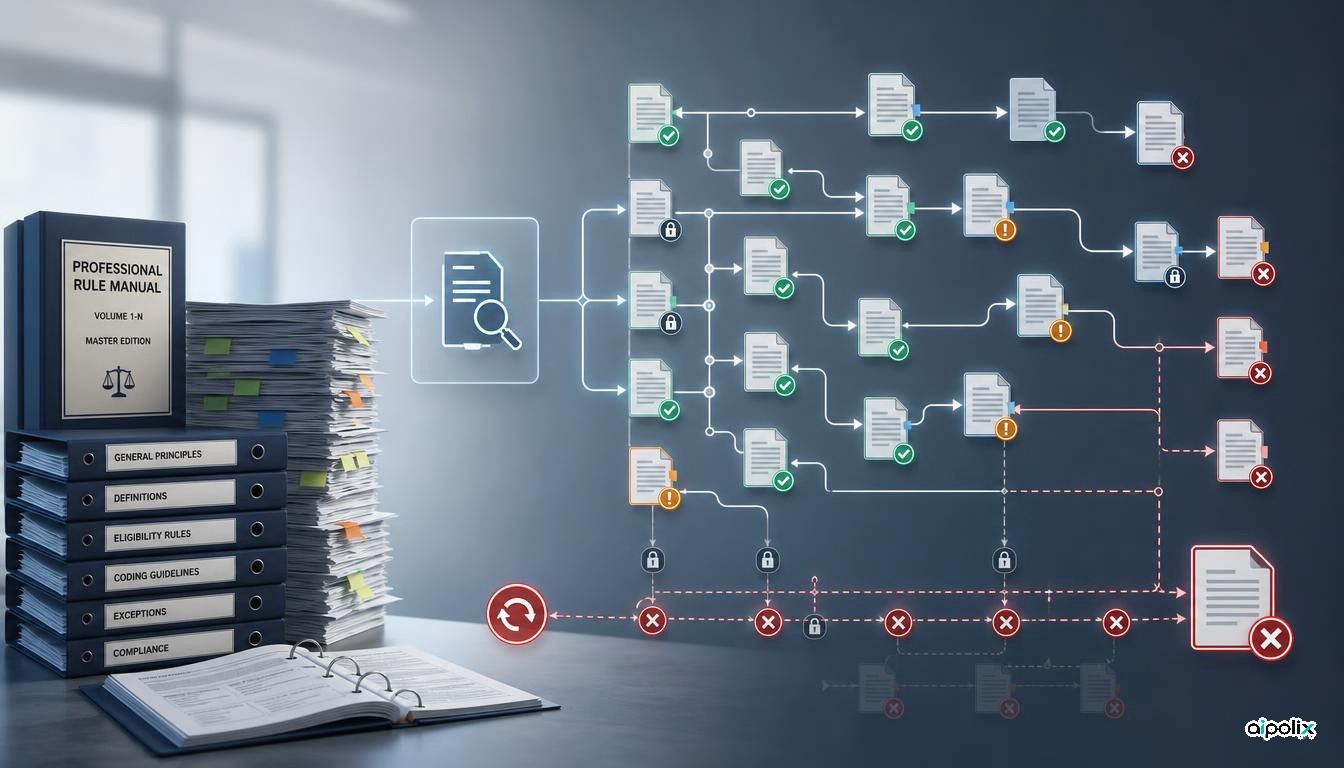
یک بنچمارک تازه که برای CIKM 2026 پذیرفته شده، سؤال سختتری از مدلهای زبانی میپرسد: نه اینکه آیا متن مرتبط را پیدا میکنند، بلکه آیا میتوانند یک دستورالعمل حرفهای را از ابتدا تا انتها درست اجرا کنند، وقتی یک اشتباه زودهنگام ممکن است تمام تصمیمهای بعدی را خراب کند؟
پژوهشگران Manulife بنچمارک Tasks over Application Manuals (TAM) را با دو کار قانونمحور ساختهاند: کدگذاری بالینی ICD-10-CM و محاسبه سطح مجازات بر اساس دستورالعملهای فدرال آمریکا. پاسخهای مرجع با بازبینی انسانی تهیه شدهاند و سیستم باید میان هزاران صفحه متن و دهها هزار قاعده و ارجاع متقابل حرکت کند.
در آزمایشهای GPT-5 با RAG تکمرحلهای، RAG عاملمحور، ReAct و یک معماری عامل چندمرحلهای، بهترین دقت دقیق فقط ۱ درصد در کدگذاری ICD-10-CM و ۱۵٫۵ درصد در محاسبات مجازات بوده است. خود مقاله تأکید میکند که اینها خطمبنای اولیه مبتنی بر پرامپت هستند، نه ارزیابی جامع همه روشهای تخصصی.
نتیجه این نیست که GPT-5 «توان استدلال ندارد». نکته دقیقتر این است که موفقیت در آزمونهای کوتاه بازیابی و استدلال چندمرحلهای، تضمین نمیکند سامانه بتواند دهها تصمیم وابسته را در یک فرایند طولانی و سازگار نگه دارد.
پیدا کردن قاعده فقط یک بخش کار بود
TAM از سیستم میخواهد قاعده درست را تشخیص دهد، ارجاعهای متقابل را دنبال کند، تصمیمهای قبلی را حفظ کند، استثناها را با ترتیب درست اعمال کند و اگر اطلاعات تازه تصمیم قبلی را بیاعتبار کرد، مسیر را اصلاح کند.
در بخش پزشکی، آزمون از فهرست الفبایی ۱۳۰۴ صفحهای، فهرست جدولی ۱۹۴۲ صفحهای و دستورالعملهای رسمی ICD-10-CM استفاده میکند. مجموعه داده شامل ۱۰۰۰ پرونده از میان ۳۸٬۳۳۲ مورد واجد شرایط است. بخش حقوقی نیز ۲۰۰ پرونده بازبینیشده انسانی را با نسخههای سالانه Title 18 و دستورالعملهای مجازات سالهای ۲۰۲۱ تا ۲۰۲۵ ترکیب میکند.
این طراحی ضعفی را آشکار میکند که ارزیابی معمول RAG ممکن است پنهان کند. مدل میتواند قاعده مرتبط را پیدا کند و در همان لحظه تصمیمی معقول بگیرد، اما پاسخ نهایی غلط باشد چون در ابتدای مسیر شاخه اشتباهی را انتخاب کرده یا یکی از الزامهای بعدی را جا انداخته است.
از میان ۵۰ اجرای ناموفق ReAct، در ۳۸ مورد نخستین خطای قابل مشاهده، از دست رفتن سازگاری کلی فرایند بوده است. هفت اجرا پیش از تکمیل مراحل متوقف شدهاند و پنج مورد یک الزام ضروری را از قلم انداختهاند.
چندعاملبودن مشکل وضعیت کلی را خودکار حل نکرد
پژوهشگران یک خطمبنای مبتنی بر LangChain Deep Agents را نیز آزمودهاند. کار بین چند مرحله و چند عامل تقسیم میشود و هر عامل فقط پرونده، بخش مرتبط دستورالعمل و یادداشتهای لازم از مرحله قبل را دریافت میکند.
این معماری به بسیاری از سامانههای واقعی امروز شبیه است: وظیفه را خرد کن، زمینه هر عامل را محدود نگه دار و نتیجه میانی را ساختاریافته به مرحله بعد بده.
اما TAM نشان میدهد خرد کردن مسئله کافی نیست. اگر سامانه وضعیت کلی را درست نگه ندارد، محدودیتهای جمعشده را دوباره بررسی نکند و هنگام ناسازگار شدن یک تصمیم قدیمی نتواند به عقب برگردد، چندعاملبودن فقط همان خطای فرایندی را میان چند جزء پخش میکند.
پنجره زمینه بزرگتر، بازیابی بهتر و ارکستراسیون عاملها سه مسئله متفاوت را حل میکنند و هیچکدام بهتنهایی صحت فرایند از ابتدا تا انتها را تضمین نمیکنند.
شواهد قویتر است، اما محدودیتها مهماند
TAM بر دستورالعملهای حرفهای واقعی تکیه دارد، پاسخهای بازبینیشده انسانی دارد و داده، کد، پرامپتها، تنظیمات عاملها و ابزارهای پیمایش متن را عمومی کرده است. مقاله نیز برای سیوپنجمین کنفرانس ACM International Conference on Information and Knowledge Management یا CIKM 2026 پذیرفته شده است.
در عین حال، TAM فقط دو حوزه با پاسخ دقیق را پوشش میدهد و نماینده کارهایی نیست که ذاتاً به قضاوت انسانی وابستهاند. پژوهش نیز همه مدلها و روشهای تخصصی یا آموزشدیده را مقایسه نکرده است.
نکته عملی دیگری هم وجود دارد: ۳۵ مورد از ۲۰۰ پرونده حقوقی برای معماری عامل پیش از پایان متوقف شدهاند، چون متن قانونی بازیابیشده فیلتر محتوای ارائهدهنده مدل را فعال کرده است. بنابراین بخشی از نتیجه علاوه بر توان استدلال، وابستگی به سیاست سرویسدهنده و زنجیره ابزار را نیز نشان میدهد.
در بخش پزشکی هم ضعف را نمیتوان فقط به اختلاف میان کدگذاران نسبت داد. بهترین نتیجه جزئی فقط نرخ بازیابی ۳۷ درصد و ۵۰٫۱ درصد دقت تشخیص اصلی داشته است.
چرا TAM برای عاملهای سازمانی مهم است
تحلیل Aipolix این است که TAM شکافی را اندازه میگیرد که برای اتوماسیون سازمانی بسیار مهم است. بیمه، کنترل مالی، انطباق، خرید، امور اداری سلامت، مالیات و فرایندهای تأیید پر از دستورالعملهایی هستند که قواعد پراکنده باید با ترتیب درست اجرا شوند و وضعیت تصمیمها در طول یک زنجیره بلند حفظ شود.
ممکن است هر پاسخ میانی منطقی به نظر برسد، اما کل فرایند غلط باشد.
پس ارزیابی هم باید فراتر از پیدا کردن سند درست یا تولید پاسخ نهایی قانعکننده برود. باید مسیر تصمیم را سنجید: چه قواعدی فعال بودهاند، کدام محدودیتها حل نشدهاند، آیا تصمیم تازه تصمیم قبلی را بیاعتبار کرده، مرحله اجباری جا افتاده یا نه و سامانه چه زمانی باید به عقب برگردد.
پیام معماری روشن است: عامل قابل اعتماد به وضعیت صریح، ردیابی محدودیتها، نقاط کنترل برای راستیآزمایی و امکان اصلاح تصمیم نیاز دارد؛ نه فقط زمینه بزرگتر یا جستوجوی بیشتر.
TAM حکم نهایی درباره مدلهای مرزی نیست. بنچمارک تازه است و فقط دو حوزه دارد؛ روشهای تخصصی ممکن است سریعتر پیشرفت کنند. اهمیت انتشار عمومی همین است: داده روی Hugging Face و پیادهسازی در GitHub در دسترس است تا گروههای دیگر بتوانند روشهای ساختاریافتهتر را آزمایش کنند.
فعلاً هشدار کاربردی این است: امتیاز خوب در آزمون استدلال کوتاه، مدرک کافی برای سپردن یک فرایند حرفهای طولانی به عامل هوش مصنوعی نیست.
چالش فقط پیدا کردن قاعده درست نیست؛ سامانه باید بعد از تصمیم بیستم هم بداند کدام قواعد هنوز معتبر و الزامآورند.