
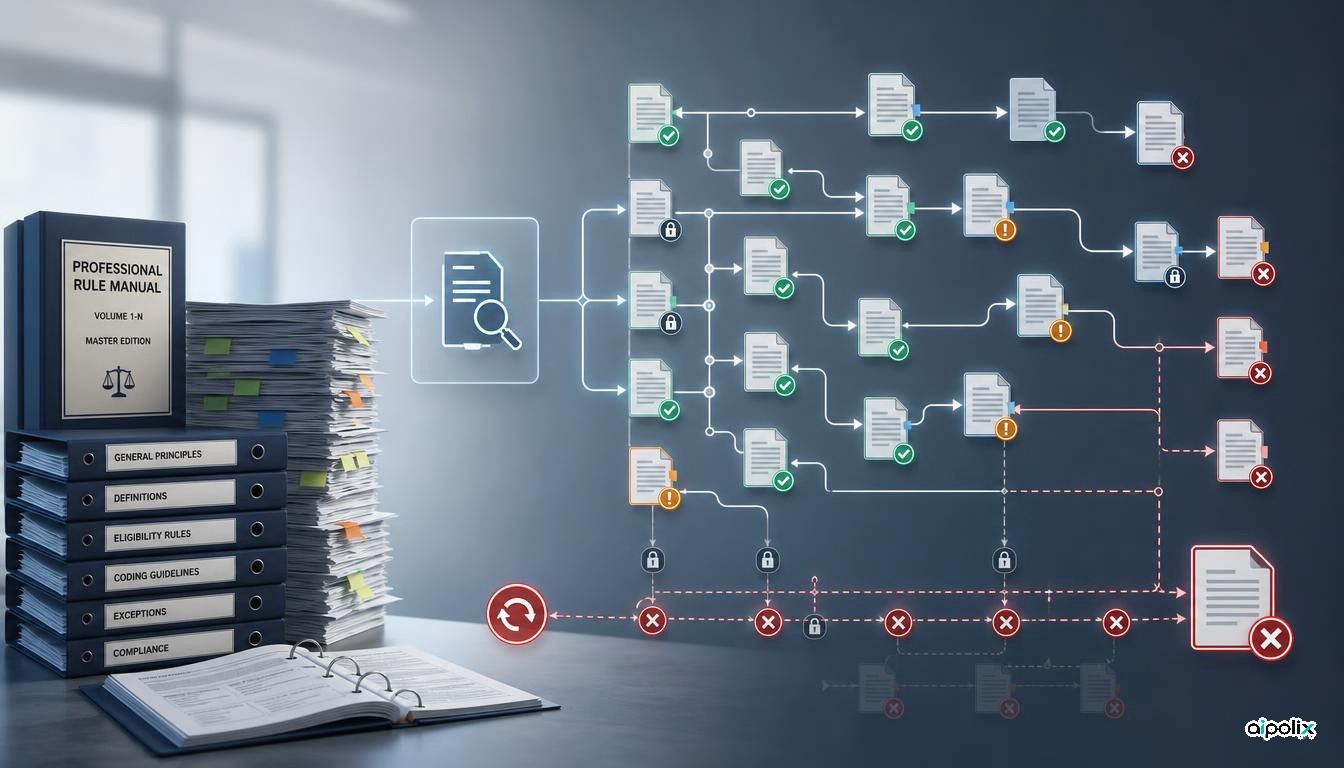
Un nouveau benchmark accepté à CIKM 2026 pose une question plus exigeante que la simple recherche du bon passage : un modèle peut-il appliquer un manuel professionnel de bout en bout quand une erreur précoce risque d’invalider toutes les décisions suivantes ?
Des chercheurs de Manulife proposent Tasks over Application Manuals (TAM), construit autour de deux tâches régies par de nombreuses règles : le codage clinique ICD-10-CM et le calcul du niveau d’infraction selon les Federal Sentencing Guidelines américaines. Les réponses de référence sont validées par des humains et les systèmes doivent naviguer dans des milliers de pages, des dizaines de milliers de règles et de nombreux renvois.
Avec GPT-5, les configurations de référence fondées sur un RAG simple, un RAG piloté par des agents, ReAct et une architecture d’agents n’atteignent au mieux que 1 % d’exact match sur le codage ICD-10-CM et 15,5 % sur la détermination de peine. Les auteurs précisent qu’il s’agit de configurations de référence initiales fondées sur des instructions, et non d’une comparaison exhaustive de tous les systèmes spécialisés.
TAM ne montre donc pas que GPT-5 « ne sait pas raisonner ». Il met en évidence un problème plus précis : réussir des tâches courtes de récupération ou de raisonnement multi-étapes ne garantit pas la capacité à conserver un état global cohérent pendant des dizaines de décisions dépendantes.
Retrouver la règle n’était qu’une étape
TAM oblige le système à déterminer la règle applicable, suivre les renvois, conserver les décisions antérieures, appliquer les exceptions dans le bon ordre et revenir sur un choix si une contrainte ultérieure le rend incompatible.
La partie médicale utilise notamment un index alphabétique de 1 304 pages, une liste tabulaire de 1 942 pages et les règles officielles ICD-10-CM. Le jeu de données comporte 1 000 cas choisis parmi 38 332 dossiers éligibles. La partie juridique comprend 200 cas validés manuellement, avec les archives annuelles du Title 18 et les manuels de 2021 à 2025.
Cette structure révèle une faiblesse qu’une évaluation RAG classique peut masquer. Le modèle peut retrouver une règle pertinente et prendre une décision localement plausible tout en aboutissant à une réponse finale invalide, parce qu’il a emprunté une mauvaise branche plus tôt ou oublié une obligation plus tard.
Parmi 50 trajectoires ReAct non exactes, 38 présentent une incohérence globale comme première divergence visible. Sept exécutions s’arrêtent avant la fin et cinq omettent un élément obligatoire.
Une architecture multi-agent ne résout pas automatiquement le problème d’état
L’étude évalue aussi une baseline utilisant LangChain Deep Agents. Le travail est réparti entre plusieurs étapes et travailleurs ; chacun reçoit uniquement les documents, le passage du manuel et les notes nécessaires à son rôle.
Cette architecture ressemble à de nombreux agents en production : décomposer la tâche, limiter le contexte de chaque composant et transmettre des résultats intermédiaires structurés.
Mais la décomposition ne suffit pas. Sans représentation fiable de l’état global, contrôle des contraintes accumulées et mécanisme de retour en arrière, une architecture multi-agent peut simplement propager la même erreur procédurale d’un composant à l’autre.
Grand contexte, récupération documentaire et orchestration d’agents répondent à des problèmes différents. Aucun ne garantit à lui seul l’intégrité d’une procédure.
Des preuves solides, avec des limites importantes
TAM s’appuie sur des manuels professionnels réels, utilise des cibles validées manuellement et publie les données, le code, les prompts, la configuration des travailleurs et les outils de navigation. L’article a été accepté à la 35e ACM International Conference on Information and Knowledge Management, CIKM 2026.
Les limites sont claires. Le benchmark ne couvre que deux domaines à sortie exacte et ne représente pas les processus où le jugement humain est volontairement subjectif. L’étude compare des approches représentatives guidées par des instructions, pas tous les systèmes spécialisés ou entraînés.
Autre détail important : 35 des 200 cas juridiques se sont arrêtés prématurément dans l’architecture d’agents parce que le texte de loi récupéré a déclenché un filtrage de contenu côté fournisseur. L’évaluation expose donc aussi des dépendances aux politiques du fournisseur et à la chaîne d’outils.
Dans la partie clinique, le meilleur résultat partiel n’atteint que 37 % de rappel et 50,1 % de précision sur le diagnostic principal.
Pourquoi TAM compte pour les agents d’entreprise
Pour Aipolix, TAM mesure un défaut directement pertinent pour l’automatisation professionnelle. Assurance, conformité, contrôle financier, achats, administration de la santé, fiscalité ou workflows d’approbation reposent souvent sur des procédures où des règles distribuées doivent être appliquées dans le bon ordre et où l’état doit être conservé pendant une longue chaîne de décisions.
Un agent peut sembler raisonnable à chaque étape tout en étant faux au niveau du processus complet.
L’évaluation doit donc dépasser la qualité de la recherche documentaire ou la vraisemblance de la réponse finale. Il faut vérifier la trajectoire : règles actives, contraintes encore ouvertes, décisions invalidées par une information ultérieure, étapes obligatoires oubliées et capacité à revenir en arrière.
La conséquence architecturale est claire : état explicite, suivi des contraintes, points de vérification et décisions réversibles sont nécessaires en plus du contexte et du RAG.
TAM n’est pas un verdict définitif sur les modèles de pointe. C’est un benchmark nouveau, limité à deux domaines, et des méthodes spécialisées peuvent progresser rapidement. Sa publication ouverte permet justement de comparer des machines à états structurées, des méthodes de recherche, des outils métier et des mécanismes de vérification.
Pour l’instant, le message est simple : un bon score sur un benchmark de raisonnement court ne suffit pas à prouver qu’un agent peut exécuter en sécurité une procédure professionnelle longue.
Le défi n’est pas seulement de trouver la bonne règle ; il faut encore savoir, après la vingtième décision, quelles règles restent actives.