
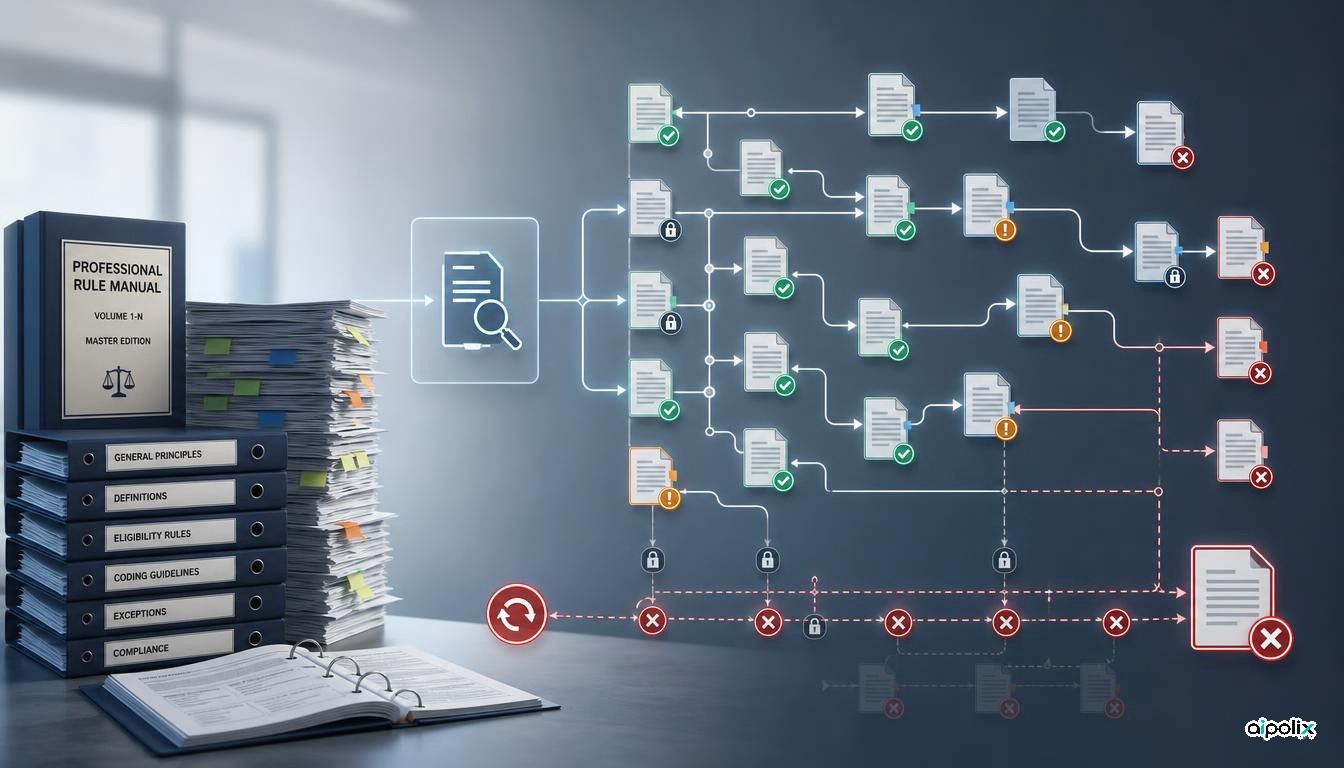
Um novo benchmark aceite na CIKM 2026 coloca uma questão mais exigente do que encontrar a passagem certa: consegue um modelo executar um manual profissional do princípio ao fim quando um erro cedo no processo pode invalidar tudo o que vem a seguir?
Investigadores da Manulife apresentaram o Tasks over Application Manuals (TAM), construído em torno de duas tarefas com muitas regras: codificação clínica ICD-10-CM e cálculo do nível de infração segundo as Federal Sentencing Guidelines dos Estados Unidos. As respostas de referência foram validadas por humanos e os sistemas têm de navegar por milhares de páginas, dezenas de milhares de regras e referências cruzadas.
Nas experiências com GPT-5, RAG numa passagem, RAG com agentes, ReAct e um arquitetura de agentes atingiram, no máximo, 1% de correspondência exata na codificação ICD-10-CM e 15,5% na determinação da pena. Os autores sublinham que são configurações de referência iniciais orientadas por instruções, não uma comparação exaustiva de todos os sistemas especializados.
TAM não demonstra que o GPT-5 «não sabe raciocinar». Mostra algo mais específico: bons resultados em tarefas curtas de recuperação de informação e raciocínio multi-etapa não garantem que o sistema mantenha um estado global coerente ao longo de dezenas de decisões dependentes.
Encontrar a regra era apenas uma etapa
TAM obriga o sistema a identificar a regra aplicável, seguir referências cruzadas, preservar decisões anteriores, aplicar exceções pela ordem correta e rever escolhas quando uma nova restrição torna o caminho anterior incompatível.
Na componente clínica, o benchmark usa um índice alfabético de 1304 páginas, uma lista tabular de 1942 páginas e as orientações oficiais ICD-10-CM. O conjunto inclui 1000 casos selecionados de 38 332 encontros elegíveis. A componente jurídica contém 200 casos revistos por humanos, recorrendo aos arquivos anuais do Title 18 e às guidelines de 2021 a 2025.
Esta estrutura expõe uma fraqueza que uma avaliação RAG convencional pode esconder. O modelo pode encontrar uma regra relevante e tomar uma decisão localmente plausível, mas chegar a uma resposta final inválida porque escolheu uma ramificação errada mais cedo ou falhou uma obrigação posterior.
Entre 50 trajetórias ReAct sem resposta exata, 38 tiveram como primeira divergência visível uma inconsistência global. Sete terminaram antes de concluir o procedimento e cinco falharam um elemento obrigatório.
Uma arquitetura multiagente não resolve automaticamente o estado global
O estudo também avalia uma baseline com LangChain Deep Agents. O trabalho é dividido por etapas e trabalhadores; cada um recebe apenas o caso, o texto do manual e as notas anteriores necessárias para a sua parte.
É uma arquitetura semelhante ao que muitas equipas estão a construir: decompor a tarefa, limitar o contexto de cada agente e passar resultados intermédios estruturados.
Mas decompor não chega. Se o sistema não preservar o estado global correto, não validar as restrições acumuladas e não conseguir recuar quando uma decisão anterior se torna incompatível, uma arquitetura multiagente pode apenas propagar o mesmo erro procedimental.
Contexto longo, recuperação documental e orquestração de agentes resolvem problemas diferentes. Nenhum garante, por si só, a integridade do processo.
Evidência forte, com limites importantes
TAM usa manuais profissionais reais, alvos validados por humanos e disponibiliza dados, código, prompts, configuração dos trabalhadores e ferramentas de navegação. O artigo foi aceite na 35.ª ACM International Conference on Information and Knowledge Management, CIKM 2026.
Os limites são explícitos. O benchmark cobre apenas dois domínios com respostas exatas e não representa processos em que o julgamento humano é deliberadamente subjetivo. O estudo compara abordagens representativas orientadas por instruções, não todos os sistemas especializados ou afinados.
Há ainda um detalhe operacional importante: 35 dos 200 casos jurídicos terminaram antes do fim no arquitetura de agentes porque o texto legal recuperado ativou o filtro de conteúdo do fornecedor. A avaliação revela, portanto, dependências da política do fornecedor e da cadeia de ferramentas, além da arquitetura de raciocínio.
Na componente clínica, o melhor resultado parcial ficou em 37% de recuperação e 50,1% de precisão no diagnóstico principal.
Porque TAM interessa a agentes empresariais
A análise da Aipolix é que TAM mede uma falha diretamente relevante para automação profissional. Seguros, controlo financeiro, compliance, compras, administração de saúde, fiscalidade e aprovações são frequentemente governados por procedimentos em que regras distribuídas têm de ser aplicadas pela ordem correta e o estado tem de sobreviver a uma cadeia longa de decisões.
Um agente pode parecer razoável em cada passo e continuar errado ao nível do processo completo.
Isso exige outra forma de avaliação. Não basta verificar se encontrou os documentos certos ou se a resposta final é convincente. É preciso testar a trajetória: regras ativas, restrições ainda abertas, decisões anteriores invalidadas, passos obrigatórios omitidos e capacidade de recuar.
A implicação arquitetural é clara: estado explícito, acompanhamento de restrições, pontos de verificação e decisões reversíveis são necessários para além de janelas de contexto maiores ou mais chamadas de recuperação.
TAM não é um veredito permanente sobre modelos de fronteira. É um benchmark novo, com dois domínios, e métodos especializados poderão melhorar rapidamente. A publicação aberta permite que outras equipas testem máquinas de estados estruturadas, pesquisa, ferramentas de domínio e mecanismos de verificação.
Por agora, o aviso é prático: um bom resultado num teste de raciocínio curto não é prova suficiente de que um agente consegue executar em segurança um procedimento profissional longo.
O desafio não é apenas encontrar a regra. É continuar a saber, depois da vigésima decisão, quais regras ainda contam.