Nouvelles fonctionnalités et innovations
-
Open source
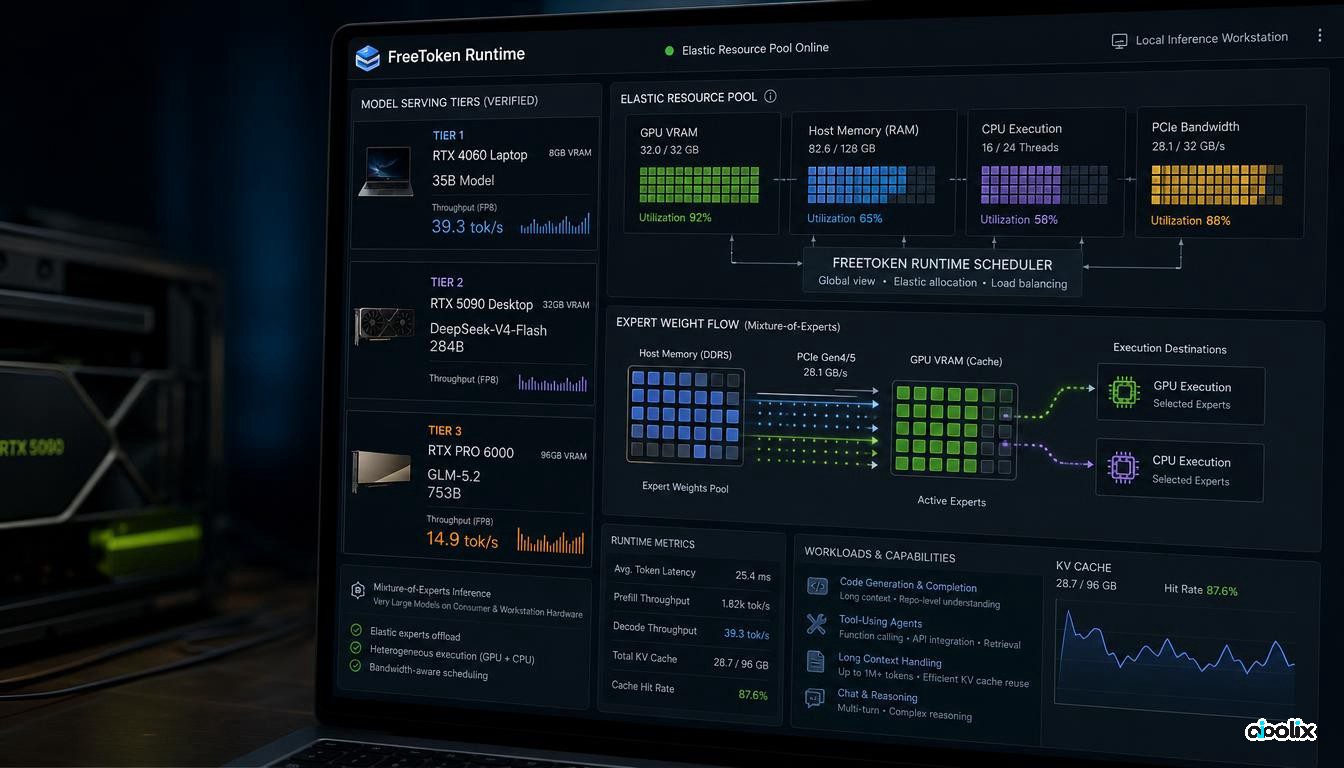
FreeToken exécute des modèles MoE géants sur des GPU grand public
FreeToken combine exécution CPU-GPU adaptative et cache sémantique pour servir des modèles MoE de 35B à 753B sur du matériel local.
-
Nouveaux modèles
Qwen3.8-Max renforce la compétition des modèles open-weight
Qwen présente Qwen3.8-Max comme un nouveau niveau pour le code et le cowork, avec l'ouverture des poids d'un modèle Qwen-Max.
-
Infrastructure et puces
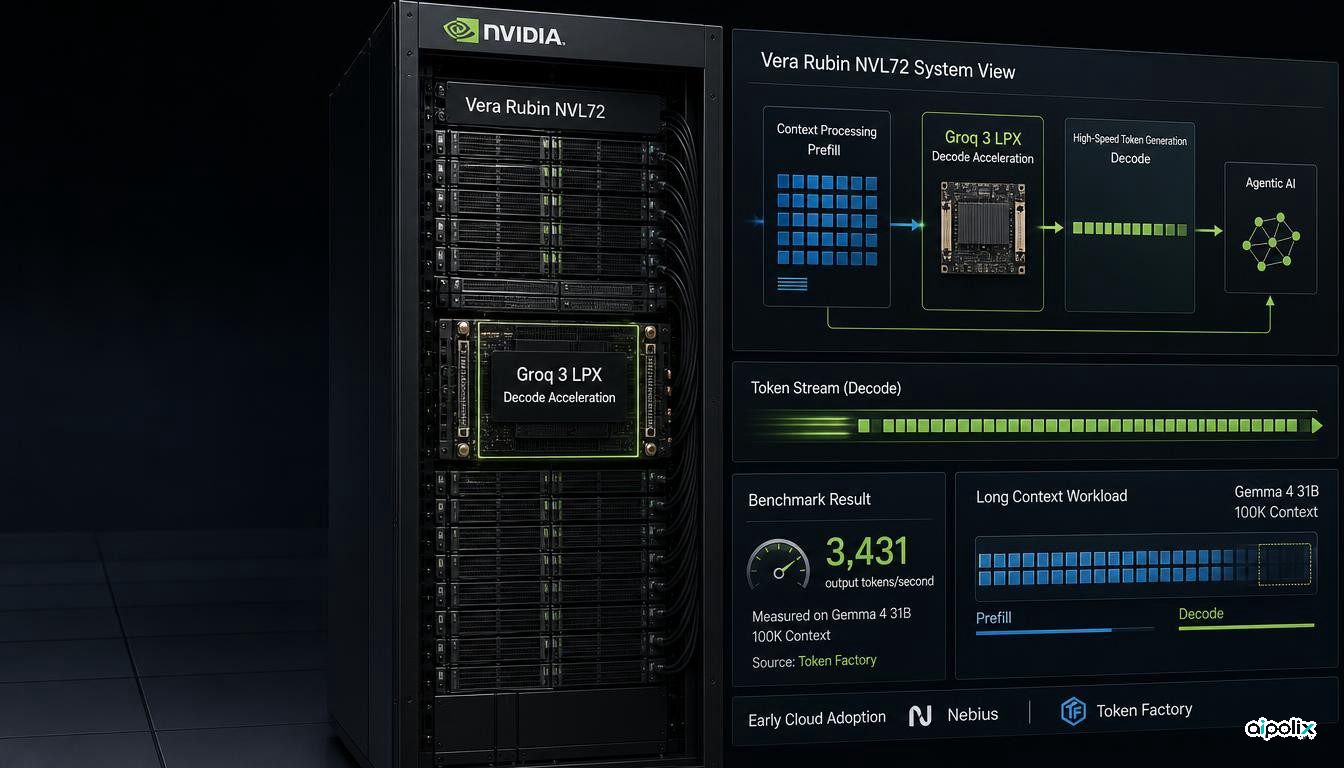
NVIDIA met Groq 3 LPX en production pour accélérer l’inférence des agents
NVIDIA passe Groq 3 LPX en production avec Vera Rubin pour cibler la latence de décodage des agents riches en tokens, avec Nebius comme premier adopteur cloud.
-
Recherche
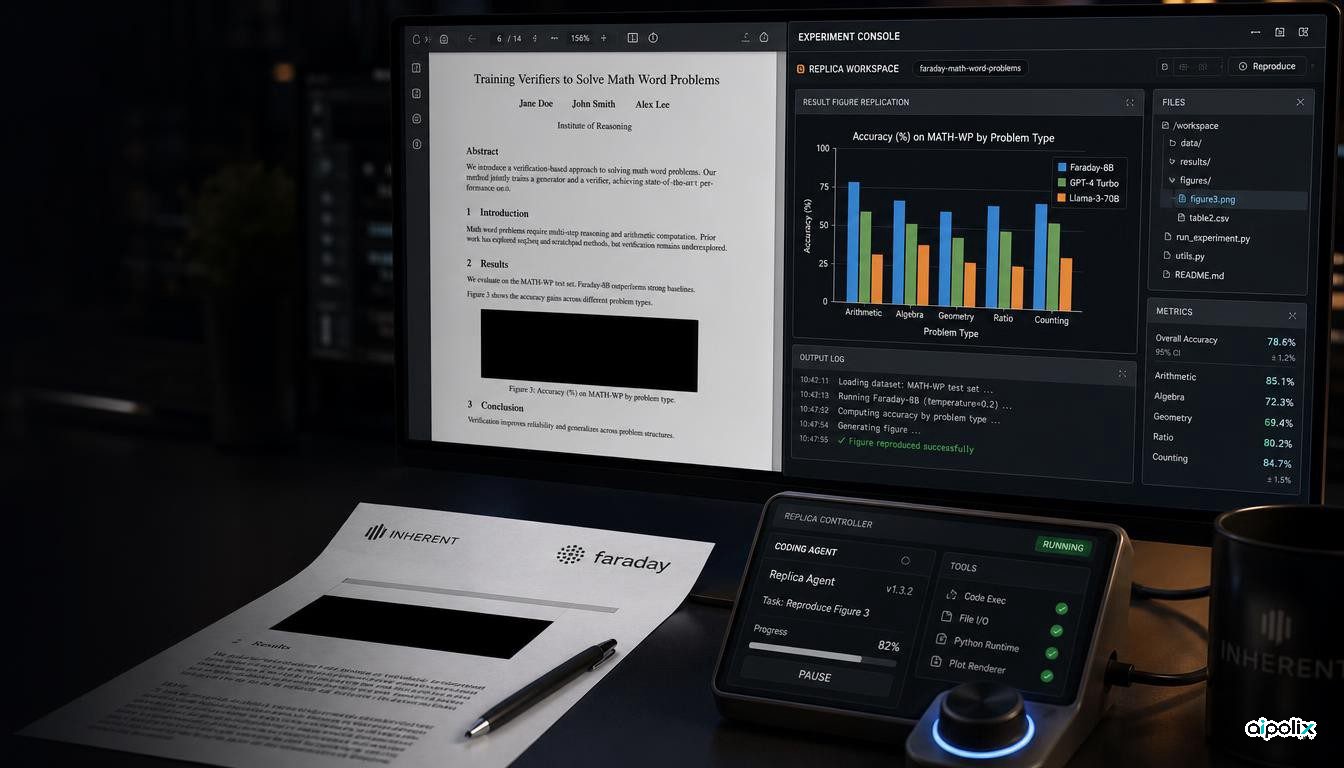
Inherent entraîne Faraday 27B à répliquer la recherche
Inherent entraîne Faraday sur Replica avec des coding agents pour reproduire des résultats scientifiques, avec des réserves importantes sur le benchmark.
-
Infrastructure et puces
Waymo dévoile sa puce IA 5 nm personnalisée pour ses robotaxis
Waymo dévoile un ASIC personnalisé 5 nm pour le traitement des capteurs de robotaxis et une architecture edge IA mêlant silicium spécialisé et commercial.
-
Nouveaux modèles
Ant Ling ouvre six checkpoints Ling 3.0 pour entraîner des LLM sur mesure
Ant Ling publie six checkpoints Ling 3.0 répartis entre deux tailles et trois étapes d’entraînement pour le préentraînement continu et la spécialisation.