
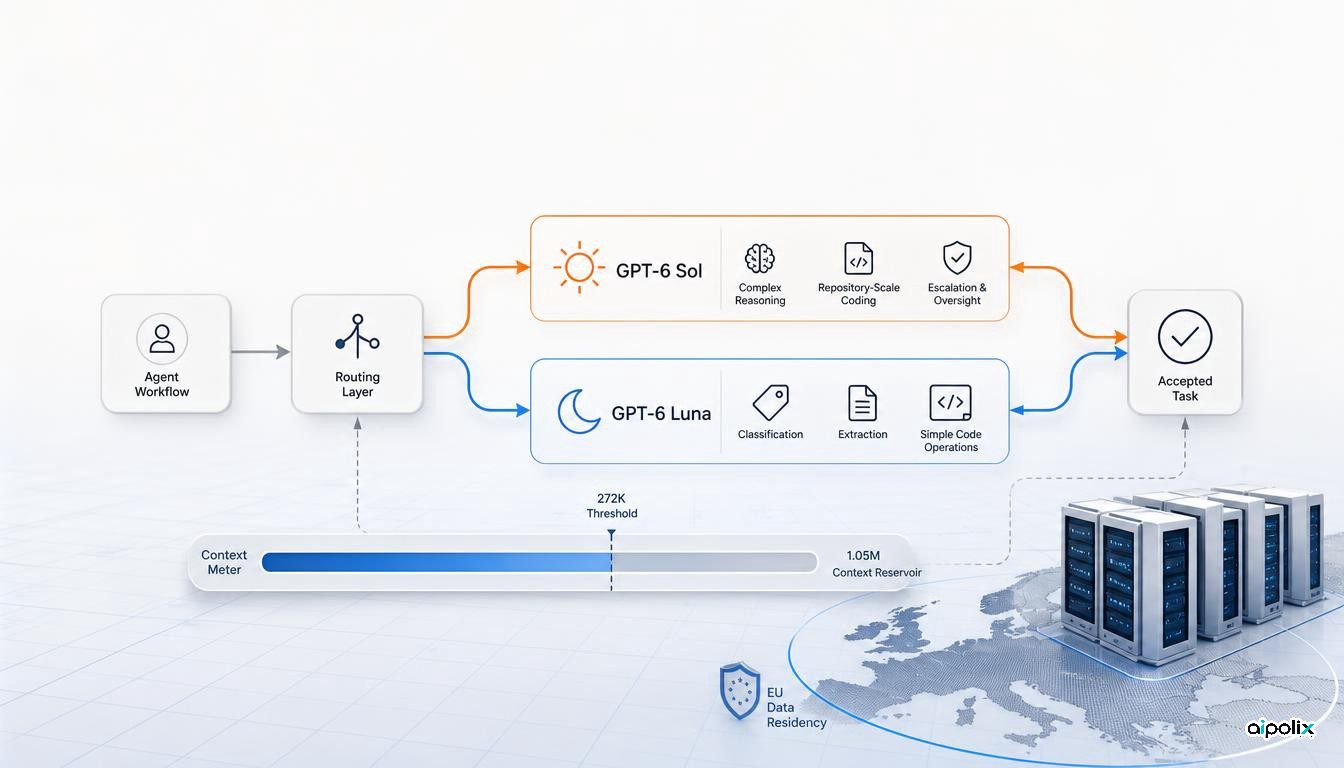
OpenAI a lancé GPT-6 Sol et GPT-6 Luna le 22 septembre, deux modèles de la famille GPT-6 destinés au raisonnement, au développement logiciel et aux systèmes d'agents avec des niveaux de coût très différents. L'écart entre Sol et Luna est assez important pour faire du routage entre modèles un choix d'architecture, et plus seulement une optimisation marginale.
Pour les requêtes Standard jusqu'à 272 000 jetons en entrée, GPT-6 Sol coûte 2 dollars par million de jetons en entrée, 0,20 dollar pour les entrées mises en cache et 10 dollars en sortie. GPT-6 Luna coûte respectivement 0,10, 0,01 et 0,50 dollar. Les deux modèles acceptent du texte et des images en entrée et produisent du texte via Responses API et Chat Completions.
Luna change le coût des étapes courantes
Les tarifs d'entrée et de sortie de Luna sont vingt fois inférieurs à ceux de Sol dans le mode Standard. Pour un agent qui effectue de nombreux classements, extractions, plans intermédiaires ou petites transformations de code, utiliser le modèle le plus puissant à chaque étape devient difficile à justifier.
L'analyse d'Aipolix est qu'il faut mesurer le routage à l'échelle du workflow complet. Luna peut traiter les étapes simples et Sol les cas difficiles, mais seulement si le modèle moins cher ne provoque pas davantage de reprises, de mauvaises décisions intermédiaires ou de vérification humaine. La bonne métrique est le coût d'une tâche acceptée.
Cette logique est particulièrement importante pour les agents, car une seule demande peut déclencher des dizaines d'appels : planification, outils, modifications, vérification et nouvelles tentatives.
Sol conserve un contexte très large pour les tâches difficiles
La documentation d'OpenAI positionne GPT-6 Sol pour la programmation complexe et les workflows agentiques. Sol dispose d'une fenêtre de contexte de 1,05 million de jetons et peut produire jusqu'à 128 000 jetons. Plusieurs niveaux d'effort de raisonnement sont disponibles, de none à max.
Un contexte aussi large peut réduire la nécessité de tronquer fortement un dépôt, de longs documents ou l'historique d'une session. Mais ce contexte supplémentaire a un prix. Au-delà de 272 000 jetons en entrée, OpenAI double les tarifs d'entrée et de cache et augmente de 50 % le prix de sortie pour l'ensemble de la requête.
Le seuil de 272 000 jetons devient donc une frontière d'architecture. Une équipe doit vérifier si le contexte supplémentaire réduit suffisamment les erreurs, les reprises ou la complexité de récupération pour justifier son coût.
Les architectures API existantes peuvent les tester directement
Sol et Luna sont disponibles dans Responses API et Chat Completions. OpenAI recommande Responses API pour les outils intégrés et les appels de fonctions avec Sol. L'entrée image permet également de construire des agents qui analysent des captures d'écran ou des documents visuels.
Les équipes déjà équipées de Responses API n'ont pas besoin d'un nouveau protocole d'agent. Elles peuvent ajouter Sol et Luna comme destinations de routage et réaliser des tests A/B en conservant les mêmes outils, permissions, instructions et critères d'acceptation.
La résidence des données ajoute une contrainte européenne
La grille tarifaire actuelle indique que la résidence des données dans l'Union européenne est disponible pour Sol et Luna uniquement avec le traitement Standard. Le traitement régional entraîne une majoration de 10 % lorsqu'elle s'applique.
Pour les organisations européennes, y compris au Portugal, le choix du modèle doit donc être évalué avec le mode de traitement réellement exigé en production. Le niveau théoriquement le moins cher n'est pas forcément utilisable si la résidence des données est obligatoire.
Des appels moins chers ne remplacent pas l'ingénierie des agents
Réduire le coût d'un appel facilite l'expérimentation, mais ne règle ni les permissions ni la fiabilité. La gestion d'état, les limites des outils, les évaluations, les points de reprise et le traitement des erreurs restent essentiels.
Luna permet surtout d'effectuer beaucoup plus d'inférence avec un budget donné. Le risque est de croire que cela réduit automatiquement le coût de la tâche. Une mauvaise décision précoce peut générer plusieurs appels supplémentaires.
Que mesurer avant de modifier la production ?
Un test utile doit comparer le modèle actuel à deux configurations : Sol seul, puis Luna avec escalade vers Sol. Les outils et règles restent identiques. Il faut suivre le taux de tâches acceptées, les escalades, les reprises, les appels d'outils, l'utilisation du contexte long, la latence et la relecture humaine.
Le lancement compte parce qu'OpenAI a fortement élargi l'éventail des prix au sein d'une même famille de modèles de raisonnement. La meilleure architecture ne sera pas nécessairement celle qui utilise le modèle le plus puissant partout, mais celle qui réserve la puissance aux étapes où elle change réellement le résultat.