
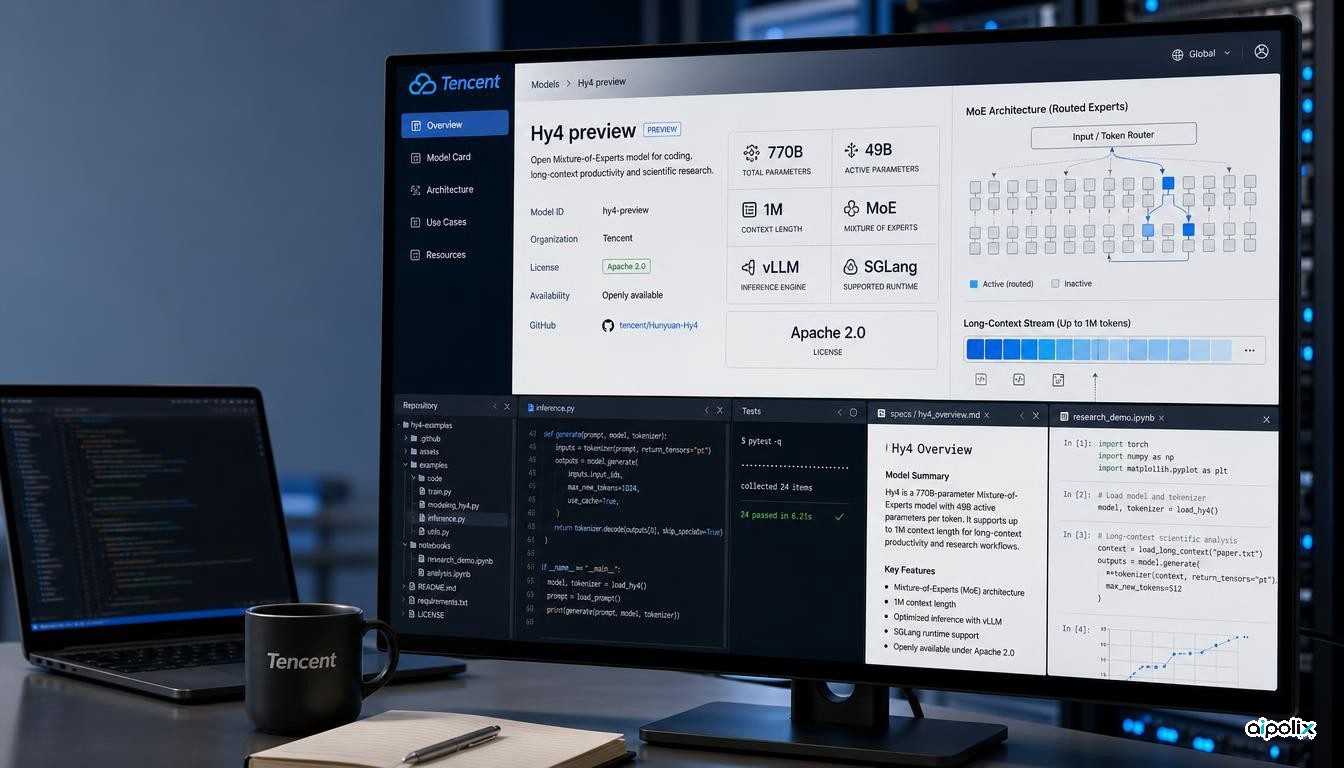
A Tencent lançou o Hy4 preview em August 28 como um grande modelo de linguagem abertamente disponível, vocacionado para engenharia de software, trabalho de escritório e investigação científica. O lançamento importa menos porque a Tencent lhe chama modelo de ponta e mais porque a empresa enviou uma superfície completa de programador em seu redor: pesos descarregáveis sob Apache 2.0, uma janela de um milhão de tokens, percursos documentados de vLLM e SGLang, ferramentas de reafinação e quantização, e acesso pago por API.
Essa combinação torna o Hy4 preview uma opção prática nova para equipas que avaliam grandes modelos abertos para trabalho de agentes de longo contexto. Segundo o anúncio da Tencent, o modelo tem 770 billion parâmetros totais mas activa 49 billion parâmetros por token. O repositório oficial descreve uma arquitectura Mixture-of-Experts com 256 peritos encaminhados, oito peritos encaminhados activos por token, um perito partilhado, atenção esparsa e uma camada nativa de descodificação especulativa. A Reuters reportou de forma independente o lançamento de August 28 e o respectivo enfoque na programação, na investigação e no trabalho analítico.
Um modelo muito grande com uma pegada activa mais pequena
O Hy4 preview é grande mesmo pelos padrões actuais dos modelos abertos. A Tencent lista 770 billion parâmetros de espinha dorsal, 49 billion parâmetros activos e um comprimento de contexto de 1 million tokens. O modelo usa um desenho Mixture-of-Experts, pelo que a maior parte dos parâmetros não está activa em cada token. Isso não torna a instalação leve, mas altera o perfil de cálculo face a um modelo denso de tamanho total semelhante.
O repositório expõe pormenores de arquitectura úteis para equipas de infra-estrutura, em vez de publicar apenas um ponto de acesso de API. A espinha dorsal tem 78 camadas. A Tencent diz que o percurso de atenção usa Gated DeepSeek Sparse Attention com um mecanismo IndexCache para reutilizar índices esparsos entre camadas. Inclui também uma camada nativa de previsão de vários tokens, destinada a apoiar a descodificação especulativa. O repositório inclui orientação de instalação para vLLM e SGLang, além de percursos de reafinação e quantização.
Para arquitectos, isto significa que o Hy4 preview pode ser avaliado como um modelo que uma organização consegue operar e modificar, não apenas consumir por detrás de uma interface alojada. O licenciamento Apache 2.0 é especialmente relevante para empresas que precisam de direitos mais claros para adaptação interna e redistribuição do que as licenças mais restritivas específicas de um modelo. As equipas devem mesmo assim examinar a licença completa e os próprios requisitos de conformidade, mas a escolha de licença reduz de forma material uma barreira comum de adopção.
A Tencent mira produtos de trabalho, não apenas conversa
A Tencent posiciona o Hy4 preview em torno de cargas de trabalho de produtividade, e não só de testes conversacionais. A empresa diz ter construído dados de treino com engenheiros de software, programadores de jogos, analistas financeiros e especialistas de segurança dentro da Tencent. O alvo declarado é trabalho de horizonte longo que abrange planeamento, depuração, validação, análise entre documentos e produção de artefactos como documentos, folhas de cálculo e apresentações.
O lançamento está também integrado em produtos da Tencent, incluindo CodeBuddy e WorkBuddy, e a Tencent afirma que está disponível através do Tencent Cloud TokenHub e do OpenRouter. Isso dá ao Hy4 preview vários percursos de avaliação: alojar os pesos internamente, usar uma API gerida, ou ensaiar o modelo através de produtos que empacotam fluxos de trabalho de agentes à sua volta.
A Tencent reporta uma avaliação cega interna envolvendo 163 especialistas e 203 tarefas de engenharia, em que o Hy4 preview obteve 2.99 em 4.00, ligeiramente acima dos modelos de comparação citados pela empresa. Esses números devem tratar-se como indícios reportados pelo fornecedor, não como uma classificação independente. O desenho das tarefas, a população de avaliadores e as condições de comparação importam, e a reprodutibilidade independente ainda não está estabelecida.
A alegação de auto-optimização é interessante, mas pede contenção
Uma das alegações mais invulgares da Tencent é que o Hy4 preview participou em partes do próprio desenvolvimento. A empresa diz que o modelo propôs abordagens, correu experiências e iterou sobre métodos de treino, estratégias de dados, enquadramentos de avaliação e operadores de baixo nível. A Tencent afirma também que o modelo analisou estrangulamentos de inferência e ajudou a produzir optimizações de fusão de operadores e de comunicação que aumentaram o débito de ponta a ponta em 31.8 percent face à respectiva linha de base.
Isto é potencialmente importante para equipas que constroem fluxos de trabalho automatizados de engenharia de modelos ou de infra-estrutura de agentes. Sugere um ciclo em que o modelo não é apenas a carga de trabalho a optimizar, mas também um participante activo no diagnóstico e na alteração do sistema em seu redor.
Contudo, os indícios vêm actualmente da Tencent. O lançamento não estabelece que o mesmo processo se generalize a outros conjuntos de modelos, ambientes de equipamento ou equipas de engenharia, e a melhoria de débito reportada depende da linha de base e das condições de implementação da Tencent. Compreende-se melhor como um caso interno concreto que merece reprodução do que como prova de auto-melhoria recursiva geral.
O que os programadores devem medir a seguir
Para uso em engenharia de software, as perguntas práticas importam mais do que as contagens de parâmetros de título. As equipas devem medir a conclusão de tarefas à escala do repositório, a fiabilidade das ferramentas, a qualidade dos remendos, a disciplina de testes, a retenção de contexto e o custo sob os próprios arreios. Uma janela de um milhão de tokens pode reduzir alguma pressão de recuperação, mas um contexto longo não produz automaticamente melhores decisões nem um custo total de inferência mais baixo.
As equipas de infra-estrutura devem também ensaiar o comportamento de disponibilização sob concorrência realista. Um percurso activo de 49 mil milhões de parâmetros continua substancial, enquanto a pegada total de 770 mil milhões cria considerações de armazenamento, colocação de memória e encaminhamento de peritos. A quantização e a descodificação especulativa podem ajudar, mas a economia de produção dependerá da topologia do equipamento, do comprimento dos pedidos e da utilização.
A Tencent lista preços de API a $0.834 por million tokens de entrada, $2.501 por million tokens de saída e $0.042 por million tokens em cache. Esses preços alojados oferecem uma linha de base útil para comparar o auto-alojamento com o acesso gerido, embora por si só não indiquem o custo total da aplicação para agentes de longa duração.
O Hy4 preview é portanto notável porque combina três coisas que muitas vezes se separam: um modelo aberto muito grande, um conjunto de instalação operável pelo programador e um enfoque claro na produção de artefactos de trabalho reais. As alegações de desempenho ainda precisam de validação exterior, e o produto é explicitamente uma pré-visualização. Mas para equipas que avaliam modelos abertos para programação e sistemas de agentes de longo contexto, o lançamento é concreto o suficiente para ser ensaiado agora, em vez de meramente observado.