
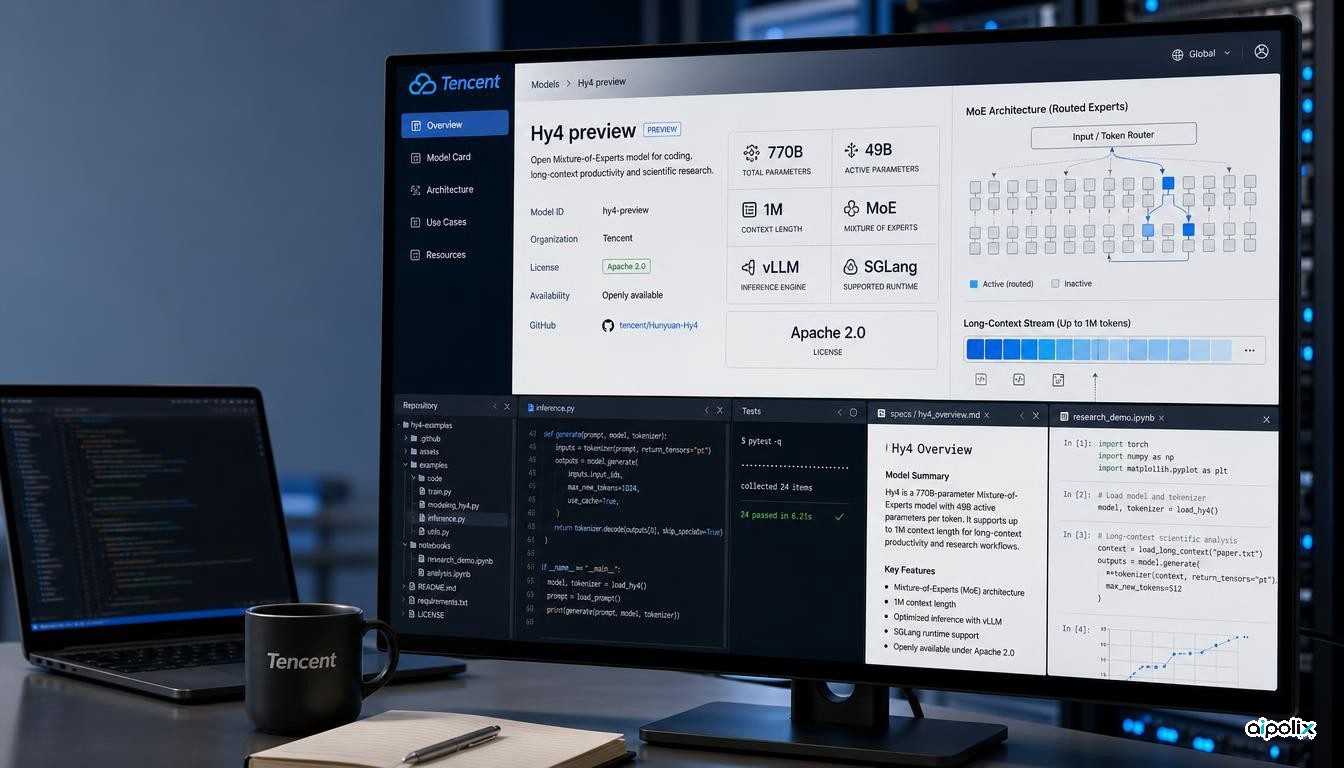
Hy4 preview est publié avec des poids Apache 2.0 et un contexte 1M-token. Tencent a publié Hy4 preview le August 28 comme un grand modèle de langage ouvertement disponible, destiné à l’ingénierie logicielle, au travail de bureau et à la recherche scientifique. La publication compte moins parce que Tencent l’appelle modèle de premier plan, et davantage parce que l’entreprise a livré une surface complète pour développeurs autour de lui : poids téléchargeables sous Apache 2.0, fenêtre d’un million de jetons, parcours documentés vLLM et SGLang, outils d’affinage et de quantification, et accès payant par API.
Cette combinaison fait de Hy4 preview une option pratique nouvelle pour les équipes qui évaluent de grands modèles ouverts pour un travail d’agents à long contexte. Selon l’annonce de Tencent, le modèle compte 770 billion de paramètres au total mais en active 49 billion par jeton. Le dépôt officiel décrit une architecture Mixture-of-Experts avec 256 experts acheminés, huit experts acheminés actifs par jeton, un expert partagé, une attention clairsemée et une couche native de décodage spéculatif. Reuters a rapporté de manière indépendante la publication du August 28 et son accent sur le code, la recherche et le travail analytique.
Un très grand modèle avec une empreinte active plus réduite
Hy4 preview est grand même selon les normes actuelles des modèles ouverts. Tencent recense 770 billion de paramètres de colonne vertébrale, 49 billion de paramètres actifs et une longueur de contexte d’un million de jetons. Le modèle utilise une conception Mixture-of-Experts, si bien que la plupart des paramètres ne sont pas actifs pour chaque jeton. Cela ne rend pas l’installation légère, mais change le profil de calcul par rapport à un modèle dense de taille totale comparable.
Le dépôt expose des détails d’architecture utiles aux équipes d’infrastructure, plutôt que de se limiter à publier un point d’accès d’API. La colonne vertébrale compte 78 couches. Tencent indique que le parcours d’attention utilise Gated DeepSeek Sparse Attention avec un mécanisme IndexCache pour réutiliser des indices clairsemés d’une couche à l’autre. Il comprend aussi une couche native de prédiction multi-jetons destinée à étayer le décodage spéculatif. Le dépôt inclut des indications d’installation pour vLLM et SGLang, ainsi que des parcours d’affinage et de quantification.
Pour les architectes, cela signifie que Hy4 preview peut être évalué comme un modèle qu’une organisation peut exploiter et modifier, et non seulement consommer derrière une interface hébergée. La licence Apache 2.0 est particulièrement pertinente pour les entreprises qui ont besoin de droits plus clairs d’adaptation interne et de redistribution que n’en offrent des licences plus restrictives propres à un modèle. Les équipes doivent malgré tout examiner la licence complète et leurs propres exigences de conformité, mais le choix de licence abaisse de façon matérielle un obstacle courant à l’adoption.
Tencent vise des produits de travail, pas seulement le dialogue
Tencent positionne Hy4 preview autour de charges de travail de productivité, et non des seules épreuves conversationnelles. L’entreprise dit avoir constitué des données d’entraînement avec des ingénieurs logiciels, des développeurs de jeux, des analystes financiers et des spécialistes de la sécurité au sein de Tencent. La cible déclarée est un travail à long horizon qui couvre la planification, le débogage, la validation, l’analyse interdocuments et la production d’artefacts tels que documents, tableurs et présentations.
La publication est aussi intégrée dans des produits Tencent, dont CodeBuddy et WorkBuddy, et Tencent indique qu’elle est disponible via Tencent Cloud TokenHub et OpenRouter. Cela offre à la préversion plusieurs voies d’évaluation : héberger soi-même les poids, utiliser une API gérée, ou essayer le modèle à travers des produits qui empaquettent des flux de travail d’agents autour de lui.
Tencent rapporte une évaluation interne à l’aveugle impliquant 163 spécialistes et 203 tâches d’ingénierie, où Hy4 preview a obtenu 2.99 sur 4.00, légèrement au-dessus des modèles de comparaison cités par l’entreprise. Ces chiffres doivent être traités comme des éléments rapportés par le fournisseur, et non comme un classement indépendant. La conception des tâches, la population d’évaluateurs et les conditions de comparaison comptent, et la reproductibilité indépendante n’est pas encore établie.
L’allégation d’auto-optimisation est intéressante mais appelle à la retenue
L’une des allégations les plus inhabituelles de Tencent est que Hy4 preview a participé à des parties de son propre développement. L’entreprise dit que le modèle a proposé des approches, mené des expériences et itéré sur des méthodes d’entraînement, des stratégies de données, des cadres d’évaluation et des opérateurs de bas niveau. Tencent affirme aussi que le modèle a analysé des goulets d’inférence et aidé à produire des optimisations de fusion d’opérateurs et de communication qui ont augmenté le débit de bout en bout de 31.8 percent par rapport à sa ligne de base.
Cela peut compter pour les équipes qui construisent des flux de travail automatisés d’ingénierie de modèles ou d’infrastructure d’agents. Cela suggère une boucle dans laquelle le modèle n’est pas seulement la charge de travail à optimiser, mais aussi un participant actif au diagnostic et à la modification du système autour de lui.
Toutefois, les éléments viennent actuellement de Tencent. La publication n’établit pas que le même processus se généralise à d’autres ensembles de modèles, environnements matériels ou équipes d’ingénierie, et l’amélioration de débit rapportée dépend de la ligne de base et des conditions de mise en œuvre de Tencent. Il vaut mieux y voir un cas d’usage interne concret qui mérite reproduction, plutôt qu’une preuve d’auto-amélioration récursive générale.
Ce que les développeurs doivent mesurer ensuite
Pour un usage d’ingénierie logicielle, les questions pratiques importent davantage que les comptes de paramètres en titre. Les équipes doivent mesurer l’achèvement des tâches à l’échelle du dépôt, la fiabilité des outils, la qualité des rustines, la discipline de test, la rétention de contexte et le coût sous leurs propres harnais. Une fenêtre d’un million de jetons peut réduire une partie de la pression de récupération, mais un long contexte ne produit pas automatiquement de meilleures décisions ni un coût total d’inférence plus bas.
Les équipes d’infrastructure doivent aussi essayer le comportement de mise à disposition sous une concurrence réaliste. Un parcours actif de 49 milliards de paramètres reste substantiel, tandis que l’empreinte totale de 770 milliards crée des considérations de stockage, de placement mémoire et d’acheminement d’experts. La quantification et le décodage spéculatif peuvent aider, mais l’économie de production dépendra de la topologie matérielle, de la longueur des requêtes et de l’utilisation.
Tencent recense des tarifs d’API à $0.834 par million de jetons d’entrée, $2.501 par million de jetons de sortie et $0.042 par million de jetons mis en cache. Ces prix hébergés offrent une ligne de base utile pour comparer l’auto-hébergement à l’accès géré, même s’ils n’indiquent pas à eux seuls le coût total d’application pour des agents de longue durée.
Hy4 preview est donc notable parce qu’il combine trois choses souvent séparées : un très grand modèle ouvert, un ensemble d’installation opérable par le développeur, et un accent clair sur la production d’artefacts de travail réels. Les allégations de performance exigent encore une validation extérieure, et le produit est explicitement une préversion. Mais pour les équipes qui évaluent des modèles ouverts pour le code et les systèmes d’agents à long contexte, la publication est assez concrète pour être essayée maintenant, plutôt que seulement observée.