
بیشتر سازمانهای مهندسی برای تغییر کد، فرایند مدیریت تغییر نسبتاً بالغی دارند.
برای عاملهای هوش مصنوعی، معمولاً چنین چیزی وجود ندارد.
مدل ارتقا پیدا میکند. پرامپت تنظیم میشود. یک Skill ابزار تازهای میگیرد. میزبان IDE یا runtime رفتار پیشفرض را تغییر میدهد. بسیاری از این تغییرها نه وارد registry میشوند، نه canary دارند، نه برنامه ارتباطی، نه مسیر rollback و گاهی حتی در changelog هم ثبت نمیشوند.
بعد رفتار تولید تغییر میکند و تیم با آن مثل آبوهوا برخورد میکند.
اما این آبوهوا نیست. یک deploy است.
وقتی قابلیتهای عامل تغییر میکنند، هر workflowای که به آن عامل وابسته است عملاً دوباره deploy شده است. تیم شاید آن تغییر را ایجاد نکرده باشد، اما پیامدهایش را باید اداره کند.
ارتقای ثبتنشده یک عامل، در عمل یک deploy خاموش روی تمام workflowهایی است که از آن استفاده میکنند.
این مقاله بخش هشتم از مجموعه دهقسمتی حاکمیت هوش مصنوعی در یک شرکت نرمافزاری AI-Native است. بخش هفتم، Traceability: Who (or What) Wrote This Line of Code?، زنجیره ممیزی را قابل بازسازی کرد. این بخش درباره جلوگیری از نسل بعدی یافتههای ممیزی است: تغییر قابلیتهایی که سامانه اصلاً متوجه deploy شدنشان نشده است.
⚠️ سهشنبهای که هیچکس چیزی deploy نکرد
فرض کنید تیمی عاملی دارد که تیکتهای پشتیبانی را دستهبندی میکند، پاسخ اولیه مینویسد و خلاصه ساختاریافتهای برای مهندس on-call ثبت میکند. ماههاست درست کار میکند.
آخر هفته، مدل پشت endpoint پیشفرض ارتقا پیدا میکند. رشته نسخهای که تیم میبیند تغییر نمیکند. کسی هم خبر نمیدهد، چون از نگاه ارائهدهنده هیچ deploy مستقیمی از سمت مشتری رخ نداده است.
تا چهارشنبه صف on-call عقب میافتد. خلاصهها طولانیتر و محافظهکارانهتر شدهاند و فیلد severity که router پاییندستی به آن وابسته بود حذف شده است. تیکتهایی که قبلاً خودکار escalate میشدند، متوقف میمانند.
بررسی دو روز طول میکشد. logها سالماند، latency ثابت است، error rate تغییری نکرده و داشبوردهای کد سبزند، چون کدی عوض نشده است. سرانجام کسی خروجیهای جدید را با ماه قبل مقایسه میکند و شکل تازه را میبیند: مدل تغییر کرده، رفتار تغییر کرده و قراردادی که router به آن وابسته بود تغییر کرده است، اما هیچیک در سطحی که انسانها برای deploy بررسی میکنند دیده نشدهاند.
نه deploy record وجود دارد، نه changelog، نه canary و نه rollback plan.
این همان capability drift است و مشکلش تصادفی نیست؛ ساختاری است.
🌫️ مسئله Capability Drift
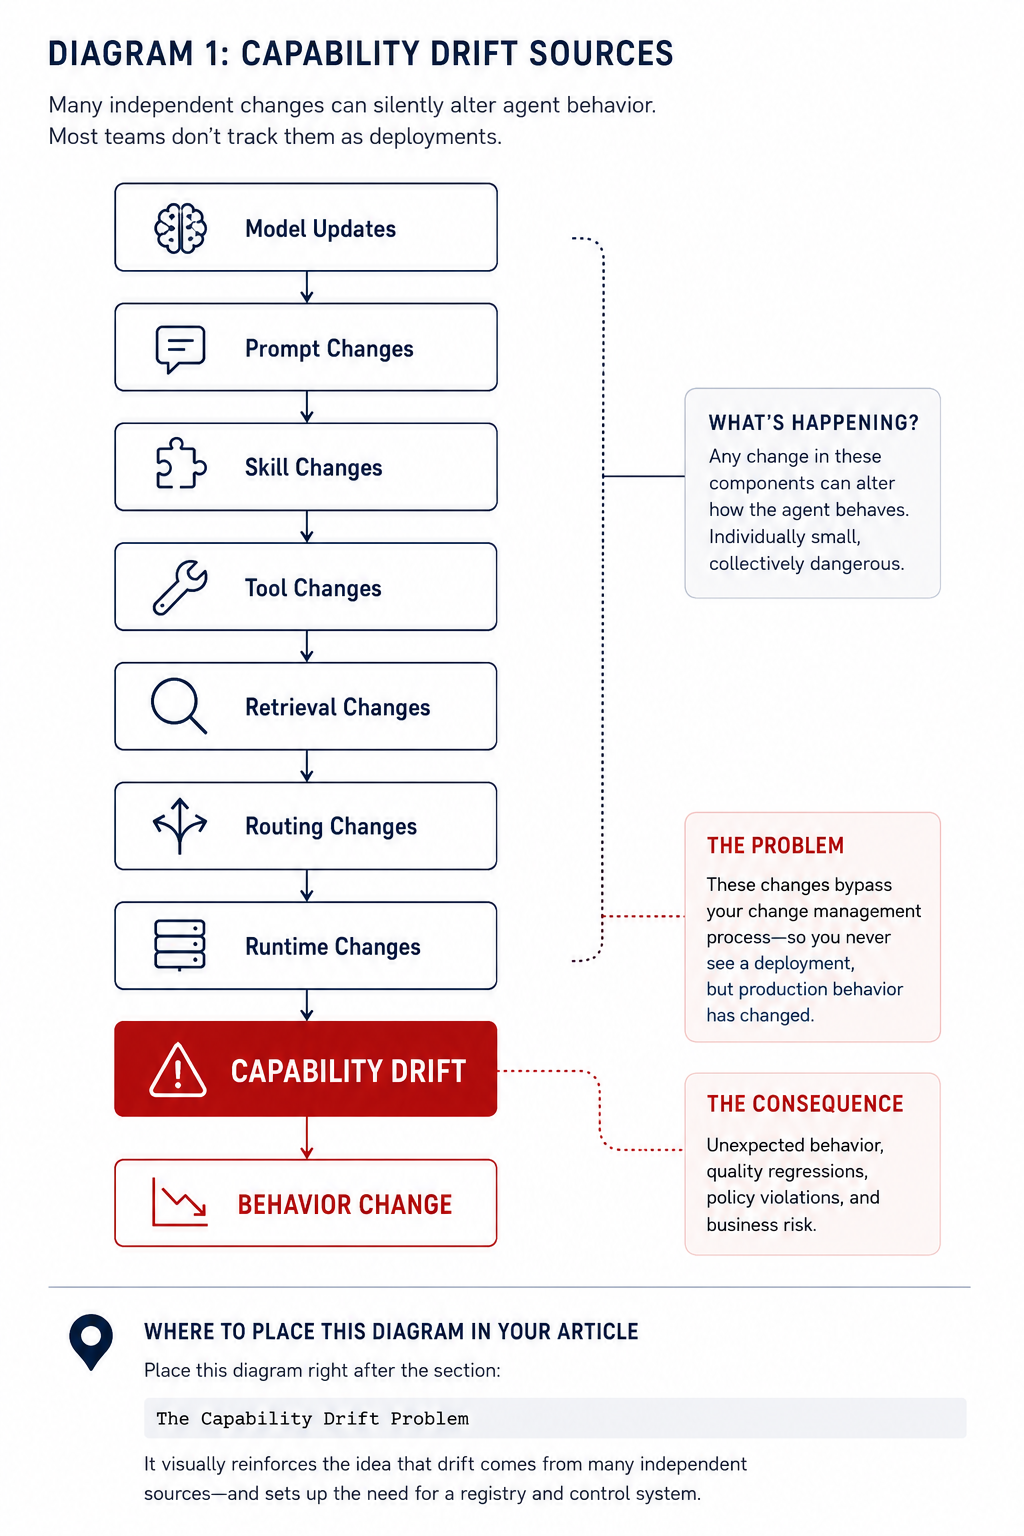
Capability drift یعنی تغییر در اینکه عامل چه کاری میتواند انجام دهد، چقدر خوب انجام میدهد یا چگونه رفتار میکند، بدون اینکه تغییر متناظری در سطح change management سازمان ثبت شود.
منابع آن متعددند:
- ارتقای مدل توسط ارائهدهنده: مدل پشت نام یا endpoint ثابت تغییر میکند.
- ویرایش پرامپت: یک اصلاح کوچک برای یک edge case، رفتار موارد دیگر را هم جابهجا میکند.
- تغییر Skill: یک ابزار، شاخه تصمیم یا refusal جدید اضافه میشود.
- تغییر schema ابزار: پارامترهای تازه یا تغییریافته رفتار callerها را عوض میکنند.
- بهروزرسانی retrieval corpus: همان درخواست با context تازه پاسخ دیگری میسازد.
- تغییر routing: router برای همان نوع کار مدل دیگری را انتخاب میکند.
- تغییر host/runtime: میزبان عامل یا IDE پیشفرضی را تغییر میدهد که همه workflowهای پاییندستی به ارث میبرند.
مسئله این نیست که تغییر رخ میدهد. مسئله این است که تغییر بیرون از change pipeline رخ میدهد.
در کد ممکن است هشت gate و برنامه ارتباطی داشته باشیم، اما برای model swap هیچکدام وجود نداشته باشد.
اگر رفتار عوض شده، چیزی deploy شده است. سؤال فقط این است که آیا سازمان آن deploy را دیده یا نه.
📚 Registry، Pin، Promote
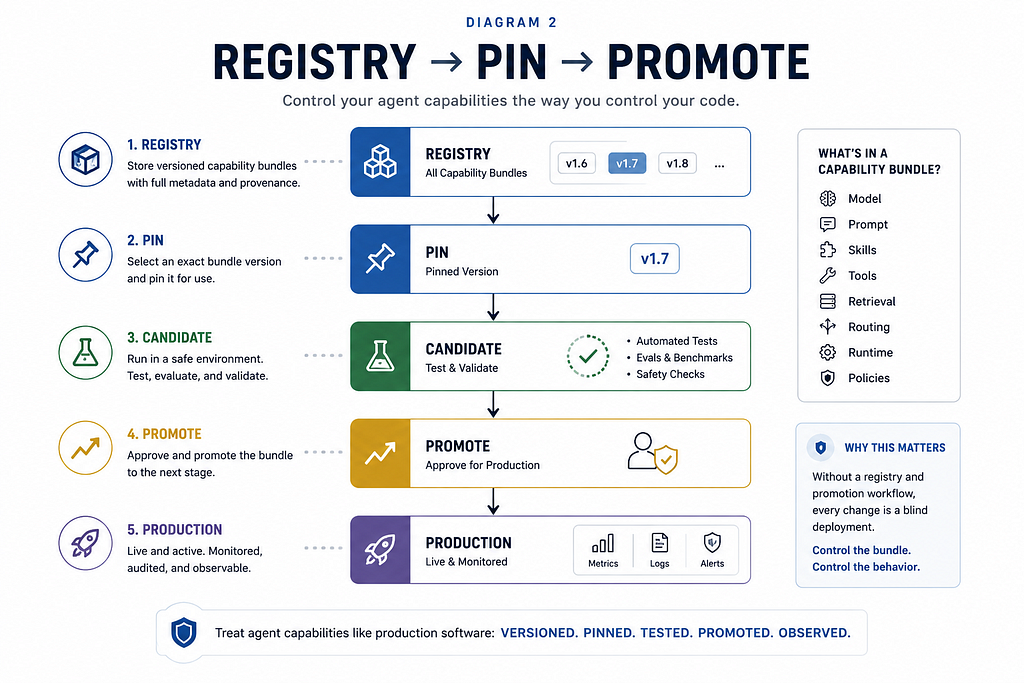
پربازدهترین ابزار مدیریت تغییر قابلیت عامل چیز پرزرقوبرقی نیست: registryای از آنچه واقعاً اکنون live است.
نه چیزی که جلسه تصویب کرده، نه چیزی که wiki نوشته است؛ چیزی که runtime همین لحظه load میکند.
برای هر عامل deployed بهتر است این موارد ثبت شوند:
- مدل و version pin؛
- نسخه و hash پرامپت؛
- Skillهای فعال و نسخه آنها؛
- Ruleهای فعال و نسخه آنها؛
- tool manifest و signature؛
- digest مربوط به policy bundle؛
- نسخه host runtime؛
- آخرین رویداد ارتقا و provenance آن؛
- owner.
این فهرست فقط inventory نیست. مجموع این اجزا تعریف قابلیت deployed است.
از اینجا دو کار ممکن میشود.
Pin: هر عامل live مجموعهای صریح از نسخهها دارد. هر جا pin ممکن باشد، تغییر نباید از طریق drift محیطی وارد production شود.
Promote: جابهجایی pin یک deploy است. candidate دارد، verification دارد، staged rollout دارد، verdict دارد و rollback path دارد.
انضباط همان release management نرمافزار است؛ فقط artifact فرق کرده است.
اگر نمیتوانید بگویید عاملها امروز دقیقاً چه چیزی اجرا میکنند، فردا هم نمیتوانید تغییرشان را مدیریت کنید.
📦 عامل بهصورت Capability Bundle deploy میشود
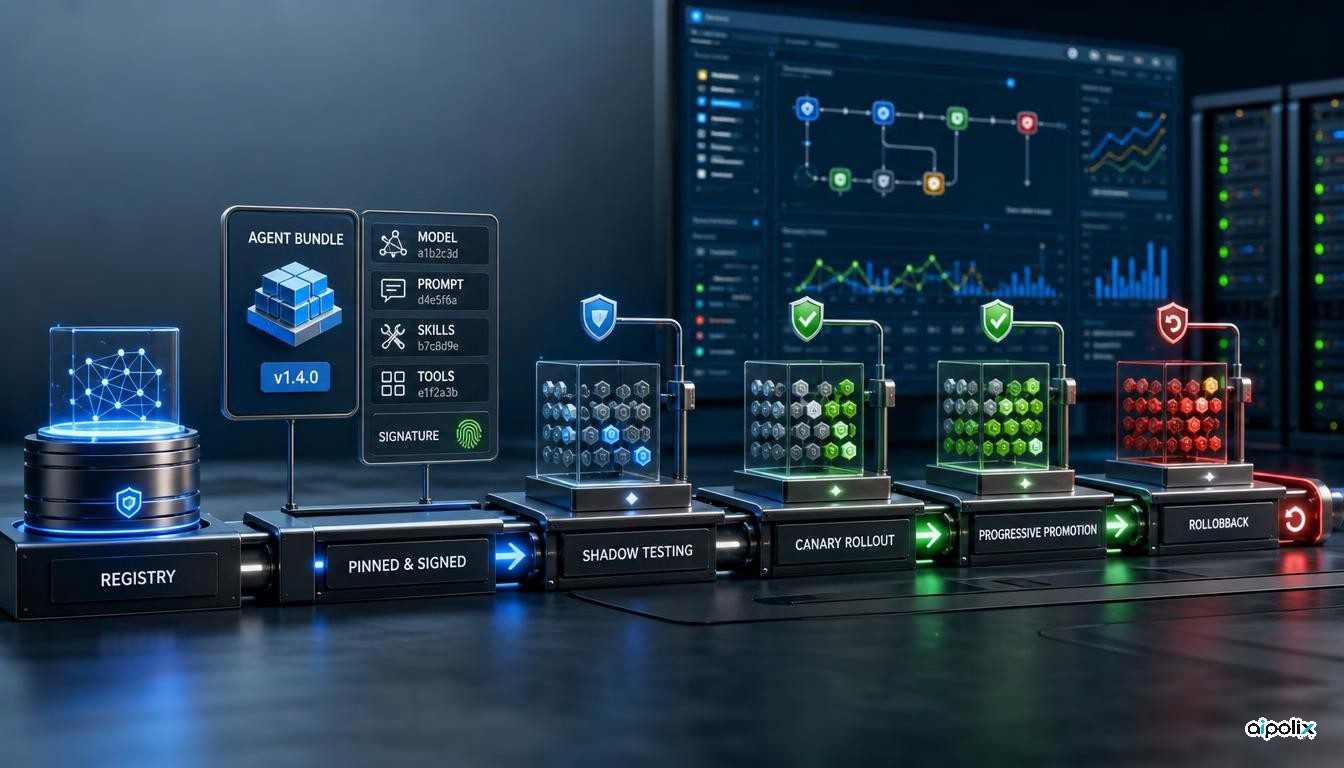
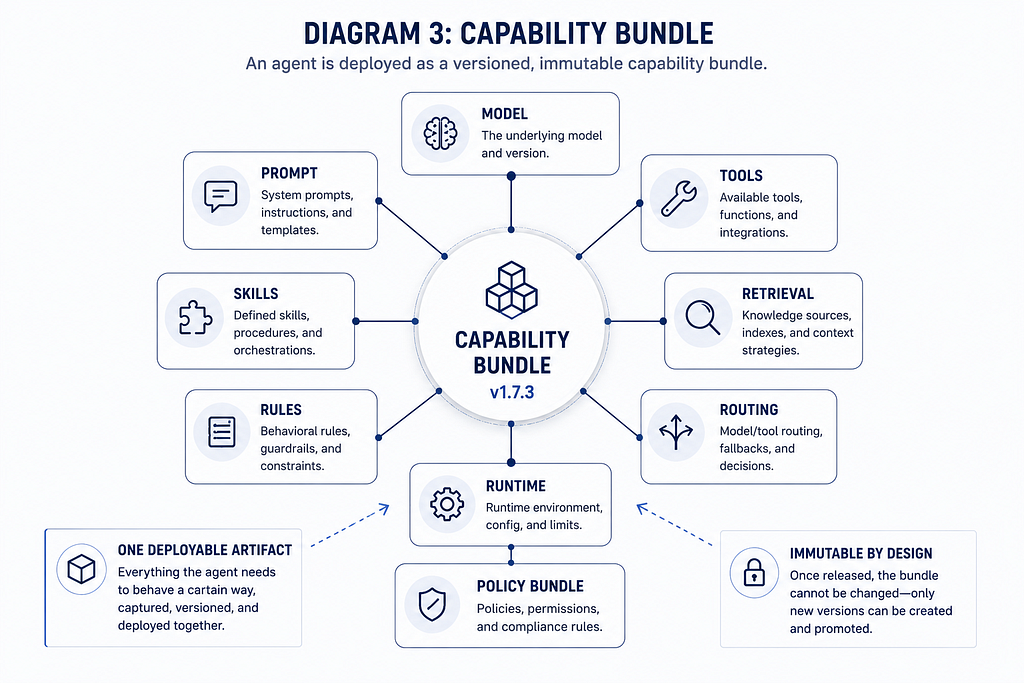
برای سرویسها معمولاً یک binary را deploy میکنیم. عامل بهتر است بهصورت یک capability bundle دیده شود که هنگام اجرا از چند جزء ساخته میشود:
- مدل و نسخه؛
- پرامپت و hash؛
- Skillها و نسخهها؛
- Ruleهای فعال؛
- ابزارهای موجود در manifest؛
- policy bundle؛
- runtime میزبان.
هر جزء ممکن است owner و release path متفاوتی داشته باشد. همین پراکندگی باعث میشود تغییر عامل مبهم به نظر برسد.
Capability bundle همان artifact مشترک است.
هر تغییر در یکی از اجزا باید نسخه bundle را جابهجا کند: model swap، اصلاح یکخطی پرامپت، اضافه شدن ابزار به Skill، تغییر policy bundle یا runtime.
این مدل اجازه نمیدهد تغییر رفتار پشت یک label ثابت پنهان شود.
🐤 Staged Rollout برای قابلیت عامل
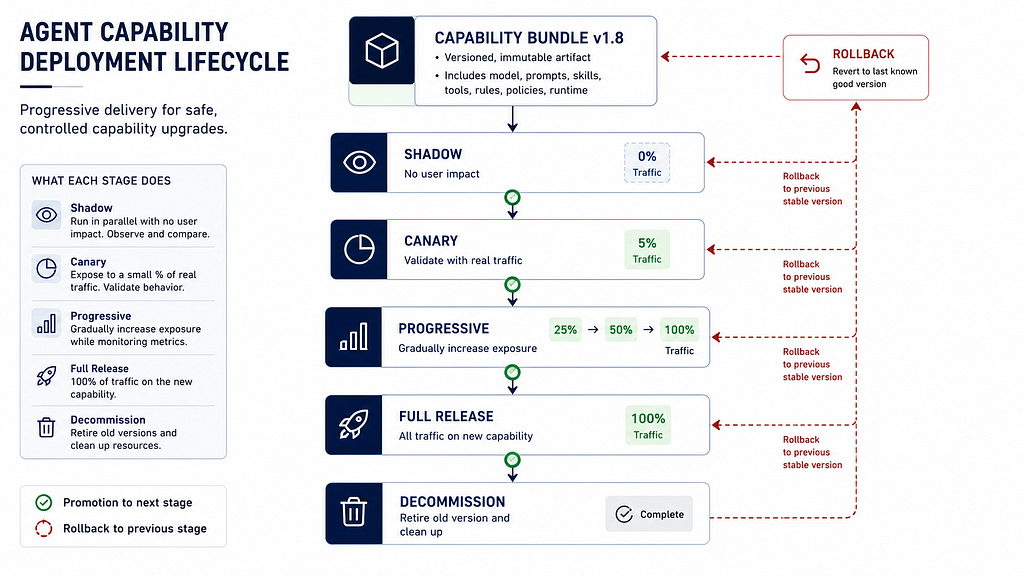
ارتقای قابلیت نباید تصمیم دوحالتی «ship یا نه» باشد. باید مانند کد پرریسک روی یک منحنی rollout حرکت کند.
- Shadow: نسخه جدید روی همان ورودیها اجرا میشود اما خروجیاش side effect ایجاد نمیکند.
- Canary: بخش کوچکی از traffic، کاربران یا workflowها واقعاً نسخه جدید را استفاده میکنند.
- Progressive: سهم استفاده مرحلهبهمرحله افزایش مییابد و هر مرحله gate صریح دارد.
- Full: bundle جدید پیشفرض میشود و نسخه قبلی برای مدتی قابل برگشت باقی میماند.
- Decommission: نسخه قبلی پس از soak period و اطلاعرسانی حذف میشود.
اما سیگنالهای rollout عامل با کد یکی نیستند. latency و error rate کافی نیست.
سیگنالهای مهم شامل refusal rate، escalation rate، توزیع tool callها، انطباق ساختار خروجی با skill contract، نرخ تولید evidence، توزیع blast radius و supervisor override هستند.
اگر اینها پیش از ارتقا روی داشبورد باشند، drift در canary دیده میشود. اگر بعد از incident اضافه شوند، فقط ماده خام postmortem خواهند بود.
📣 لایه ارتباطی
تغییر قابلیت عامل مسئله ارتباطی ویژهای دارد.
مصرفکنندگان یک سرویس معمولاً شناختهشدهاند، اما تغییر یک عامل ممکن است روی مهندسی، محصول، پشتیبانی و عملیات اثر بگذارد. بسیاری از این افراد هیچ changelog فنی را دنبال نمیکنند.
یک روال مناسب شامل این موارد است:
- Release note برای رفتار: نه فقط «مدل را ارتقا دادیم»، بلکه توضیح اینکه چه رفتاری ممکن است فرق کند.
- Behavioral diff قابل فهم: نمونههای مشخص before/after.
- Migration note برای مصرفکنندگان پاییندستی: اگر workflow یا Skill به شکل خروجی وابسته است، owner آن باید زودتر مطلع شود.
- انتظار rollback: مشخص باشد چه سیگنالی rollback را فعال میکند و پنجره تصمیم چقدر است.
هدف bureaucracy نیست. هدف این است که capability change یک رویداد شناختهشده باشد.
↩️ Rollback برای عاملها
یک آزمون ساده: آخرین ارتقای یک عامل deployed را انتخاب کنید. آیا تیم میتواند همین امروز، در کمتر از یک ساعت و با اطمینان، آن را rollback کند؟
در بسیاری از تیمها پاسخ منفی است. pin قبلی شاید دیگر وجود نداشته باشد، prompt قبلی روی همان فایل overwrite شده باشد، provider مدل قبلی را deprecated کرده باشد یا خروجیهای تولیدشده به رفتار جدید وابسته شده باشند.
انضباط rollback باید آینه ارتقا باشد:
- bundle قبلی برای یک بازه مشخص حفظ شود؛
- rollback واقعاً تمرین شود؛
- rollback همان کیفیت evidence مسیر forward را تولید کند؛
- مصرفکنندگان پاییندستی بدانند بعد از rollback چه انتظاری داشته باشند.
در عاملها یک مفهوم مهم دیگر هم داریم: soft rollback.
گاهی قابلیت جدید حفظ میشود اما یک رفتار مشخص از طریق policy یا contract محدود میشود. Article 4، The Executable Policy Layer این امکان را فراهم میکند: بدون repin کردن مدل، میتوان بخشی از رفتار جدید را محدود کرد.
🧪 وضعیت خوب چه شکلی است؟
مدیریت تغییر واقعی قابل تشخیص است.
وقتی درست کار میکند:
- هر عامل pin فعلی و قابل کشف دارد؛
- هر capability change دارای candidate، stage، verdict و rollback path است؛
- سیگنالهای رفتاری قبل از upgrade روی داشبورد هستند؛
- کسانی که workflowشان وابسته است از تغییر رفتار مطلع میشوند؛
- hard rollback و soft rollback خارج از incident تمرین میشوند؛
- «مدل عوض شد» یک event در سیستم است، نه شایعه در تیم.
وقتی این انضباط وجود ندارد، کسی مدل فعال، prompt hash یا Skill version را نمیداند؛ اولین علامت مشکل شکایت مشتری است؛ rollback یک گفتوگوست نه مسیر اجرایی؛ و capability change فقط در timeline incident ظاهر میشود، نه در change log.
در همین نقطه provenance بخش هفتم هم میشکند: تغییری که بهعنوان تغییر ثبت نشده، قابل بازسازی نیست.
🚨 Failure Modeهای تغییر محیطی
الگوها تکراریاند.
Provider drift: مدل پشت یک نام ثابت تغییر میکند و رفتار جابهجا میشود.
Prompt-by-Slack: پرامپتی برای یک edge case تنظیم میشود اما رفتار همه کاربران را تغییر میدهد.
Skill creep: یک Skill ابزار تازهای میگیرد و blast radius آن از محدوده تأییدشده فراتر میرود.
Routing surprise: router برای کاهش هزینه مدل ارزانتری را انتخاب میکند، کیفیت افت میکند و تغییر هرگز بهعنوان deploy ثبت نشده است.
Rollback fantasy: تیم فرض میکند rollback ممکن است اما هرگز آن را امتحان نکرده است.
زیر همه این موارد یک الگو وجود دارد:
قابلیت عامل تغییر کرده است.
pipeline متوجه نشده است.
🛠️ ترتیب عملی ساخت
مدیریت تغییر قابلیت از پربازدهترین لایههای governance است.
- Registry را بسازید. برای هر عامل مدل، پرامپت، Skill، Rule، ابزار، policy bundle، host و owner را ثبت کنید.
- هرجا میشود pin کنید. latest و default را به نسخه صریح تبدیل کنید.
- Capability bundle را artifact نسخهدار تعریف کنید. تغییر هر جزء، نسخه bundle را تغییر دهد.
- Shadow و Canary را برای bundleها اجرا کنید. از discipline موجود progressive delivery استفاده کنید.
- سیگنالهای رفتار را روی داشبورد بگذارید. refusal، escalation، tool call، evidence، blast radius و override.
- Rollback را بسازید و تمرین کنید. hard rollback برای bundle و soft rollback از طریق policy و contract.
- یک سطح ارتباطی ثابت ایجاد کنید. release note رفتار، diff قابل فهم و migration note.
- تغییر محیطی را قابل تشخیص کنید. provider را probe کنید، هرجا ممکن است pin کنید و drift تأییدنشده را محدود کنید.
اینها مفهوم تازهای نیستند. release management، progressive delivery و SRE هستند که روی artifact تازهای اعمال میشوند.
🎯 جمعبندی
اشتباه این است که capability عامل را مثل آبوهوای بیرونی ببینیم.
آبوهوا نیست. یک deploy است.
هر تغییر پرامپت، model swap، Skill update، ابزار جدید، policy change یا runtime change میتواند رفتار production را در چند workflow جابهجا کند.
اگر همه playbook را به سه جمله کاهش دهیم:
تغییر قابلیتها deploy هستند. Deploy به governance نیاز دارد. Governance به visibility نیاز دارد.
زنجیره همانجایی میشکند که تغییر رخ میدهد اما سیستم آن را بهعنوان تغییر ثبت نمیکند.
پس خواسته عملی ساده است: هر capability change باید بهعنوان change دیده شود. Bundle را pin و version کنید، سپس همان ابزارهای release management را که تیم پلتفرم از قبل میشناسد روی آن اعمال کنید.
اگر رفتار عاملها تغییر کرد اما change log شما تغییر نکرد، شما عاملها را در production اداره نمیکنید؛ فقط میزبانیشان میکنید و امیدوارید همهچیز خوب بماند.
مقاله بعدی: Cost, Token, and Capability Budgets: The New FinOps for Agents.
این مقاله در ژوئن ۲۰۲۶ توسط Reza Arani در Medium منتشر شده و برای Aipolix بهعنوان بخش هشتم مجموعه AI Governance in an AI-Native Software Development Company اقتباس شده است.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. اولین نفر باشید.
ثبت دیدگاه