
La plupart des organisations d'ingénierie disposent d'une discipline mûre de gestion du changement pour le code.
Elles en ont beaucoup moins pour les agents.
Un modèle est mis à niveau. Un prompt est retouché. Une Skill reçoit un nouvel outil. Un hôte IDE ou un runtime change un comportement par défaut. Beaucoup de ces changements ne passent ni par un registre, ni par un canary, ni par un plan de communication, ni par un chemin de rollback. Certains n'apparaissent même pas dans un changelog.
Puis le comportement en production bouge, et l'équipe traite cela comme la météo.
Ce n'est pas la météo. C'est un déploiement.
Quand les capacités d'un agent changent, chaque workflow qui l'utilise est, de fait, redéployé. L'équipe n'a peut-être pas créé le changement, mais elle devra en exploiter les conséquences.
Une mise à niveau d'agent non suivie est un déploiement silencieux sur chaque workflow qui dépend de lui.
Cet article est le huitième volet de la série en dix parties AI Governance in an AI-Native Software Development Company. La partie 7, Traceability: Who (or What) Wrote This Line of Code?, a rendu la chaîne d'audit reconstructible. Cette partie traite de la classe suivante de problèmes : le capability drift que le système n'a jamais vu arriver.
⚠️ Un mardi où personne n'a déployé
Imaginez une équipe utilisant un agent qui trie les tickets de support, prépare une réponse et produit un résumé structuré pour l'ingénieur d'astreinte. Le système fonctionne depuis des mois.
Pendant le week-end, le modèle derrière l'endpoint par défaut est mis à niveau. La chaîne de version visible par l'équipe ne change pas. Personne n'est prévenu parce que, du point de vue du fournisseur, le client n'a rien déployé.
Le mercredi, la file d'astreinte s'allonge. Les résumés sont plus longs, plus prudents, et le champ severity utilisé par le routeur aval a disparu. Des tickets auparavant escaladés automatiquement restent en attente.
L'enquête prend deux jours. Les logs sont propres, la latence est stable et le taux d'erreur aussi. Tous les tableaux de bord conçus pour le code sont au vert, parce que le code n'a pas bougé. Quelqu'un compare finalement les résumés récents avec ceux du mois précédent et découvre la nouvelle forme. Le modèle a changé. Le comportement a changé. Le contrat implicite du routeur a changé. Rien n'est apparu dans les surfaces habituelles de déploiement.
Pas de deploy record. Pas de changelog. Pas de canary. Pas de plan de rollback.
C'est le capability drift.
🌫️ Le problème du Capability Drift
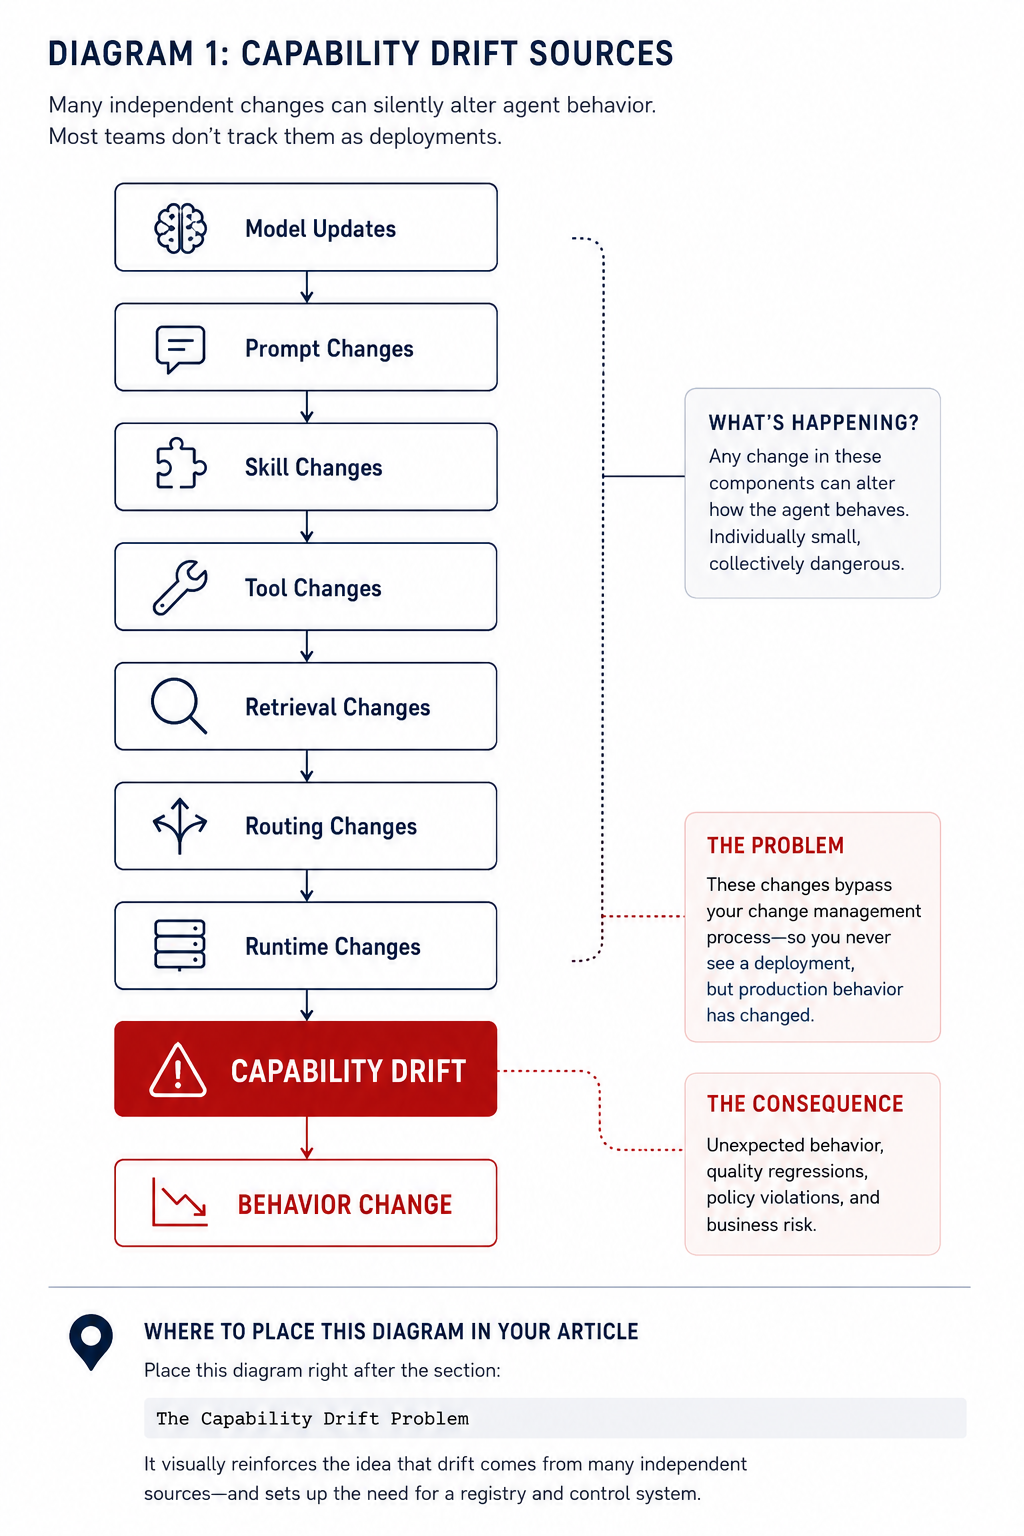
Le capability drift est la modification de ce qu'un agent peut faire, de la qualité avec laquelle il le fait ou de la manière dont il se comporte, sans changement correspondant dans la surface de change management.
Les sources sont nombreuses :
- mises à niveau du modèle chez le fournisseur ;
- modification d'un prompt ;
- évolution d'une Skill ;
- changement de schéma d'un outil ;
- mise à jour du corpus de retrieval ;
- modification du routing ;
- changement du runtime ou de l'hôte.
Chacun peut modifier le comportement. Ensemble, ils le font en continu.
Le problème n'est pas le changement. Le problème est le changement hors de la chaîne de changement.
Un changement de code peut avoir huit gates et un plan de communication. Un model swap peut n'en avoir aucun.
Si le comportement a changé, quelque chose a été déployé. La seule question est de savoir si l'organisation l'a vu.
📚 Registry, Pin, Promote
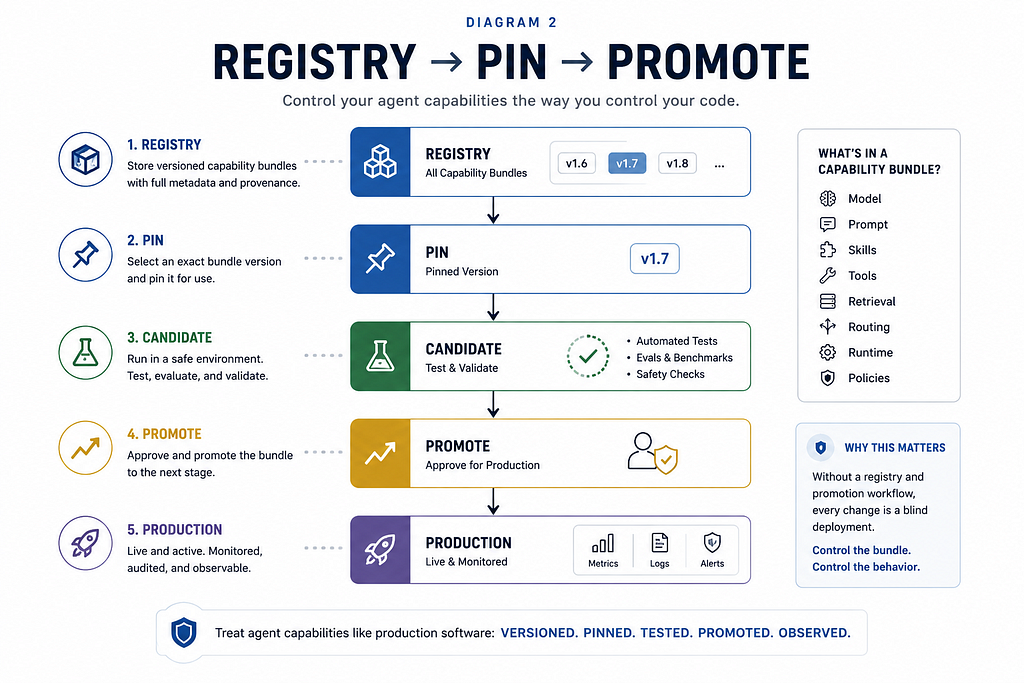
Le levier le plus utile est simple : un registre de ce qui est réellement live.
Pas ce qu'une réunion a approuvé. Pas ce qu'un wiki affirme. Ce que le runtime charge maintenant.
Pour chaque agent déployé, le registre devrait contenir :
- modèle et version pin ;
- version et hash du prompt ;
- Skills actives et versions ;
- Rules actives et versions ;
- tool manifest et signature ;
- digest du policy bundle ;
- version du host runtime ;
- dernier événement de mise à niveau et sa provenance ;
- owner.
Cet ensemble définit la capacité déployée.
Pin. Chaque agent live utilise des versions explicites. Quand le pin est possible, l'ambient drift ne doit pas devenir un changement de production invisible.
Promote. Déplacer un pin est un déploiement avec candidate, vérification, rollout progressif, verdict et rollback.
La discipline est celle du release management ; l'artifact est différent.
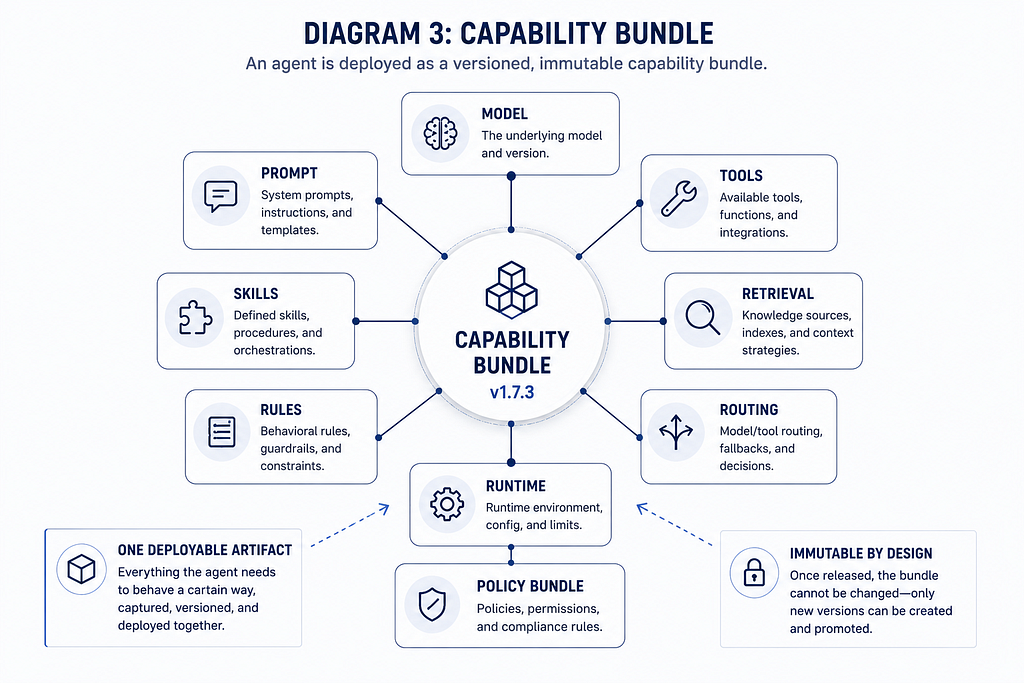
📦 L'agent comme Capability Bundle
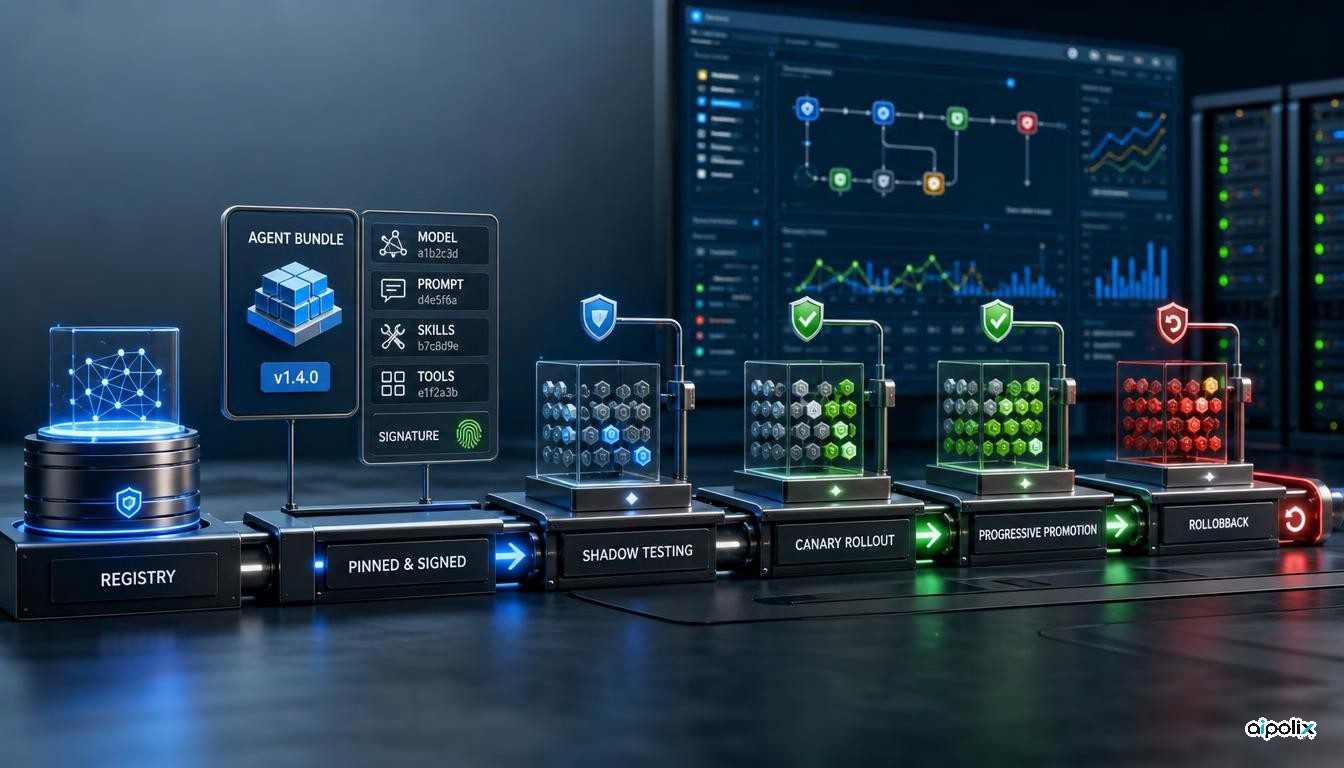
Un service est souvent déployé sous forme de binaire. Un agent doit plutôt être vu comme un capability bundle composé au runtime :
- modèle et version ;
- prompt et hash ;
- Skills et versions ;
- Rules en vigueur ;
- outils du manifest ;
- policy bundle ;
- runtime hôte.
Chaque composant peut avoir un owner et une chaîne de release différents. C'est précisément ce qui rend le changement difficile à voir comme un seul événement.
Le capability bundle devient l'artifact commun. Si l'un de ses composants change, la version du bundle change.
Un model swap, une correction d'une ligne dans le prompt, une Skill qui gagne un outil ou un nouveau policy bundle sont tous des changements du même artifact opérationnel.
Si vous ne pouvez pas nommer l'artifact qui a changé, vous ne pouvez pas gouverner le changement.
🐤 Staged Rollout des capacités
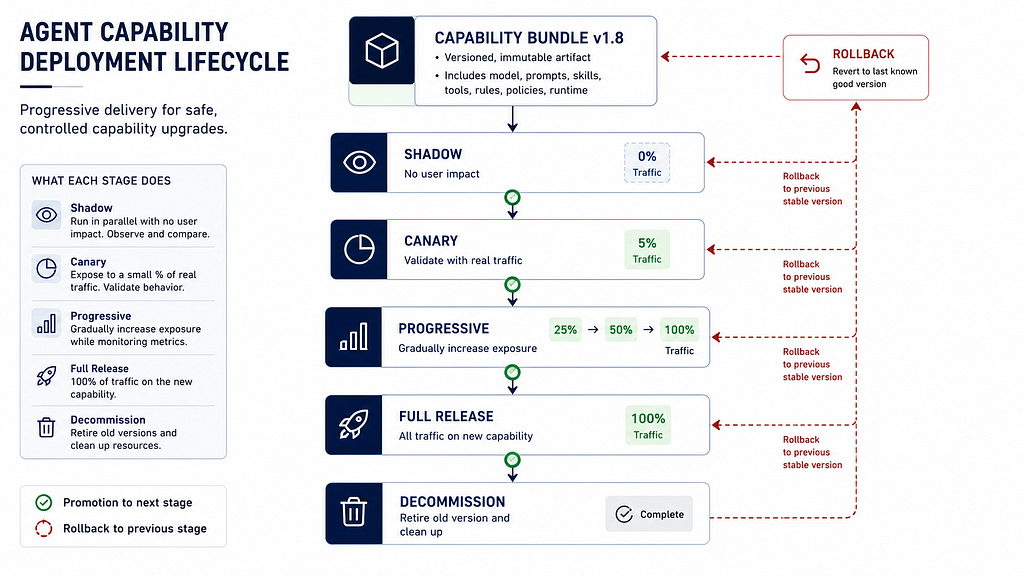
Une mise à niveau de capacité ne devrait pas être un choix binaire.
- Shadow : la candidate s'exécute sur les mêmes entrées sans produire d'effets réels.
- Canary : une petite part du trafic ou des workflows utilise la nouvelle capacité.
- Progressive : la part augmente avec des gates go/no-go explicites.
- Full : le bundle devient le défaut, avec une fenêtre de réversibilité.
- Decommission : l'ancien bundle est supprimé après une période d'observation.
Les signaux ne peuvent pas se limiter à la latence et au taux d'erreur.
Il faut aussi suivre le taux de refus, les escalades, la distribution des tool calls, la conformité de structure aux skill contracts, le taux d'émission d'evidence, la distribution du blast radius et le taux d'override humain.
Ces signaux doivent exister avant la mise à niveau, pas après l'incident.
📣 La couche de communication
Un changement de capacité d'agent peut toucher un groupe beaucoup plus large que les consommateurs connus d'un service.
Une pratique utile comprend :
- des release notes orientées comportement ;
- des behavioral diffs compréhensibles ;
- des notes de migration pour les consommateurs aval ;
- des attentes de rollback explicites.
Le but n'est pas la bureaucratie. Il s'agit de rendre le changement connu plutôt qu'ambiant.
↩️ Rollback des agents
Prenez la dernière mise à niveau d'un agent en production. L'équipe peut-elle revenir en arrière aujourd'hui, en moins d'une heure et avec confiance ?
Souvent, non.
Le pin précédent n'existe plus, le prompt a été écrasé, le fournisseur a retiré l'ancien modèle ou de nouveaux artifacts dépendent déjà du comportement mis à jour.
La discipline de rollback doit refléter celle de l'upgrade :
- conserver le bundle précédent pendant une fenêtre définie ;
- tester réellement le chemin de rollback ;
- produire le même niveau d'evidence que pour la promotion ;
- prévenir les consommateurs aval.
Les agents introduisent aussi le soft rollback : conserver la nouvelle capacité tout en restreignant un comportement par policy ou contract. Article 4, The Executable Policy Layer fournit cette couche d'exécution.
🧪 À quoi ressemble une bonne discipline
Elle fonctionne lorsque chaque agent dispose d'un capability pin courant et découvrable, que chaque changement possède candidate, stage, verdict et rollback path, que les signaux comportementaux existent avant l'upgrade et que les hard et soft rollbacks sont testés hors incident.
Elle manque lorsque personne ne peut citer le modèle actif, le prompt hash ou la version de Skill, lorsque la première alerte est une plainte client et lorsque les changements n'apparaissent que dans les timelines d'incident.
C'est également là que la provenance de la partie 7 se casse : un changement qui n'est pas enregistré comme tel ne peut pas être reconstruit.
🚨 Failure Modes du changement ambiant
Provider drift. Le modèle derrière un nom stable change silencieusement.
Prompt-by-Slack. Un prompt ajusté pour un cas particulier modifie le comportement de tous.
Skill creep. Une Skill reçoit un outil et dépasse le blast radius approuvé.
Routing surprise. Un routeur préfère soudain un modèle moins cher ; le coût baisse et la qualité aussi.
Rollback fantasy. L'équipe pense pouvoir revenir en arrière mais n'a jamais testé le chemin.
Le motif est toujours le même : les capacités de l'agent ont bougé, la pipeline ne l'a pas vu.
🛠️ Ordre de mise en œuvre
- Construire le registre. Modèle, prompt, Skills, Rules, outils, policy bundle, host et owner pour chaque agent.
- Pinner tout ce qui peut l'être. Remplacer latest et default par des versions explicites.
- Définir le capability bundle comme artifact versionné.
- Mettre en place Shadow et Canary pour les bundles.
- Afficher les signaux comportementaux avant l'upgrade.
- Construire et répéter les rollbacks hard et soft.
- Créer une surface de communication stable.
- Détecter les changements ambiants du fournisseur et du runtime.
Ce n'est pas une nouvelle discipline. C'est du release management, du progressive delivery et de la pratique SRE appliqués à un nouvel artifact.
🎯 Conclusion
La capacité d'un agent n'est pas une météo extérieure.
C'est un déploiement.
Chaque réglage de prompt, model swap, Skill update, ajout d'outil, modification de policy ou changement de runtime peut déplacer le comportement de production dans plusieurs workflows.
Le playbook tient en trois phrases :
Les changements de capacité sont des déploiements. Les déploiements exigent de la gouvernance. La gouvernance exige de la visibilité.
Le système échoue lorsqu'un changement a lieu sans être enregistré comme tel.
Si le comportement de vos agents a changé mais pas votre change log, vous n'exploitez pas des agents en production. Vous les hébergez en espérant que tout ira bien.
Prochain article : Cost, Token, and Capability Budgets: The New FinOps for Agents.
Publié initialement par Reza Arani sur Medium en juin 2026. Adapté pour Aipolix comme huitième partie de la série AI Governance in an AI-Native Software Development Company.
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter.
Laisser un commentaire