
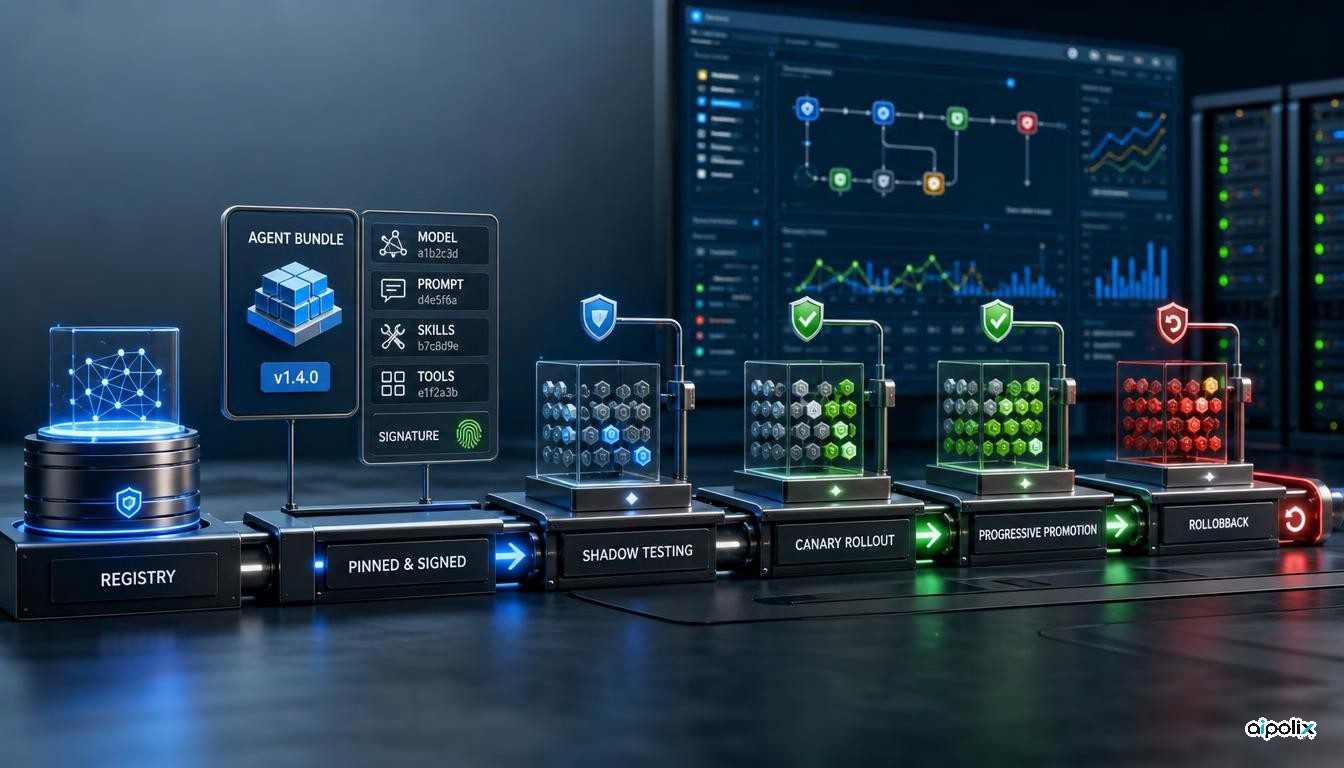
A maioria das organizações de engenharia tem uma disciplina madura de gestão de mudanças para código.
Para agentes, quase sempre tem muito menos.
Um modelo é atualizado. Um prompt é ajustado. Uma Skill ganha uma nova ferramenta. O IDE ou o runtime altera um comportamento por defeito. Muitas destas mudanças não passam por um registo, um canary, um plano de comunicação ou um caminho de rollback. Algumas nem sequer chegam ao changelog.
Depois o comportamento em produção muda e a equipa trata o fenómeno como se fosse meteorologia.
Não é meteorologia. É um deploy.
Quando as capacidades de um agente mudam, todos os workflows que dependem dele foram, na prática, novamente colocados em produção. A equipa pode não ter criado a mudança, mas terá de operar as suas consequências.
Uma atualização de agente não registada é um deploy silencioso em todos os workflows que dependem dele.
Este é o oitavo artigo da série de dez partes AI Governance in an AI-Native Software Development Company. A Parte 7, Traceability: Who (or What) Wrote This Line of Code?, tornou a cadeia de auditoria reconstruível. Este artigo trata do problema seguinte: capability drift que o sistema nunca registou como uma mudança em produção.
⚠️ Uma terça-feira em que ninguém fez deploy
Imagine uma equipa com um agente que faz triagem de tickets de suporte, prepara uma resposta e produz um resumo estruturado para o engenheiro de prevenção. Funciona há meses.
Durante o fim de semana, o modelo por trás do endpoint predefinido é atualizado. A versão visível para a equipa não muda. Ninguém é avisado porque, do ponto de vista do fornecedor, o cliente não fez qualquer deploy explícito.
Na quarta-feira a fila de prevenção começa a acumular. Os resumos ficaram mais longos e mais suaves, e o campo severity de que o router dependia desapareceu. Tickets que antes eram escalados automaticamente ficam parados.
A investigação demora dois dias. Os logs parecem normais, a latência está estável e a taxa de erro também. Todos os dashboards desenhados para código estão verdes, porque o código não mudou. Só quando alguém compara os resumos recentes com os do mês anterior percebe a nova forma.
O modelo mudou. O comportamento mudou. O contrato de que o router dependia mudou. Nada disso apareceu onde a equipa costuma procurar um deploy.
Sem deploy record. Sem changelog. Sem canary. Sem rollback plan.
Isto é capability drift.
🌫️ O problema do Capability Drift
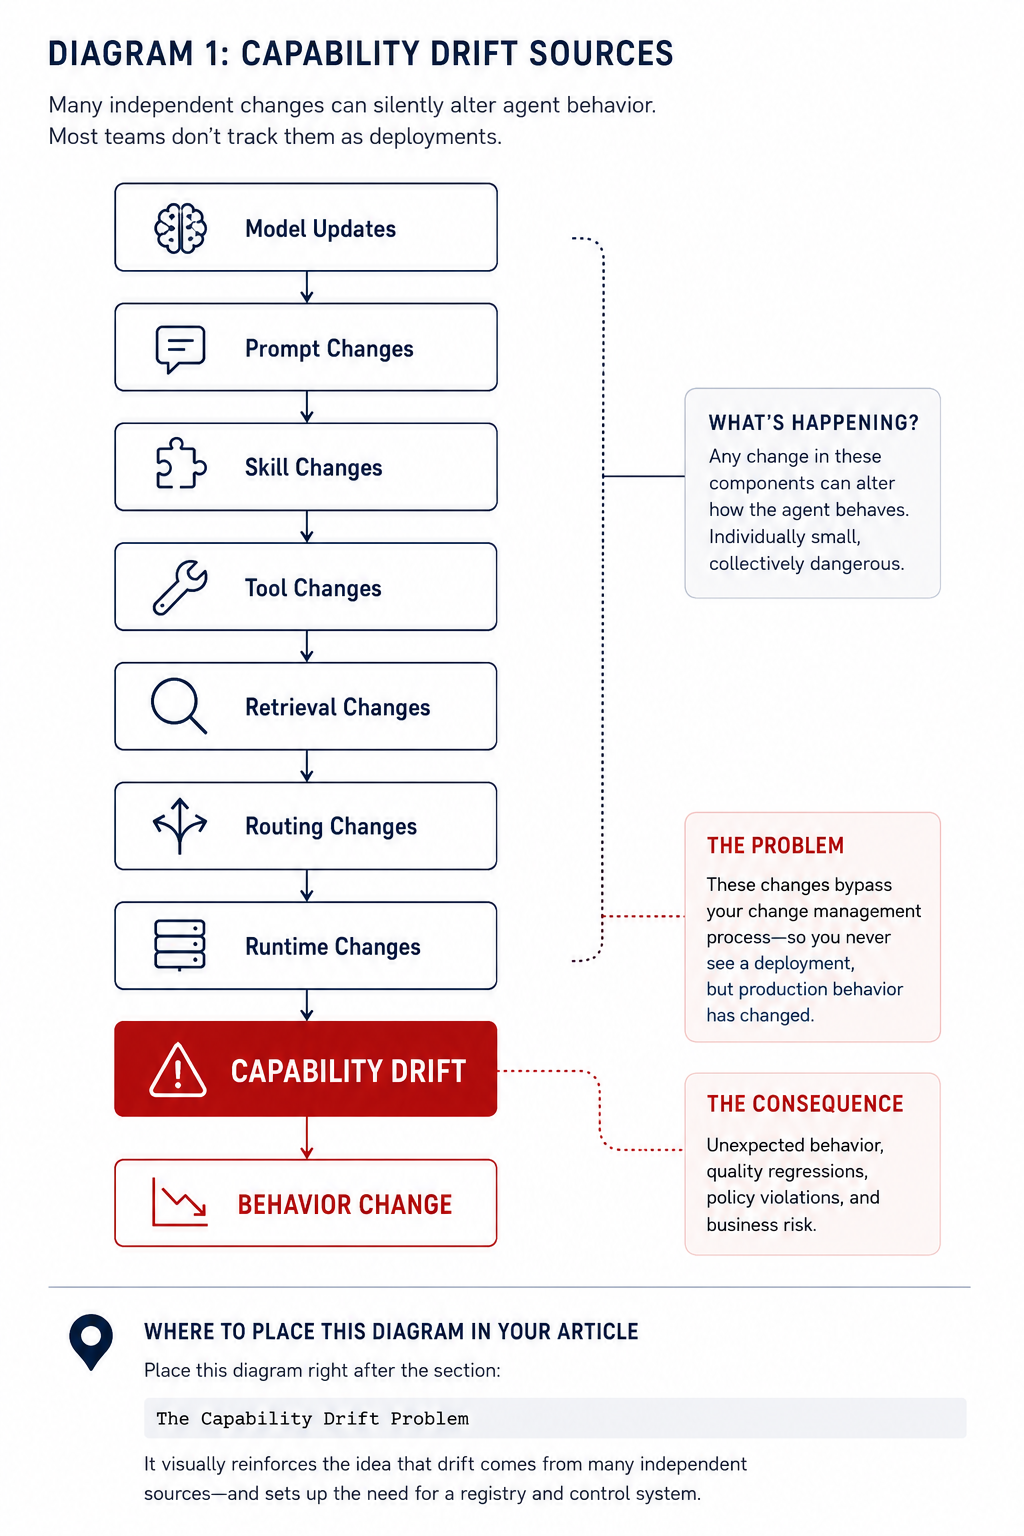
Capability drift é a mudança no que um agente consegue fazer, na qualidade com que o faz ou na forma como se comporta, sem uma mudança correspondente na superfície de change management.
Pode nascer de várias fontes:
- atualização do modelo pelo fornecedor;
- edição de prompt;
- alteração de uma Skill;
- mudança no schema de uma ferramenta;
- atualização do corpus de retrieval;
- alteração do routing;
- mudança no host ou runtime.
Cada uma pode alterar comportamento. Em conjunto, fazem-no continuamente.
O problema não é haver mudança. O problema é ela acontecer fora da pipeline de mudança.
Uma alteração de código pode ter vários gates e um plano de comunicação. Um model swap pode não ter nenhum.
Se o comportamento mudou, alguma coisa foi colocada em produção. A questão é se a organização viu esse deploy.
📚 Registry, Pin, Promote
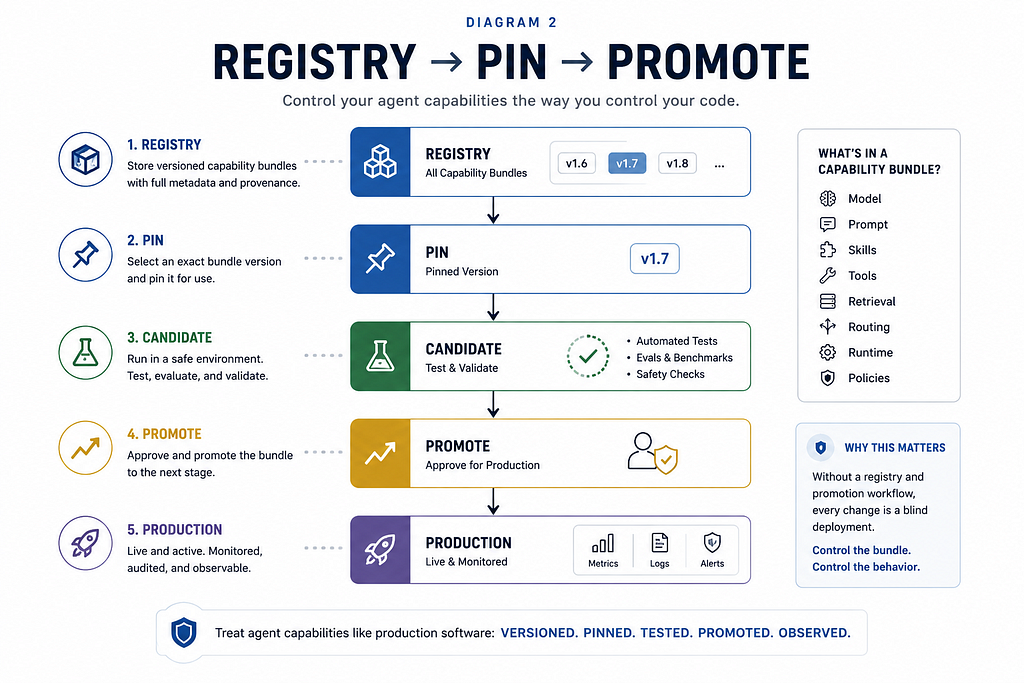
O instrumento de maior impacto é simples: um registo do que está realmente live.
Não aquilo que uma reunião aprovou. Não o que está escrito numa wiki. Aquilo que o runtime está a carregar agora.
Para cada agente colocado em produção, um registo útil inclui:
- modelo e version pin;
- versão e hash do prompt;
- Skills ativas e respetivas versões;
- Rules ativas e versões;
- tool manifest e signature;
- digest do policy bundle;
- versão do host runtime;
- último evento de atualização e provenance;
- owner.
O conjunto define a capacidade efetivamente colocada em produção.
Pin. Cada agente live usa versões explícitas. Sempre que seja possível fixar versões, uma mudança não deve entrar em produção por ambient drift.
Promote. Mover um pin é um deploy: tem candidate, verificação, rollout faseado, verdict e rollback path.
A disciplina é a mesma do release management de software; muda apenas o artifact.
📦 Um agente é colocado em produção como Capability Bundle
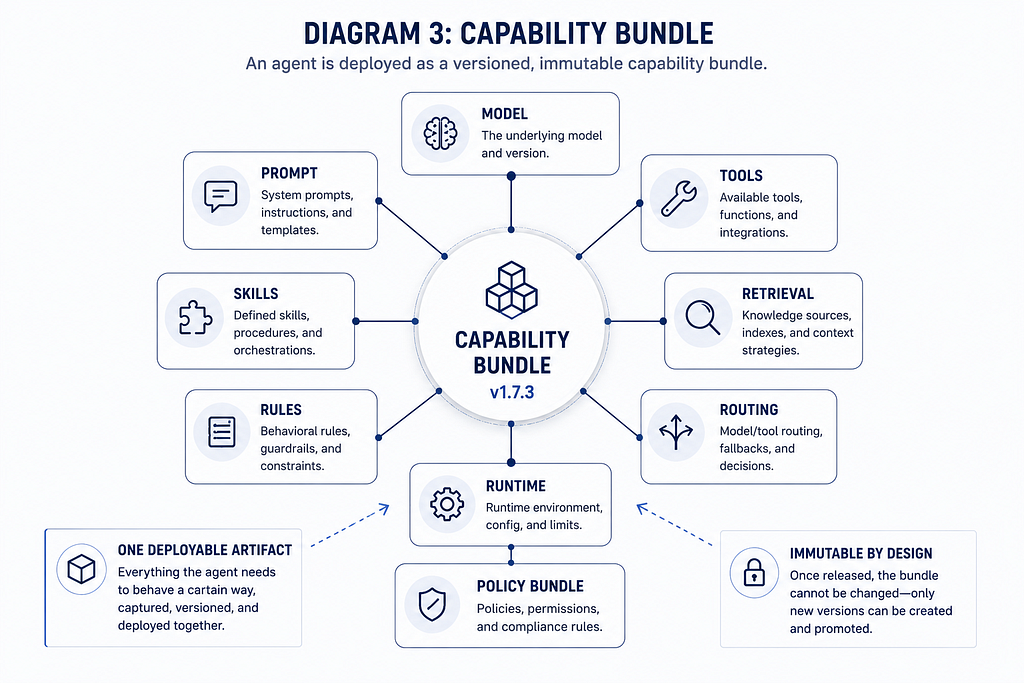
Um serviço costuma ser colocado em produção como um binário. Um agente deve ser entendido como um capability bundle montado em runtime:
- modelo e versão;
- prompt e hash;
- Skills e versões;
- Rules em vigor;
- ferramentas no manifest;
- policy bundle;
- runtime que aloja tudo.
Cada componente pode ter um owner e um caminho de release diferentes. Essa dispersão é a razão pela qual a mudança de um agente é difícil de apontar como um único evento.
O capability bundle torna-se esse artifact comum.
Se qualquer componente mudar, a versão do bundle muda: model swap, correção de uma linha no prompt, nova ferramenta numa Skill, novo policy bundle ou alteração do runtime.
Se não consegue nomear o artifact que mudou, não consegue governar a mudança.
🐤 Staged Rollout para capacidades de agentes
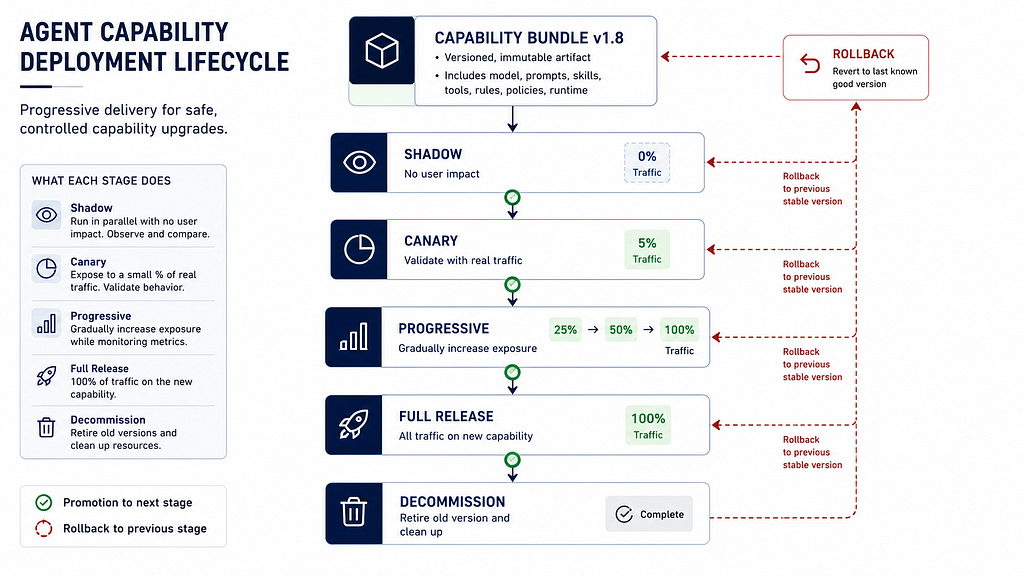
Uma atualização de capacidade não deve ser uma decisão binária.
- Shadow: a candidate corre sobre os mesmos inputs sem provocar side effects.
- Canary: uma pequena fatia de tráfego, utilizadores ou workflows usa a nova capacidade.
- Progressive: a fatia cresce com gates de go/no-go explícitos.
- Full: o novo bundle passa a default, mantendo o anterior reversível por uma janela definida.
- Decommission: o bundle anterior é removido depois de um período de observação.
Os sinais usados para controlar este rollout não podem limitar-se a latência e taxa de erro.
Devem incluir refusal rate, escalation rate, distribuição e volume de tool calls, conformidade da estrutura de output com o skill contract, taxa de emissão de evidence, distribuição de blast radius e supervisor override rate.
Estes sinais precisam de existir antes do upgrade.
📣 A camada de comunicação
Uma alteração da capacidade de um agente pode afetar muito mais pessoas do que os consumidores conhecidos de um serviço.
Uma prática útil inclui:
- release notes sobre comportamento;
- behavioral diffs em linguagem clara;
- notas de migração para consumidores downstream;
- expectativas de rollback explícitas.
O objetivo não é burocracia. É transformar capability change num evento conhecido.
↩️ Rollback para agentes
Escolha a última atualização de um agente em produção. A equipa consegue voltar atrás hoje, em menos de uma hora, com confiança?
Em muitas organizações, não.
O pin anterior pode já não existir, o prompt antigo pode ter sido substituído, o fornecedor pode ter retirado o modelo ou novos artifacts podem já depender do comportamento atualizado.
A disciplina de rollback deve espelhar a disciplina de upgrade:
- preservar o capability bundle anterior por uma janela definida;
- exercitar o caminho de rollback;
- produzir o mesmo nível de evidence do caminho de promoção;
- avisar consumidores downstream.
Nos agentes existe também um soft rollback: manter a nova capacidade, mas restringir um comportamento específico por policy ou contract. O Artigo 4, The Executable Policy Layer fornece a camada necessária.
🧪 Como reconhecer uma disciplina real
Funciona quando cada agente tem um capability pin atual e descobrível, cada mudança tem candidate, stage, verdict e rollback path, os sinais comportamentais estão no dashboard antes do upgrade e os hard e soft rollbacks são treinados fora dos incidentes.
Está em falta quando ninguém sabe indicar o modelo ativo, o prompt hash ou a versão de Skill; quando o primeiro sinal de problema é uma reclamação de cliente; quando rollback é uma conversa, não um caminho; e quando capability changes só aparecem em timelines de incidentes.
É também aí que a provenance da Parte 7 quebra: uma mudança que não foi registada como mudança não pode ser reconstruída.
🚨 Failure Modes da mudança ambiente
Provider drift. O modelo por trás de um nome estável muda e o comportamento move-se.
Prompt-by-Slack. Um prompt ajustado para um edge case muda o comportamento para toda a gente.
Skill creep. Uma Skill ganha uma ferramenta e o seu blast radius ultrapassa a fronteira aprovada.
Routing surprise. Um router passa a preferir um modelo mais barato; o custo melhora e a qualidade piora.
Rollback fantasy. A equipa acredita que consegue reverter, mas nunca testou o caminho.
O padrão é o mesmo: a capacidade do agente mudou e a pipeline não reparou.
🛠️ Ordem prática de implementação
- Construir o registo. Modelo, prompt, Skills, Rules, ferramentas, policy bundle, host e owner para cada agente.
- Fazer pin de tudo o que for possível. Converter latest e default em versões explícitas.
- Definir o capability bundle como artifact versionado.
- Implementar Shadow e Canary para bundles.
- Colocar sinais comportamentais no dashboard antes dos upgrades.
- Criar e ensaiar rollback hard e soft.
- Criar uma superfície estável de comunicação.
- Detetar mudanças ambientes do fornecedor e do runtime.
Isto não é uma disciplina nova. É release management, progressive delivery e SRE aplicados a um novo tipo de artifact.
🎯 Conclusão
A capacidade de um agente não é meteorologia.
É um deploy.
Cada ajuste de prompt, model swap, Skill update, nova ferramenta, mudança de policy ou alteração de runtime pode deslocar o comportamento de produção em vários workflows.
O playbook reduz-se a três frases:
Mudanças de capacidade são deploys. Deploys exigem governance. Governance exige visibilidade.
A cadeia quebra quando uma mudança acontece sem o sistema a registar como tal.
Se o comportamento dos seus agentes mudou mas o change log não mudou, não está a operar agentes em produção. Está apenas a alojá-los e a esperar que tudo corra bem.
Próximo artigo: Cost, Token, and Capability Budgets: The New FinOps for Agents.
Publicado originalmente por Reza Arani no Medium em junho de 2026. Adaptado para Aipolix como Parte 8 da série AI Governance in an AI-Native Software Development Company.
Comentários
Ainda não há comentários. Seja o primeiro a comentar.
Deixe um comentário