
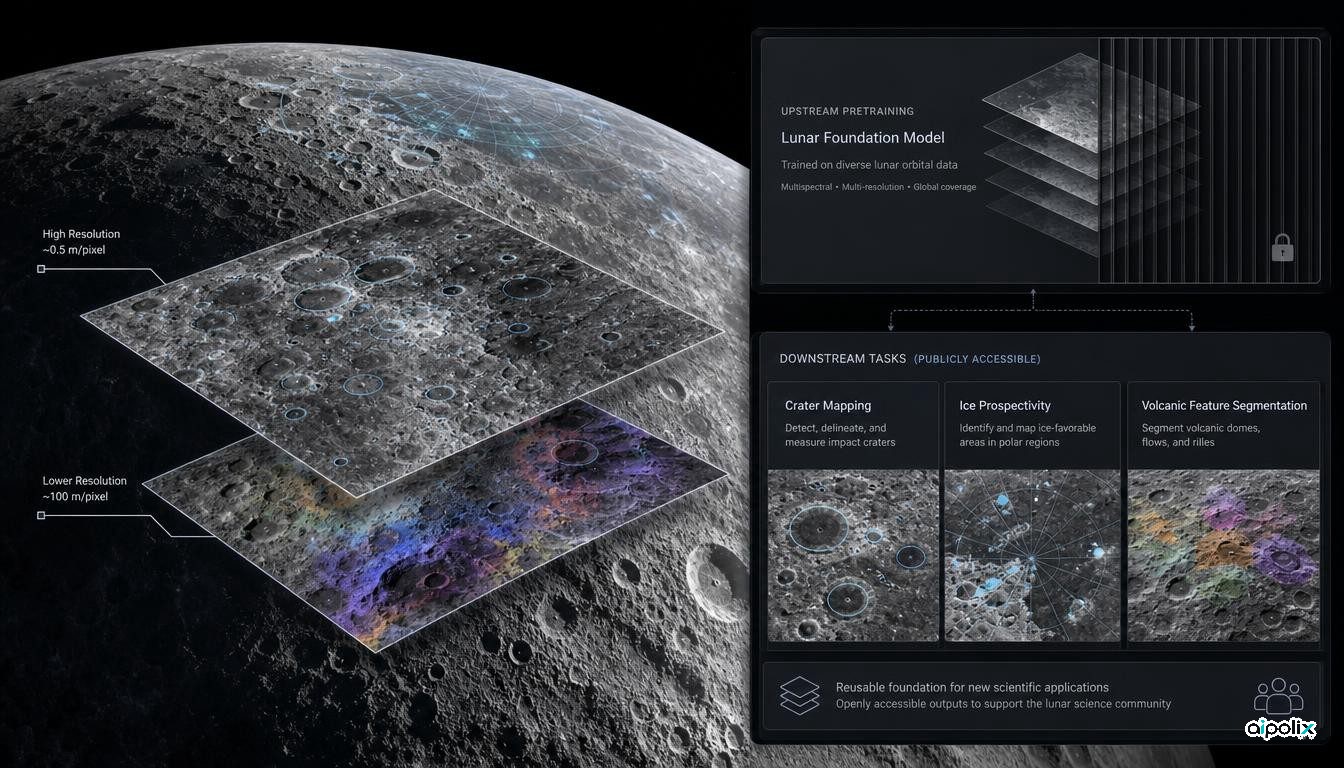
ناسا و IBM مدل NASA-IBM Lunar Foundation Model را برای استفاده عمومی منتشر کردهاند؛ مدلی که برای کار با چند نوع داده سنجشازدور ماه و در چند مقیاس مکانی ساخته شده است. اهمیت این انتشار فقط در خود مدل نیست. ناسا میگوید دادههای آماده برای یادگیری ماشین و مجموعههای ارزیابی نیز منتشر شدهاند و مخزن پروژه ابزارهای لازم برای سازگار کردن مدل با وظایف بعدی و اتصال آن به TerraTorch را در اختیار پژوهشگران میگذارد.
با این حال، دامنه بازبودن پروژه یک مرز روشن دارد. در مخزن رسمی GitHub صریحاً نوشته شده که کد آموزش اولیه مدل منتشر نشده است. بنابراین پژوهشگران میتوانند وزنها را بررسی کنند، مدل را اجرا کنند و برای کاربردهای جدید دوباره آموزش دهند، اما بازسازی کامل فرایندی که به مدل پایه منتهی شده از روی همین مخزن ممکن نیست.
دادهای که فقط تصویر نیست
بر اساس توضیح ناسا، بخش اصلی آموزش با دادههای مدارگرد شناسایی ماه انجام شده و نزدیک به دو میلیون قطعه داده تصویری در آن به کار رفته است. این مجموعه بیش از یک میلیون تصویر با تفکیک حدود یک متر و نزدیک به ۹۶۴ هزار تصویر چندطیفی با تفکیک حدود ۱۰۰ متر را در بر میگیرد و با دادههای مأموریتهای دیگر تکمیل شده است.
صفحه فنی مدل در Hugging Face معماری را یک رمزگذار-رمزگشای ViT-B معرفی میکند که با ۱۱ نوع داده و در دو مقیاس مکانی آموزش دیده است. دو تصمیم طراحی در اینجا فراتر از مسئله ماه اهمیت دارند. نخست اینکه اطلاعات مربوط به نحوه ثبت تصویر، مانند زاویه تابش، مستقیماً به مدل داده میشود تا شبکه مجبور نباشد اثر نور را فقط از روی پیکسلها حدس بزند. دوم اینکه دادههای با تفکیک بالا و پایین در یک فرایند مشترک آموزش میبینند تا یک مجموعه وزن بتواند در فاصلهای حدود صدبرابری میان دو مقیاس به کار رود.
برای سامانههای علمی، این رویکرد یک نکته معماری مهم دارد: وقتی درباره شرایط فیزیکی ثبت داده اطلاعات معتبری داریم، لازم نیست مدل آن شرایط را دوباره از روی داده خام کشف کند. وارد کردن این اطلاعات به ورودی میتواند بازنمایی حاصل را به فرایند واقعی اندازهگیری نزدیکتر کند.
عدد «تا ۲۳ درصد» برای همه وظایف صدق نمیکند
IBM در اعلام انتشار گفته است مدل در برخی وظایف نقشهبرداری ماه تا ۲۳ درصد بهتر از روشهای رایج عمل میکند. نتایج منتشرشده برای وظایف مختلف نشان میدهد این عدد را نباید بهعنوان برتری عمومی مدل تعبیر کرد.
در ارزیابی تشخیص دهانهها، برای مقیاس حدود ۱۰۰ متر، میانگین دقت ۰٫۲۵۸۱ گزارش شده است؛ بهترین خط مبنای ازپیشآموزشدیده با ImageNet در همان جدول ۰٫۲۴۲۰ است. اما در مقیاس یک متر، نتیجه ۰٫۱۵۴۳ از نظر آماری تفاوت معناداری با بهترین خط مبنا، یعنی ۰٫۱۵۵۲ برای SwinV2-B، ندارد.
در وظیفه برآورد نواحی مستعد یخ، فاصله روشنتر است. صفحه این ارزیابی برای نسخهای که بهطور کامل دوباره آموزش داده شده، خطای RMSE برابر ۰٫۰۲۹۳ گزارش میکند؛ در همان آزمایش مقدار SwinV2-B برابر ۰٫۰۳۷۷ است. این نتایج ارزشمندند، اما هنوز به چند آزمون مشخص محدود میشوند و بهتنهایی برتری کلی یک مدل پایه را برای همه مسائل علمی ماه ثابت نمیکنند.
استفاده از مدل باز است؛ بازسازی آموزش اولیه هنوز نه
بخش عملی انتشار، برای پژوهشگران قابل استفاده است. وزنها و تنظیمات مدل در Hugging Face قرار دارند، نمونههای تنظیمشده برای وظایف مشخص منتشر شدهاند و مخزن GitHub ماژول مدل، ابزارهای داده و پیکربندیهای قابل اجرا برای TerraTorch را ارائه میکند. در نتیجه برای شروع یک آزمایش تازه لازم نیست کل زیرساخت پردازش داده از ابتدا ساخته شود.
اما نبود کد آموزش اولیه تعریف «بازبودن» را محدود میکند. این موضوع در خود مخزن اعلام شده و نقص پنهانی نیست. با این حال، تفاوت مهمی میان «امکان استفاده و سازگار کردن مدل» و «امکان بازسازی مسیر تولید مدل» وجود دارد.
در هوش مصنوعی علمی، بخش مهمی از نتیجه به تصمیمهای پیش از آموزش نهایی وابسته است: گردآوری و نمونهگیری داده، نحوه متعادل کردن انواع داده، عادیسازی، روش پوشاندن بخشهایی از ورودی و برنامه آموزش. انتشار وزنها و کد مربوط به استفاده بعدی هزینه ورود را پایین میآورد؛ انتشار کامل مسیر آموزش اولیه امکان ممیزی و بازسازی مستقل را بیشتر میکند. پروژه NASA و IBM فعلاً بخش نخست را کاملتر پوشش میدهد.
نکتهای که برای پروژههای علمی دیگر مهم است
با وجود این محدودیت، انتشار جدید یک زیرساخت علمی جدی است. ناسا دادههای چند مأموریت را به منابعی تبدیل کرده که مستقیماً در فرایندهای یادگیری ماشین قابل استفادهاند و پژوهشگران یک نقطه شروع مشترک برای نقشهبرداری دهانهها، بررسی عوارض آتشفشانی و برآورد نواحی مستعد یخ دارند. رویترز نیز انتشار مدل و همین کاربردها را مستقل از دو سازمان گزارش کرده است.
برای ارزیابی مدلهای پایه تخصصی، دو پرسش باید از هم جدا بماند: آیا مدل و ابزارهای منتشرشده هزینه انجام یک کار واقعی را پایین میآورند؟ در این پروژه پاسخ مثبت است. آیا یک گروه مستقل میتواند فرایند آموزش ادعاشده را نیز از ابتدا بازسازی کند؟ با مخزن فعلی، پاسخ هنوز کامل نیست.
اهمیت این پروژه در این نیست که یک مدل عمومی «ماه را میفهمد». ارزش اصلی در تبدیل دادههای پراکنده و ناهمگون علمی به یک لایه مشترک مدل و داده است؛ با مرزی که درباره قابلیت بازسازی فرایند آموزش، دستکم بهروشنی قابل مشاهده است.