
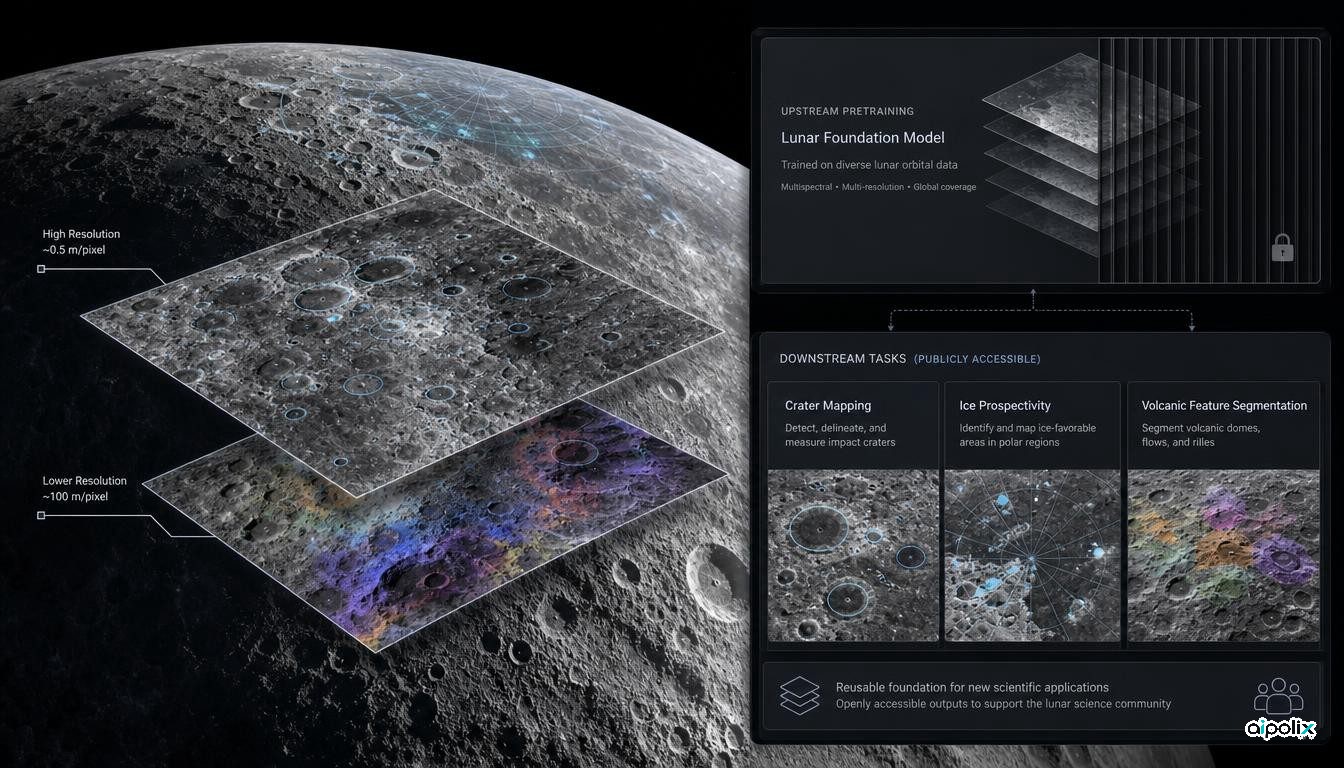
La NASA et IBM ont publié le NASA-IBM Lunar Foundation Model, un modèle ouvert conçu pour exploiter plusieurs types de données de télédétection lunaire à des résolutions très différentes. La publication va au-delà d'un simple jeu de poids : la NASA annonce aussi des jeux de données préparés pour l'apprentissage automatique et des collections d'évaluation, tandis que le dépôt du projet fournit les composants nécessaires pour adapter le modèle à des tâches scientifiques avec TerraTorch.
Il reste toutefois une limite importante à la reproductibilité. Le dépôt GitHub officiel indique explicitement que le code de préentraînement n'est pas fourni. Les chercheurs peuvent donc inspecter le modèle, l'exécuter et reproduire une bonne partie des expériences d'adaptation, mais ils ne disposent pas de tout ce qu'il faut pour reconstruire à l'identique la phase qui a produit le modèle de base.
Un modèle pensé pour la géométrie particulière des observations lunaires
D'après la NASA, l'entraînement repose principalement sur les observations du Lunar Reconnaissance Orbiter et sur environ deux millions de tuiles. L'ensemble comprend plus d'un million d'images à haute résolution, autour d'un mètre par pixel, et près de 964 000 images multispectrales autour de 100 mètres par pixel, complétées par des données d'autres missions.
La fiche du modèle décrit un encodeur-décodeur ViT-B entraîné sur 11 modalités et deux échelles spatiales. Deux choix sont particulièrement intéressants pour d'autres projets scientifiques. Le premier consiste à fournir au modèle des informations sur les conditions d'acquisition, notamment les angles d'éclairement, plutôt que de lui demander de reconstituer ces effets uniquement à partir des pixels. Le second fait apprendre ensemble les données à haute et basse résolution, afin qu'un même ensemble de poids puisse être adapté à des observations séparées par un facteur d'environ 100 en résolution.
Cette architecture illustre une idée plus générale : dans un modèle scientifique, les métadonnées physiques connues peuvent faire partie de l'entrée. Sur la Lune, l'éclairage modifie fortement l'apparence du relief. Donner ce contexte au modèle évite de transformer un paramètre déjà mesuré en problème d'inférence supplémentaire.
Le chiffre de 23 % ne décrit pas toutes les tâches
IBM met en avant un gain pouvant atteindre 23 % sur certaines tâches de cartographie. Les résultats détaillés montrent pourtant que l'avantage varie nettement selon le problème étudié.
Pour la détection de cratères à l'échelle d'environ 100 mètres, le point de contrôle publié affiche une précision moyenne de 0,2581, contre 0,2420 pour le meilleur modèle de référence préentraîné sur ImageNet présenté dans la même comparaison. À l'échelle métrique, le score de 0,1543 du modèle NASA-IBM est en revanche présenté comme statistiquement indiscernable du meilleur résultat SwinV2-B, à 0,1552.
L'estimation des zones propices à la présence de glace montre un écart plus marqué. La fiche de cette tâche rapporte une erreur RMSE de 0,0293 après adaptation complète du modèle NASA-IBM, contre 0,0377 pour SwinV2-B sur l'ensemble polaire à huit modalités. Ces résultats sont utiles, mais ils restent propres à des jeux d'évaluation précis. Ils ne démontrent pas une supériorité générale du modèle pour toute la science lunaire.
Ouvert pour l'adaptation, pas encore pour reproduire tout le préentraînement
La partie la plus directement exploitable de la publication se trouve en aval. Les poids et la configuration sont accessibles sur Hugging Face, plusieurs modèles adaptés à des tâches spécifiques sont publiés, et le dépôt GitHub contient le paquet du modèle ainsi que les modules de données, les tâches et les configurations compatibles avec TerraTorch. Une équipe peut donc partir du modèle existant sans reconstruire tout l'environnement de traitement.
L'absence du code de préentraînement change néanmoins la portée du mot « ouvert ». Le dépôt l'annonce clairement, il ne s'agit donc pas d'une lacune dissimulée. Mais l'ouverture permet ici surtout de reproduire l'utilisation et l'adaptation du modèle, pas l'intégralité de sa fabrication.
Pour l'IA scientifique, cette nuance est importante. Des choix décisifs interviennent avant l'adaptation finale : constitution et échantillonnage des données, équilibre entre modalités, normalisation, stratégie de masquage ou calendrier d'entraînement. Publier les poids et le code d'adaptation réduit fortement le coût d'entrée. Publier également la chaîne complète de préentraînement rendrait l'audit et la reconstruction indépendante plus complets.
Ce que les équipes scientifiques peuvent réellement en tirer
La publication reste une avancée d'infrastructure utile. La NASA explique que des observations provenant de plusieurs missions ont été transformées en ressources prêtes pour l'apprentissage automatique. Les chercheurs disposent ainsi d'un point de départ commun pour la cartographie des cratères, l'étude des structures volcaniques et l'estimation des zones susceptibles de contenir de la glace. Reuters a également confirmé indépendamment la sortie du modèle et ces domaines d'utilisation.
Pour évaluer ce type de modèle spécialisé, deux questions méritent donc d'être séparées. Le modèle et ses outils réduisent-ils le coût d'un travail scientifique réel ? Ici, oui. Une équipe extérieure peut-elle aussi reconstruire le processus d'entraînement annoncé à partir des éléments publiés ? Avec le dépôt actuel, pas entièrement.
Le précédent le plus intéressant n'est pas qu'une IA généraliste « comprenne la Lune ». C'est qu'un programme scientifique public transforme des données complexes et hétérogènes en une couche réutilisable de modèles et de jeux de données, tout en laissant visible la frontière actuelle de la reproductibilité.