
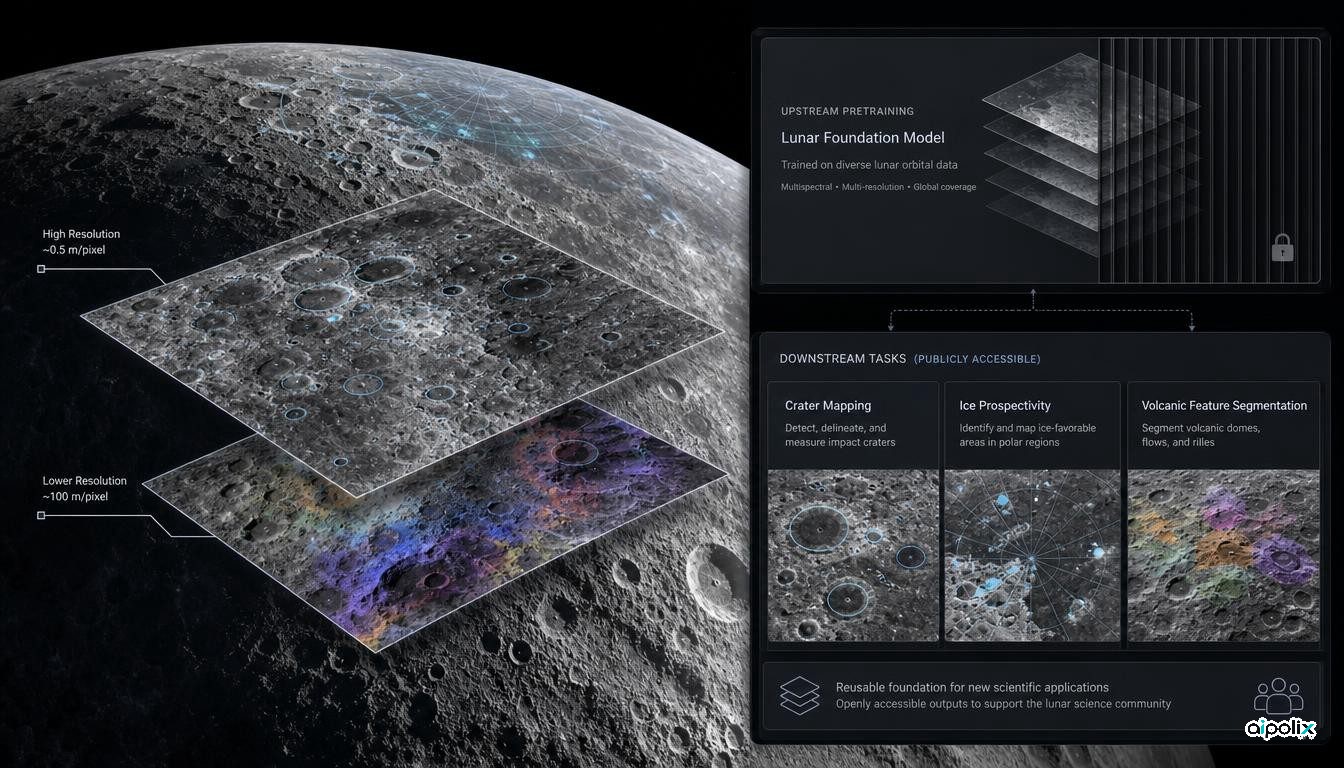
A NASA e a IBM publicaram o NASA-IBM Lunar Foundation Model, um modelo aberto concebido para trabalhar com vários tipos de dados de deteção remota da Lua e com resoluções muito diferentes. A publicação não se limita aos pesos do modelo: a NASA refere também conjuntos de dados preparados para aprendizagem automática e coleções de avaliação, enquanto o repositório do projeto inclui componentes para adaptar o modelo a tarefas científicas através do TerraTorch.
Há, porém, um limite importante à reprodutibilidade. O repositório oficial no GitHub afirma de forma explícita que o código usado no pré-treino não está incluído. Na prática, é possível inspecionar o modelo, executá-lo e reproduzir grande parte do trabalho de adaptação, mas não reconstruir integralmente, apenas com o que foi publicado, o processo que deu origem ao modelo de base.
Um modelo desenhado para a forma como os dados lunares são recolhidos
Segundo a NASA, o treino usou sobretudo dados do Lunar Reconnaissance Orbiter e cerca de dois milhões de blocos de imagem. O conjunto inclui mais de um milhão de imagens de alta resolução, perto de um metro por píxel, e quase 964 mil imagens multiespectrais com cerca de 100 metros por píxel, além de observações provenientes de outras missões.
A ficha do modelo descreve um codificador-descodificador ViT-B treinado com 11 modalidades e duas escalas espaciais. Dois aspetos são relevantes também para outros sistemas científicos. Primeiro, o modelo recebe informação sobre as condições de aquisição, incluindo ângulos de iluminação, em vez de ter de inferir esses efeitos apenas a partir dos píxeis. Segundo, dados de alta e baixa resolução são usados no mesmo processo de treino, permitindo adaptar um único conjunto de pesos a observações separadas por uma diferença de resolução próxima de 100 vezes.
A opção mostra uma ideia importante para modelos científicos: metadados físicos conhecidos podem fazer parte da entrada. Na Lua, a iluminação altera fortemente o aspeto da superfície. Se essa informação já foi medida, fornecê-la ao modelo evita transformar um dado conhecido num problema adicional de inferência.
O ganho de 23% não aparece da mesma forma em todas as tarefas
A IBM destaca melhorias que podem chegar a 23% em determinadas tarefas de cartografia lunar. Os resultados publicados por tarefa mostram, no entanto, que a vantagem varia bastante.
Na deteção de crateras à escala aproximada de 100 metros, o modelo ajustado publicado apresenta uma precisão média de 0,2581, face a 0,2420 para o melhor modelo de referência pré-treinado com ImageNet indicado na mesma comparação. À escala de um metro, o resultado de 0,1543 é descrito como estatisticamente indistinguível do melhor resultado do SwinV2-B, de 0,1552.
Na estimativa de zonas com maior probabilidade de gelo, a diferença é mais clara. A ficha dessa tarefa apresenta um RMSE de 0,0293 para o modelo NASA-IBM depois de um ajuste completo, contra 0,0377 para o SwinV2-B no conjunto polar com oito modalidades. São resultados relevantes, mas continuam a ser resultados de avaliações específicas. Não demonstram que o mesmo modelo seja superior em qualquer problema de ciência lunar.
Aberto para adaptação não significa pré-treino totalmente reproduzível
A parte mais útil da publicação está no caminho de utilização posterior. Os pesos e a configuração podem ser descarregados do Hugging Face, existem modelos já adaptados a tarefas concretas e o repositório no GitHub contém o pacote do modelo, módulos de dados, tarefas e configurações executáveis compatíveis com TerraTorch. Uma equipa pode, portanto, começar a testar e ajustar o modelo sem reconstruir toda a infraestrutura.
A ausência do código de pré-treino limita, ainda assim, o significado operacional de «aberto». O próprio repositório é transparente sobre essa ausência, pelo que não se trata de uma falha escondida. A questão é outra: há uma diferença entre conseguir usar e adaptar um modelo e conseguir reproduzir o processo que o criou.
Em IA científica, decisões importantes acontecem antes do ajuste final: seleção e amostragem dos dados, equilíbrio entre modalidades, normalização, estratégia de mascaramento e calendário de treino. Publicar pesos e ferramentas de adaptação reduz o custo de entrada. Publicar também todo o processo de pré-treino aumentaria a capacidade de auditoria e reconstrução independente. Neste momento, o projeto NASA-IBM cobre melhor o primeiro objetivo do que o segundo.
O que esta publicação muda para equipas científicas
Apesar desse limite, trata-se de uma publicação relevante de infraestrutura científica. A NASA diz ter convertido observações de várias missões em recursos preparados para aprendizagem automática, dando aos investigadores um ponto de partida comum para cartografia de crateras, análise de formações vulcânicas e estudo de zonas potencialmente ricas em gelo. A Reuters confirmou de forma independente o lançamento e estes usos.
Ao avaliar modelos especializados deste tipo, convém separar duas perguntas. O modelo e as ferramentas publicadas reduzem o custo de um trabalho científico real? Neste caso, sim. Um grupo independente consegue também reconstruir o processo de treino anunciado apenas com os artefactos publicados? Com o repositório atual, ainda não por completo.
O precedente mais interessante não é a ideia de uma IA genérica que «compreende a Lua». É a transformação de dados científicos difíceis e heterogéneos numa camada reutilizável de modelo e dados, com uma fronteira de reprodutibilidade suficientemente clara para poder ser auditada.