
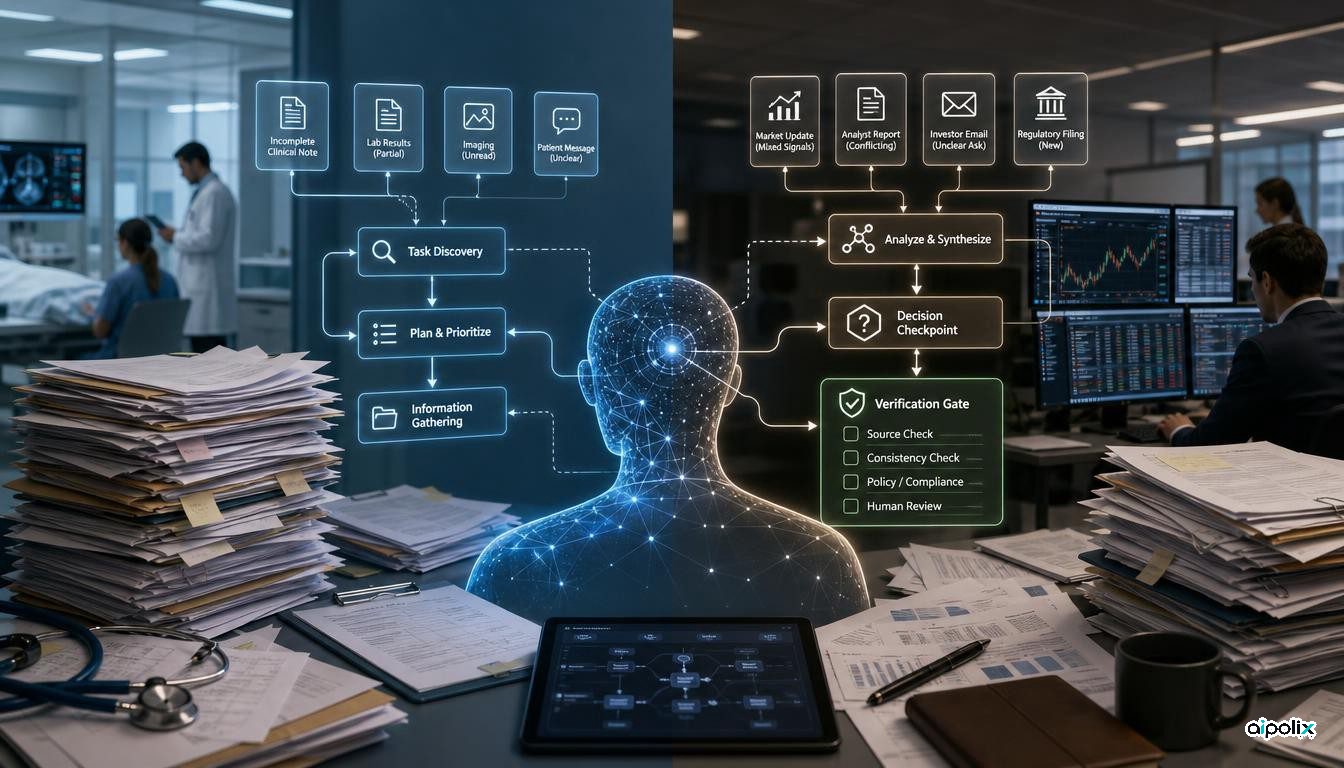
Surge AI دو معیار تازه با نامهای DAYJOB: Healthcare و DAYJOB: Finance منتشر کرده است که بخش دشواری از کار حرفهای را وارد ارزیابی عاملهای هوش مصنوعی میکنند: در دنیای واقعی معمولاً کسی تمام مراحل کار را از قبل برای عامل نمینویسد. سامانه باید از میان اطلاعات نامرتب تشخیص دهد چه کاری لازم است، چه دادهای کم است، چه ابزاری باید استفاده شود و خروجی نهایی چه شکلی باید داشته باشد.
اعداد اولیه هشدار مهمی هستند. Surge AI گزارش میکند بهترین مدل ارزیابیشده تنها ۲۴٫۷ درصد وظایف DAYJOB: Healthcare و ۲۳٫۹ درصد وظایف DAYJOB: Finance را با موفقیت انجام داده است. این اعداد نتایج خود معیار هستند و نباید بهعنوان نرخ شکست عمومی مدلها در محیط واقعی تعبیر شوند، اما نشان میدهند ارزیابیهای بسیار ساختاریافته ممکن است بخش مهمی از دشواری کار واقعی را پنهان کنند.
ابهام، بخشی از خود مسئله است
در بسیاری از معیارهای عاملها، انسان پیشاپیش یکی از سختترین مراحل را انجام داده است: مسئله را دقیق تعریف کرده است. در یک آزمون برنامهنویسی، باگ مشخص میشود؛ در آزمون مرورگر، اطلاعات مورد نیاز معلوم است؛ و در یک گردشکار، ورودیها از قبل فهرست شدهاند. این روش سنجش اجرا را ساده میکند، اما توانایی کشف نیازمندی را از آزمون حذف میکند.
DAYJOB بخشی از این ابهام را برمیگرداند. وظایف سلامت، حوزههای بالینی، عملیاتی، بیمه و پرداخت، داروخانه و انطباق را پوشش میدهند. بخش مالی نیز شامل مالی شرکتی، بانکداری، اعتبار، سرمایهگذاری و داراییهای واقعی است. وجه مشترک آنها تبدیل زمینه نامرتب به تصمیم حرفهای و یک خروجی کامل است.
تحلیل Aipolix این است که در چنین محیطی تعریف «قابلیت اطمینان عامل» تغییر میکند. عامل فقط بهخاطر توانایی فراخوانی ابزار یا استدلال روی یک برنامه معلوم موفق نمیشود. ابتدا باید برنامه درست را استنباط کند، اطلاعات ناقص را تشخیص دهد و بفهمد چه چیزی خروجی قابل قبول محسوب میشود. ممکن است تکتک فراخوانیهای ابزار درست باشند، اما کل کار شکست بخورد چون عامل مسئله اشتباهی را حل کرده است.
نرخ موفقیت پایین به یک مشکل چندمرحلهای اشاره میکند
Surge AI قابلیتهای مورد سنجش را در قالب استفاده از ابزار، برنامهریزی، سازگاری، اتکا به شواهد و عقل سلیم توصیف میکند. این ترکیب مهم است، زیرا شکست در کار طولانی معمولاً از یک ضعف منفرد نمیآید. یک برداشت اولیه اشتباه میتواند برنامه نادرست بسازد؛ برنامه نادرست داده اشتباه جمع کند؛ و سپس استدلالی ظاهراً منسجم به خروجی غیرقابل استفاده برسد.
در جدول سلامت، Claude Opus 5.5 با ۲۴٫۷ درصد در صدر نتایج گزارششده قرار دارد و GPT-6 Astra با ۱۱٫۶ درصد و Claude Fable 5.1 با ۹٫۶ درصد بعد از آن هستند. در بخش مالی، نتایج گزارششده برای این سه مدل بهترتیب ۲۳٫۹، ۲۱٫۵ و ۱۹٫۸ درصد است. این اعداد فقط باید در محدوده وظایف DAYJOB مقایسه شوند و رتبهبندی عمومی مدلها نیستند.
برای تیمهای فنی، سطح مطلق نتایج از ترتیب مدلها مهمتر است. حتی بهترین نتیجه به معنای ناموفق بودن بخش بزرگی از وظایف است. بنابراین مسیر ارجاع به انسان، بررسیهای میانی و معیار پذیرش روشن را نمیتوان در سامانههای حرفهای ویژگیهای فرعی دانست.
کشف نیازمندی باید به یک دروازه انتشار تبدیل شود
یک نتیجه عملی این است که ارزیابی عامل باید قبل از مرحله اجرا شروع شود. تیم باید بسنجد آیا عامل میتواند نتیجه مورد انتظار، محدودیتهای پنهان، شواهد لازم و شرایطی را که باید در آن سؤال بپرسد یا متوقف شود، درست تشخیص دهد یا نه.
یک ساختار چندلایه مفید است. ابتدا فهم مسئله سنجیده شود: آیا عامل میتواند هدف را بازگو کند و اطلاعات گمشده را مشخص کند؟ سپس برنامهریزی و انتخاب ابزار بررسی شود. در پایان، خروجی نهایی با معیارهای حرفهای ارزیابی شود. اگر همه این مراحل در یک امتیاز نهایی ادغام شوند، تیم میفهمد عامل شکست خورده اما نمیفهمد مشکل از سوءبرداشت، اجرا یا قضاوت بوده است.
همین ساختار میتواند در محیط واقعی نیز مرز ایمنی ایجاد کند. پیش از یک اقدام مهم، یک مرحله مستقل میتواند برداشت عامل از مأموریت را با اختیار کاربر و شواهد موجود مقایسه کند. در فرایندهای حساس، چنین کنترلی ممکن است از یک دور استدلال اضافه پس از انتخاب مسیر اشتباه ارزشمندتر باشد.
DAYJOB چه چیزی را ثابت نمیکند؟
DAYJOB مجموعهای مشخص از وظایف سلامت و مالی را پوشش میدهد. از آن نمیتوان یک نرخ شکست واحد برای تمام مشاغل دانشی استخراج کرد. محیط واقعی از نظر ابزارها، کیفیت داده، سطح دسترسی، آموزش، بازبینی انسانی و توزیع وظایف متفاوت است.
همچنین امتیاز بالاتر لزوماً به معنای استقرار امنتر نیست. ممکن است مدلی با امتیاز کمتر اما اختیار محدودتر و کنترلهای قویتر برای یک سازمان مناسبتر باشد. قابلیت اطمینان واقعی حاصل تعامل مدل، چارچوب عامل، داده، مجوزها و سامانه راستیآزمایی است.
ارزش اصلی DAYJOB در روش ارزیابی آن است: کشف خودِ وظیفه را وارد سنجش میکند. هرچه عاملها از پاسخدهنده به سامانههایی تبدیل شوند که مسئول نتیجه هستند، این لایه اهمیت بیشتری پیدا میکند. پرسش فقط این نیست که آیا عامل میتواند یک برنامه را اجرا کند؛ باید سنجید آیا پیش از اجرا میتواند برنامه درست را پیدا کند یا نه.