
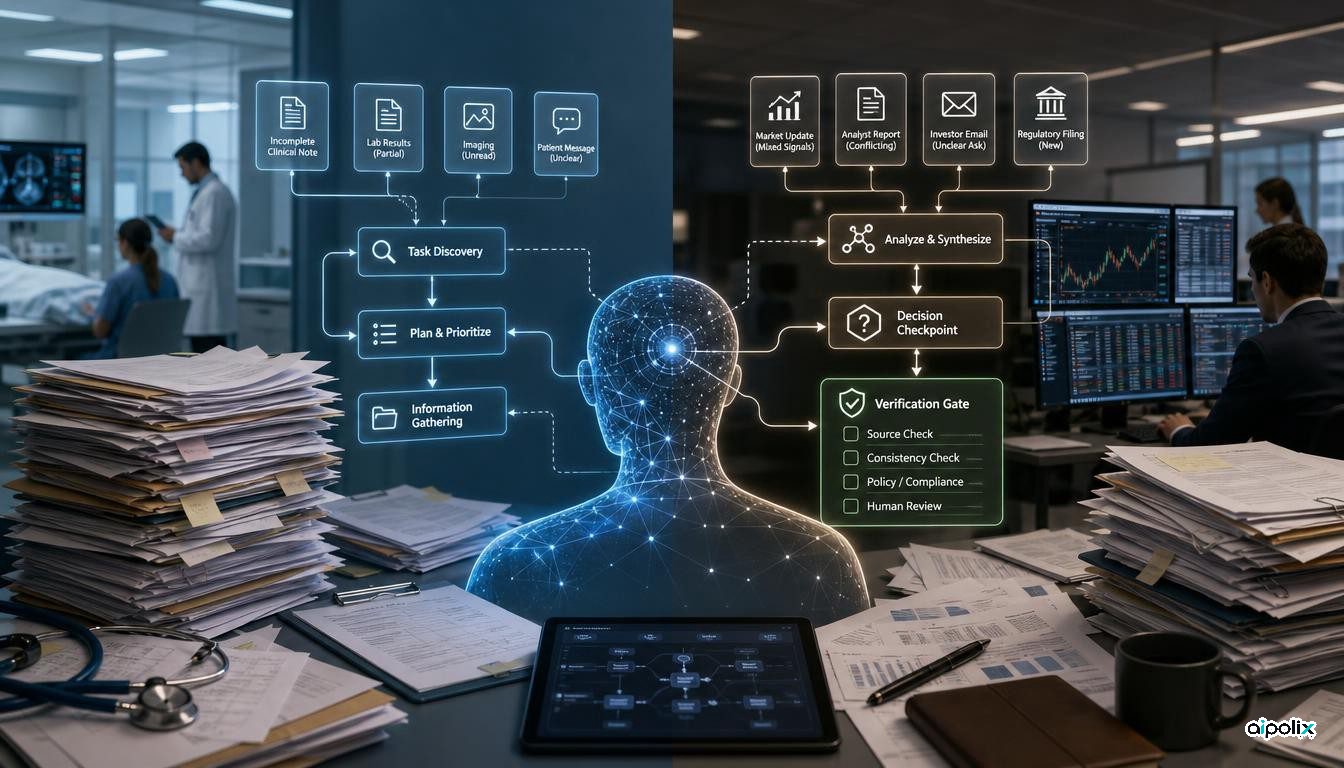
Surge AI vient de publier DAYJOB: Healthcare et DAYJOB: Finance, deux benchmarks qui réintroduisent dans l’évaluation des agents une difficulté souvent supprimée : dans un environnement professionnel, le travail arrive rarement sous la forme d’une spécification complète. L’agent doit comprendre ce qui est demandé, repérer les informations manquantes, choisir ses outils et produire un résultat exploitable.
Les premiers scores invitent à la prudence face aux démonstrations d’agents sur des tâches très structurées. Surge AI indique que le meilleur modèle évalué réussit 24,7 % des tâches de DAYJOB: Healthcare et 23,9 % de celles de DAYJOB: Finance. Ces chiffres proviennent du créateur du benchmark et ne constituent pas des taux d’échec en production, mais ils rendent visible un écart important entre exécuter une consigne précise et prendre en charge un travail professionnel.
L’ambiguïté devient une partie du test
De nombreux benchmarks commencent après qu’un humain a déjà accompli une étape essentielle : définir précisément le problème. Un test de programmation peut désigner le bug à corriger. Un test de navigation peut préciser l’information à récupérer. Un workflow peut fournir la liste exacte des entrées attendues. Cette structure facilite la mesure de l’exécution, mais retire la découverte des exigences de l’évaluation.
DAYJOB remet cette difficulté dans la boucle. Les tâches de santé couvrent des activités cliniques, opérationnelles, liées aux payeurs, à la pharmacie et à la conformité. Les tâches financières couvrent la finance d’entreprise, la banque, le crédit, l’investissement et les actifs réels. Dans les deux cas, l’objectif est de transformer un contexte imparfait en jugement professionnel et en travail terminé.
L’analyse d’Aipolix est que cette conception élargit la notion de fiabilité d’un agent. Il ne suffit plus de savoir appeler un outil ou raisonner à l’intérieur d’un plan connu. L’agent doit d’abord inférer le bon plan, distinguer les éléments pertinents, identifier les lacunes et comprendre ce qui constitue un livrable satisfaisant. Tous les appels d’outils peuvent être techniquement corrects alors que le résultat global reste faux parce que l’agent a résolu le mauvais problème.
Les faibles taux de réussite révèlent une chaîne de défaillances possibles
Surge AI décrit cinq capacités centrales dans ses environnements : utilisation des outils, planification, adaptation, ancrage dans les faits et bon sens. Leur combinaison est importante, car les tâches longues échouent rarement pour une seule raison. Une mauvaise interprétation initiale peut produire un plan inadéquat, conduire à collecter les mauvaises données et aboutir à une réponse cohérente en apparence mais inutilisable.
Dans le classement santé, Claude Opus 5.5 atteint 24,7 %, GPT-6 Astra 11,6 % et Claude Fable 5.1 9,6 %. En finance, Surge AI publie respectivement 23,9 %, 21,5 % et 19,8 % pour ces trois modèles. Ces résultats doivent rester attachés aux tâches DAYJOB et ne constituent pas un classement universel des modèles.
Pour les équipes d’ingénierie, le niveau absolu est plus instructif que l’ordre. Même le meilleur résultat laisse une majorité de tâches en échec selon la grille du benchmark. Les mécanismes d’escalade vers un humain, les contrôles intermédiaires et les critères d’acceptation explicites restent donc des composants de production, pas des options de confort.
La découverte des exigences devrait devenir une barrière de mise en production
Une conséquence pratique est de commencer l’évaluation avant l’exécution. Il faut vérifier si l’agent identifie correctement le résultat attendu, les contraintes implicites, les preuves nécessaires et les situations dans lesquelles il doit demander une précision plutôt que poursuivre.
Une évaluation en couches peut aider. La première couche mesure la compréhension : l’agent sait-il reformuler l’objectif et signaler les informations manquantes ? La deuxième mesure le plan et le choix des outils. La dernière évalue le livrable selon des critères professionnels. En réduisant tout à un seul score final, une organisation sait qu’un agent a échoué sans savoir si la cause est l’interprétation, l’exécution ou le jugement.
Cette séparation peut également devenir un mécanisme de sécurité. Avant une action ayant des conséquences, un contrôle distinct peut comparer la mission inférée par l’agent avec l’autorité accordée par l’utilisateur et les preuves disponibles. Dans un processus réglementé, ce contrôle peut être plus utile qu’une étape de raisonnement supplémentaire une fois que l’agent s’est engagé dans une mauvaise direction.
Ce que DAYJOB ne démontre pas
DAYJOB couvre une sélection de workflows de santé et de finance. Il ne permet pas d’établir un taux d’échec unique pour l’ensemble du travail intellectuel. Les déploiements réels diffèrent par leurs outils, leurs données, leurs permissions, leur formation, leurs procédures de revue et leur distribution de tâches.
Un meilleur score ne signifie pas non plus automatiquement un déploiement plus sûr. Un modèle moins performant mais enfermé dans des permissions étroites et des contrôles solides peut être préférable dans un contexte donné. La fiabilité en production dépend du modèle, du harnais agentique, des données, des autorisations et du système de vérification.
La contribution la plus utile de DAYJOB est donc méthodologique : la découverte de la tâche devient elle-même mesurable. À mesure que les agents passent du rôle d’assistant répondant à une demande bien formulée à celui de système responsable d’un résultat, cette couche devient centrale. La question n’est plus seulement de savoir si l’agent sait exécuter un plan, mais s’il sait identifier le bon plan avant de commencer.