
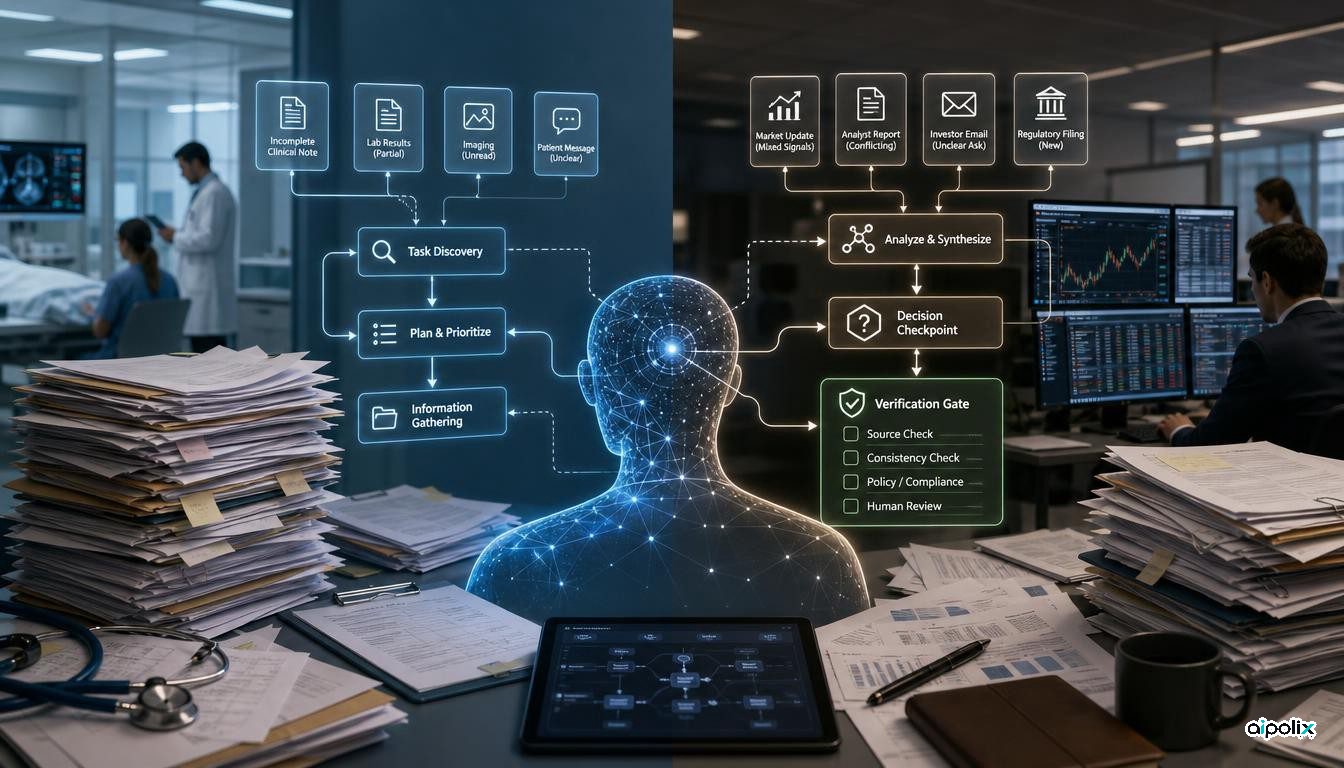
A Surge AI lançou DAYJOB: Healthcare e DAYJOB: Finance, dois benchmarks que colocam na avaliação de agentes uma dificuldade frequentemente removida dos testes: no trabalho real, os pedidos raramente chegam como especificações completas. O agente tem de perceber o que é necessário, identificar informação em falta, escolher ferramentas e produzir um resultado profissional utilizável.
Os primeiros números são um aviso contra a utilização de bons resultados em tarefas muito estruturadas como prova de preparação para o trabalho. A Surge AI afirma que o melhor modelo avaliado conclui com sucesso 24,7% das tarefas de DAYJOB: Healthcare e 23,9% das tarefas de DAYJOB: Finance. São resultados do benchmark publicados pela entidade que o criou, não taxas de falha independentes em produção, mas tornam visível uma diferença importante entre executar instruções claras e assumir responsabilidade por um trabalho.
A ambiguidade passa a fazer parte da tarefa
Muitos benchmarks começam depois de uma pessoa já ter realizado uma das partes mais difíceis: definir o problema com precisão. Um teste de programação pode indicar o erro a corrigir. Um teste de navegação pode dizer qual a informação a obter. Um fluxo de trabalho pode enumerar todas as entradas necessárias. Esta estrutura facilita a medição da execução, mas retira da avaliação a descoberta dos requisitos.
DAYJOB volta a introduzir parte dessa incerteza. As tarefas de saúde abrangem trabalho clínico, operacional, pagadores, farmácia e conformidade. As tarefas financeiras incluem finanças empresariais, banca, crédito, investimento e ativos reais. Em ambos os casos, o agente tem de transformar contexto imperfeito em julgamento profissional e num resultado final.
A análise da Aipolix é que este desenho altera o significado de fiabilidade de um agente. Já não basta saber chamar ferramentas ou raciocinar dentro de um plano conhecido. O agente precisa primeiro de inferir o plano correto, separar informação relevante de ruído, detetar lacunas e perceber o que conta como uma entrega satisfatória. Todas as chamadas de ferramentas podem estar tecnicamente corretas e, ainda assim, o trabalho falhar porque o sistema resolveu o problema errado.
Taxas de sucesso baixas apontam para falhas que se acumulam
A Surge AI agrupa as capacidades expostas pelos ambientes em utilização de ferramentas, planeamento, adaptabilidade, fundamentação e senso comum. A combinação é importante porque um trabalho longo raramente falha por causa de uma única competência. Uma interpretação inicial errada pode produzir um plano inadequado, levar à recolha dos dados errados e terminar numa resposta aparentemente coerente mas inútil.
Na tabela de saúde, Claude Opus 5.5 aparece com 24,7%, GPT-6 Astra com 11,6% e Claude Fable 5.1 com 9,6%. Em finanças, a Surge AI publica 23,9%, 21,5% e 19,8%, respetivamente. Estes valores devem ser interpretados apenas no contexto das tarefas DAYJOB e não como uma classificação universal dos modelos.
Para equipas de engenharia, o nível absoluto é mais importante do que a ordem. Mesmo o melhor resultado deixa a maioria das tarefas sem sucesso segundo os critérios do benchmark. A escalada para pessoas, as verificações intermédias e critérios de aceitação explícitos continuam, por isso, a ser componentes essenciais de um sistema de produção.
Descobrir os requisitos deve tornar-se uma barreira de lançamento
Uma consequência prática é começar a avaliação antes da fase de execução. Uma equipa deve testar se o agente identifica corretamente o resultado pedido, as restrições implícitas, as provas necessárias e as situações em que deve parar e pedir esclarecimentos.
Uma estrutura por camadas pode ser útil. Primeiro mede-se a interpretação: o agente consegue reformular o objetivo e identificar informação em falta? Depois avaliam-se o plano e a seleção de ferramentas. Por fim, o resultado é comparado com critérios profissionais. Se estas etapas forem reduzidas a uma única pontuação, a equipa pode saber que houve uma falha sem perceber se a origem foi compreensão, execução ou julgamento.
A mesma separação pode funcionar como mecanismo de segurança. Antes de uma ação com consequências, um controlo independente pode comparar a tarefa inferida pelo agente com a autoridade concedida pelo utilizador e com as provas disponíveis. Em fluxos regulados, esse ponto de controlo pode valer mais do que acrescentar outra ronda de raciocínio depois de o agente já ter escolhido a direção errada.
O que DAYJOB não demonstra
DAYJOB cobre um conjunto selecionado de fluxos de saúde e finanças. Não estabelece uma taxa de falha única para todo o trabalho de conhecimento. As implementações reais diferem nas ferramentas, qualidade dos dados, permissões, formação, processos de revisão e distribuição das tarefas.
Uma pontuação superior também não significa automaticamente uma implementação mais segura. Um modelo com pontuação inferior, mas com permissões mais limitadas e controlos mais fortes, pode ser mais adequado a uma organização. A fiabilidade em produção resulta da combinação do modelo, do sistema que o envolve, dos dados, das autorizações e da verificação.
O contributo mais útil de DAYJOB é metodológico: a descoberta da própria tarefa passa a fazer parte daquilo que é medido. À medida que os agentes deixam de ser assistentes que respondem a pedidos bem formulados e passam a sistemas responsáveis por resultados, esta camada torna-se central. A pergunta já não é apenas se o agente consegue executar um plano. É se consegue identificar o plano certo antes de começar.