
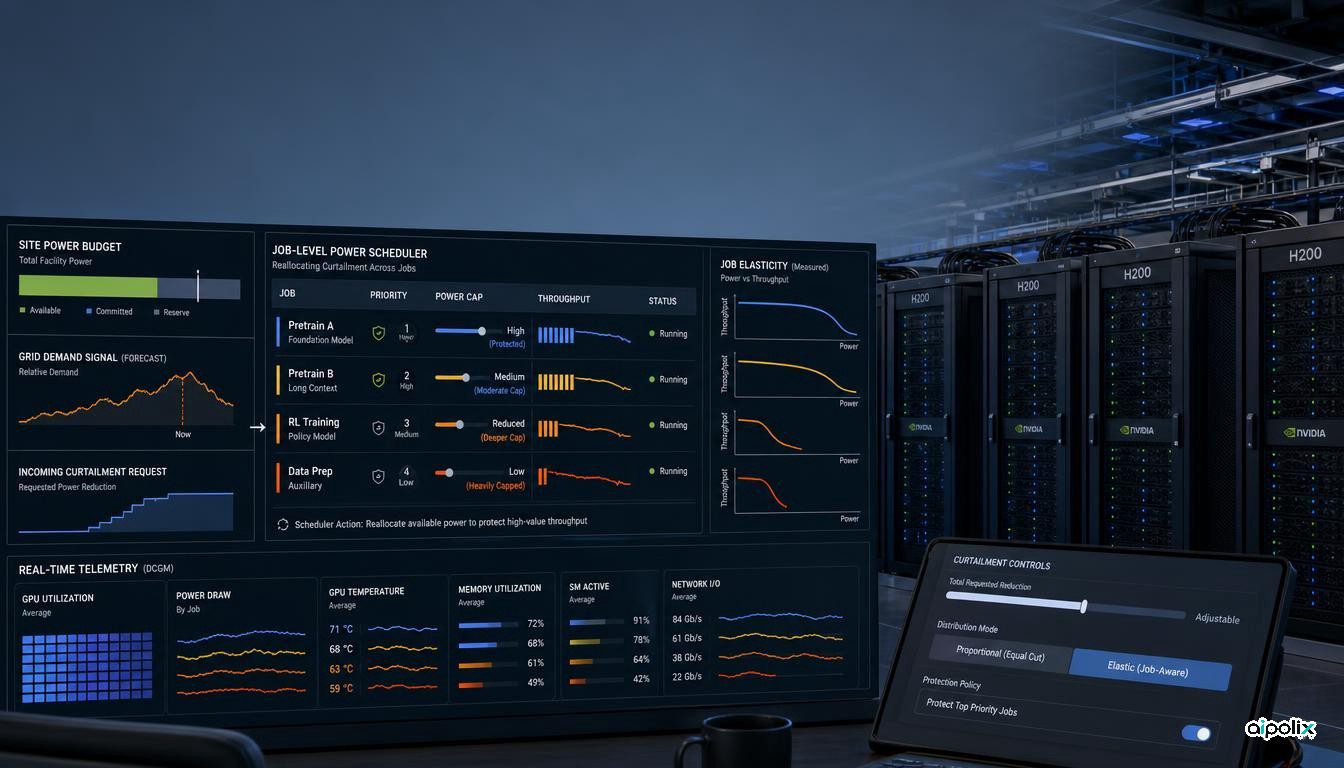
پژوهشی تازه از Emerald AI نشان میدهد انعطافپذیری مصرف برق در آموزش مدلهای هوش مصنوعی را نباید ویژگی یکسان کل خوشه GPU دانست. پژوهشگران بررسی کردهاند وقتی سقف توان GPU کاهش پیدا میکند، سرعت آموزش در کارهای مختلف چه تغییری میکند. داده اصلی آنها از ۱۳۱ اجرای آموزشی روی H200 به دست آمده و با ۲۴ اجرای اعتبارسنجی روی H200 و ۳۴ اجرای متناظر روی H100 تکمیل شده است.
برای مقایسه این رفتار، مقاله شاخصی به نام PFI معرفی میکند. هدف این شاخص مشخص کردن کارهایی است که میتوانند کاهش توان را با افت کمتر سرعت تحمل کنند. این موضوع برای مراکز داده مهم است، چون تقسیم یکسان محدودیت برق میان همه کارها لزوماً بهترین نتیجه را نمیدهد.
یک سقف توان واحد روی همه کارها اثر یکسان ندارد
آزمایشها شامل مدلهای متراکم و MoE، پیشآموزش و تنظیم تکمیلی و خوشههایی تا ۳۲ پردازنده H200 هستند. در پیکربندیهای اصلی H200، مقدار PFI از ۱٫۱۰ تا ۲٫۶۷ تغییر کرده است. بعضی کارهای تنظیم تکمیلی با معماری MoE انعطاف بیشتری نشان دادهاند، در حالی که تعدادی از کارهای متراکم با کاهش توان، افت سرعت بیشتری داشتهاند.
PFI نسبت میان کاهش توان و افت سرعت را به شکلی نرمالشده بیان میکند. مقدار بالاتر یعنی میتوان توان بیشتری کم کرد بیآنکه سرعت آموزش به همان نسبت افت کند. نکته مهم برای بهرهبردار این است که دو کار با مصرف اسمی مشابه ممکن است زیر یک سقف توان واحد رفتار کاملاً متفاوتی داشته باشند.
نویسندگان شش گروه کاری را روی H100 نیز تکرار کردهاند. ترتیب نسبی انعطافپذیری تا حد زیادی حفظ شده و همبستگی رتبهای ۰٫۹۴۳ گزارش شده است. با این حال خود مقاله تأکید میکند تعداد آزمایشهای H100 برای نتیجهگیری عمومی کافی نیست.
دادههای پایش GPU شاید برای رتبهبندی کافی باشند، اما نمونه هنوز کوچک است
اجرای مجموعه کامل آزمایشهای کاهش توان برای هر کار تولیدی هزینهبر است. پژوهشگران به همین دلیل بررسی کردهاند آیا میتوان PFI را از دادههای معمول پایش GPU تخمین زد. در میان متغیرهای بررسیشده، ترکیبی از فعالیت DRAM و میزان کپی حافظه بهترین پیشبینی ساده را ارائه کرده است.
اما مدل پیشبینی هنوز روی داده محدودی ساخته شده است: فقط ۲۵ نمونه PFI که از ۱۳۱ اجرای اصلی استخراج شدهاند. ضریب تعیین در ارزیابی leave-one-out برابر ۰٫۵۲۴ است و در ارزیابی سختگیرانهتر leave-one-cluster-out به ۰٫۲۴۶ کاهش مییابد. نویسندگان صریحاً میگویند با این حجم داده نمیتوان مدلهای پیچیدهتر را توجیه کرد.
برای یک زمانبند واقعی، همین محدودیت اهمیت زیادی دارد. اگر یک کار حساس اشتباهاً انعطافپذیر تشخیص داده شود، ممکن است کاهش توان بیشتری دریافت کند و هدف سرعت یا زمانبندی آن نقض شود. بنابراین شواهد فعلی PFI را بهعنوان یک سیگنال امیدوارکننده مطرح میکنند، نه یک پیشبینیگر عمومی برای هر شتابدهنده و هر نوع آموزش.
در شبیهسازی، انتخاب هوشمند محل کاهش توان بهتر از تقسیم مساوی بود
برای سنجش اثر این تفاوتها، پژوهشگران ۵۰۰ بار کاری مصنوعی با ۱۰۰ کار در هر بار شبیهسازی کردهاند. روشهای مختلف تخصیص محدودیت برق با یکدیگر مقایسه شدهاند؛ از کاهش متناسب برای همه کارها تا روش مبتنی بر PFI و یک حالت ایدهآل که منحنی کامل توان و سرعت هر کار را میداند.
در ترکیبی که قرار است به بار تولیدی نزدیک باشد، با کاهش ۳۰ درصدی توان کل خوشه، روش مبتنی بر PFI حدود ۱٫۵ هزار توکن بر ثانیه به ازای هر کار بیشتر از روش تقسیم مساوی حفظ کرده است. طبق گزارش مقاله، این مقدار ۶۳ درصد فاصله میان روش مساوی و حالت ایدهآل را جبران میکند.
این نتیجه نباید با عملکرد اثباتشده در مرکز داده واقعی اشتباه گرفته شود. آزمایش زمانبندی از شبیهسازی و همان منحنیهای اندازهگیریشده استفاده میکند. نویسندگان نیز اعتبارسنجی حلقهبسته روی بارهای جدید و خارج از مجموعه فعلی را به کار آینده موکول کردهاند.
برای مدیریت برق باید خودِ کار آموزشی را شناخت، نه فقط تعداد GPUها را
برداشت Aipolix این است که ارزش اصلی مقاله در تغییر واحد تصمیمگیری است. جملهای مثل «این خوشه میتواند ۲۰ درصد از مصرفش را کم کند» بهتنهایی کافی نیست، چون هزینه عملکردی این کاهش به ترکیب کارهایی بستگی دارد که همان لحظه در حال اجرا هستند.
در یک سامانه عملی، زمانبند میتواند انعطافپذیری برق را در کنار اولویت، مهلت، تعداد GPU و محل اجرا بهعنوان یکی از ویژگیهای هر کار نگه دارد. هنگام محدودیت شبکه یا سقف توان مرکز داده، کاهش بیشتری به کارهایی اعمال شود که قبلاً نشان دادهاند با افت توان، سرعت کمتری از دست میدهند و کارهای حساستر محافظت شوند.
این نکته روی قراردادهای «محاسبات انعطافپذیر» هم اثر دارد. مقدار توان قابل کاهش را نمیتوان فقط از ظرفیت نصبشده یا تعداد GPU محاسبه کرد. ظرفیت واقعاً قابلاستفاده به ترکیب بار کاری وابسته است و با تغییر آن تغییر میکند. بنابراین زمانبند به داده تازه و رفتار محافظهکارانه در شرایط نامطمئن نیاز دارد.
همچنین نباید یک مقدار PFI را برای همیشه به یک خانواده مدل نسبت داد. مقاله نشان میدهد نوع کار، مقیاس و تنظیمات اجرا بر نتیجه اثر میگذارند و حتی شبکه نقاطی که برای آزمایش سقف توان انتخاب میشود روی مقدار مطلق شاخص اثر دارد.
فاصله میان توان GPU و مصرف واقعی مرکز داده هنوز مهم است
آزمایش اصلی به H200 روی گرههای a3-ultragpu-8g گوگل کلاد محدود است و کنترل توان با nvidia-smi -pl انجام شده است. اجراها شامل پیشآموزش و تنظیم تکمیلی LoRA با رتبه ۳۲ و بازههای ۳۰ دقیقهای هستند.
اندازهگیری توان فقط مصرف مجموع GPUها را پوشش میدهد. مصرف CPU، حافظه اصلی، شبکه، منبع تغذیه، فنها و سرمایش رک در این عدد نیست. برای ادعای پاسخگویی به شبکه برق، این تفاوت مهم است؛ کاهش توان برد GPU الزاماً برابر با همان مقدار کاهش در کنتور مرکز داده نیست.
مقاله همچنین محدودیت ۲۵ نمونه PFI را میپذیرد و میگوید نتیجه شبیهسازی زمانبندی هنوز باید در کنترل حلقهبسته و روی بارهای جدید آزمایش شود. شتابدهندههای ناهمگون، RLHF و inference نیز در این کار پوشش داده نشدهاند.
در نتیجه، یافته محکمتر مقاله این است که کارهای آموزشی هوش مصنوعی از نظر حساسیت به کاهش توان یکسان نیستند و این تفاوت را میتوان اندازه گرفت. تبدیل این ایده به ظرفیت قابلاعتماد برای شبکه برق هنوز به آزمایش گستردهتر، اندازهگیری کل مرکز داده و زمانبند واقعی نیاز دارد.