
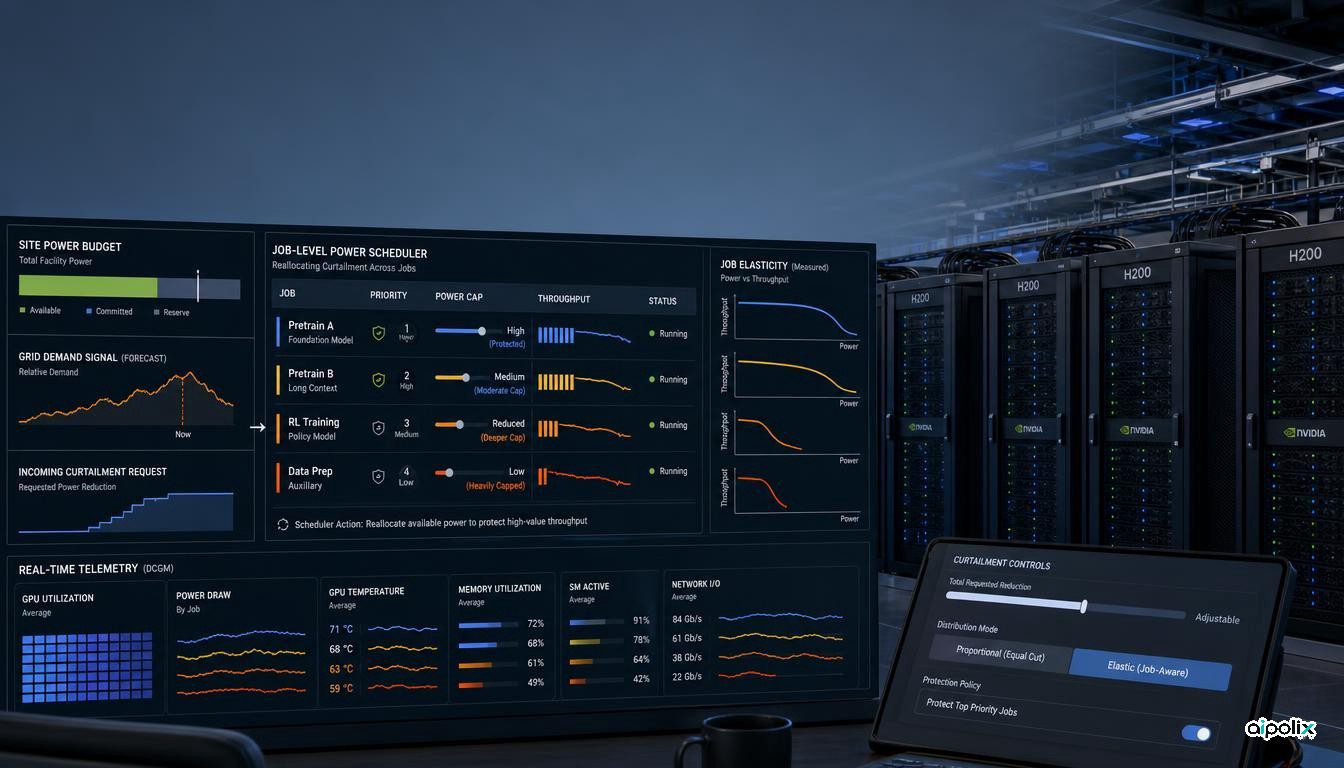
Um estudo da Emerald AI propõe que a flexibilidade elétrica do treino de IA seja tratada como uma propriedade de cada tarefa, e não como uma capacidade uniforme de todo o cluster de GPU. Os investigadores mediram a alteração do débito quando a potência disponível é reduzida em 131 execuções de treino com H200, acrescentando 24 execuções de validação em H200 e 34 testes correspondentes em H100.
O trabalho apresenta o Power Flexibility Index, ou PFI, para identificar as tarefas que conseguem aceitar uma redução de potência com menor perda de desempenho. A distinção é relevante para centros de dados sujeitos a limites elétricos: aplicar a mesma redução a todas as tarefas pode penalizar as cargas mais sensíveis e desperdiçar flexibilidade nas restantes.
A mesma redução de potência tem custos diferentes consoante a tarefa
A experiência inclui modelos densos e modelos MoE, pré-treino e afinação, com grupos até 32 GPU H200. Nas configurações principais, o PFI varia entre 1,10 e 2,67. Algumas tarefas de afinação com MoE mostraram maior capacidade para tolerar limites de potência, enquanto vários treinos densos perderam mais débito.
O PFI relaciona a redução de potência com a perda de desempenho. Um valor mais elevado indica que é possível cortar mais potência com uma penalização proporcionalmente menor. Para quem opera o cluster, o ponto essencial é que duas tarefas com consumos nominais semelhantes podem reagir de forma muito diferente ao mesmo limite.
Os autores repetiram seis grupos de testes em H100. A ordem relativa manteve-se em grande parte, com uma correlação de Spearman de 0,943 entre H100 e H200. O próprio artigo, porém, avisa que a amostra H100 é demasiado pequena para sustentar uma generalização ampla.
A telemetria pode ajudar a ordenar a flexibilidade, mas a previsão ainda tem poucos dados
Executar vários limites de potência para cada tarefa em produção seria dispendioso. Por isso, o estudo procura estimar o PFI a partir da telemetria normal dos GPU. O melhor indicador simples encontrado combina sinais de atividade da DRAM e de cópia de memória.
A base continua pequena. O modelo de previsão utiliza apenas 25 amostras de PFI derivadas das 131 execuções principais. O R² em leave-one-out é 0,524 e desce para 0,246 quando a validação exclui um grupo completo de arquitetura e tarefa. Os autores afirmam que este volume de dados ainda não permite justificar modelos preditivos mais complexos.
Num escalonador real, uma classificação errada pode ter consequências operacionais. Se uma tarefa pouco flexível for considerada tolerante ao corte, pode receber uma redução excessiva e falhar a meta de débito. Assim, o PFI é um sinal útil para investigação e controlo, mas ainda não um preditor universal para qualquer hardware ou carga.
Na simulação, direcionar os cortes preservou mais débito
Os investigadores simularam 500 conjuntos de trabalho com 100 tarefas cada e compararam diferentes formas de distribuir uma redução global de potência. Uma estratégia reparte o corte proporcionalmente, outra utiliza o PFI e uma referência ideal conhece antecipadamente toda a curva de potência e desempenho de cada tarefa.
No cenário que procura representar uma mistura de produção, uma redução global de 30 % permitiu à estratégia baseada em PFI recuperar cerca de 1,5 mil tokens por segundo por tarefa em relação à distribuição uniforme. Segundo o artigo, isso corresponde a 63 % da diferença entre a estratégia uniforme e o caso ideal.
Este resultado não deve ser apresentado como ganho comprovado num centro de dados real. A avaliação do escalonamento é uma simulação construída com as mesmas curvas de potência e desempenho usadas para caracterizar as tarefas. Os autores deixam para trabalho futuro a validação em ciclo fechado com cargas fora da amostra.
A unidade de controlo deve ser a tarefa, não apenas o GPU
A análise da Aipolix é que a principal consequência prática está no desenho do controlo. Dizer que um cluster consegue reduzir 20 % da potência esconde uma variável decisiva: o custo de desempenho depende das tarefas que estiverem em execução naquele momento.
Um escalonador de produção poderia tratar a flexibilidade elétrica como mais um atributo da tarefa, juntamente com prioridade, prazo, número de GPU e localização. Perante uma limitação do local ou um pedido da rede, poderia aplicar cortes maiores às tarefas que demonstraram menor sensibilidade e proteger as que perdem desempenho rapidamente.
Isso também altera a forma de definir contratos de computação flexível. A capacidade útil de redução não deve ser calculada apenas a partir dos megawatts instalados ou do número de GPU. Depende da composição da carga e muda com ela. O sistema precisa, por isso, de telemetria atual e de um comportamento conservador quando a elasticidade não está bem estimada.
O PFI também não deve ser tratado como uma característica permanente de uma família de modelos. O artigo mostra diferenças com a tarefa, a escala e a configuração, e o apêndice indica que o valor absoluto do índice depende da grelha de limites de potência usada na medição.
A potência dos GPU ainda não é a potência total do centro de dados
A experiência principal está limitada a H200 em nós a3-ultragpu-8g da Google Cloud e usa nvidia-smi -pl para controlar a potência. Os testes abrangem pré-treino e afinação LoRA de rank 32 em períodos de 30 minutos.
A medição inclui a potência agregada dos GPU, mas não contabiliza CPU, memória principal, rede, fontes de alimentação, ventoinhas ou refrigeração ao nível do rack. Para afirmações relacionadas com resposta à rede elétrica, esta diferença é importante: uma redução na potência das placas GPU não equivale necessariamente à mesma redução no contador do centro de dados.
Os autores também reconhecem que as 25 amostras de PFI limitam a generalização e que o escalonamento continua por validar em ciclo fechado. Aceleradores heterogéneos, RLHF e inferência ficam igualmente fora do estudo atual.
A conclusão mais robusta é, portanto, mais específica: tarefas de treino de IA têm sensibilidades diferentes à redução de potência, e essa diferença pode ser medida. Transformar esse resultado numa capacidade previsível para a rede elétrica exigirá mais tipos de carga, medição de toda a instalação e validação com um escalonador real.