
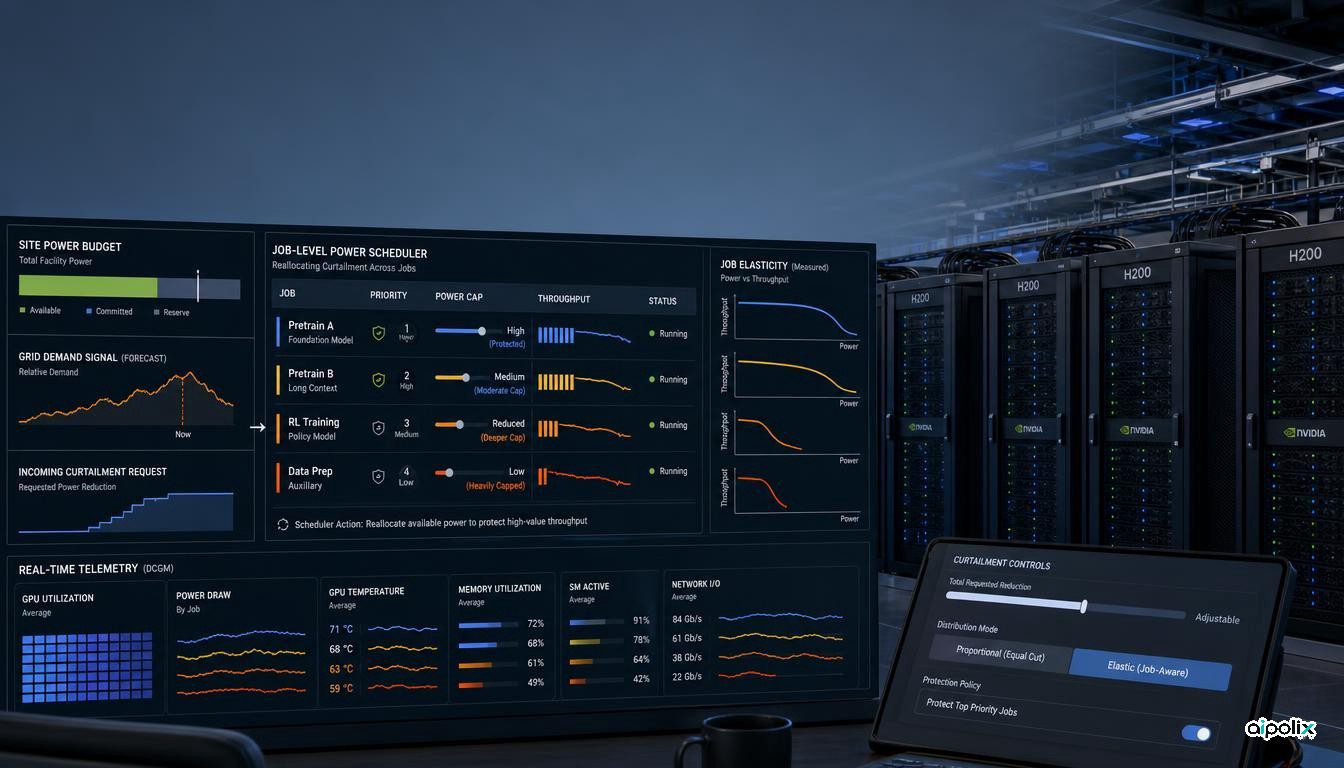
Une étude d'Emerald AI propose de considérer la flexibilité électrique de l'entraînement d'IA comme une propriété de chaque tâche, et non comme une capacité uniforme d'un cluster de GPU. Les chercheurs ont mesuré l'évolution du débit lorsque la puissance disponible est réduite sur 131 exécutions d'entraînement H200, complétées par 24 exécutions de validation H200 et 34 essais correspondants sur H100.
Ils introduisent un indicateur appelé Power Flexibility Index, ou PFI, destiné à repérer les tâches qui supportent une baisse de puissance avec la plus faible perte de débit. Cette distinction est importante pour les centres de données confrontés à une contrainte électrique : appliquer la même réduction à tous les travaux peut pénaliser inutilement les charges les plus sensibles.
Une même baisse de puissance ne coûte pas la même chose à chaque tâche
L'étude couvre des modèles denses et à mélange d'experts, du préentraînement et de l'ajustement, sur des groupes allant jusqu'à 32 GPU H200. Dans les configurations principales, le PFI mesuré varie de 1,10 à 2,67. Certaines tâches d'ajustement de modèles MoE sont nettement plus flexibles que plusieurs entraînements denses.
Le PFI rapporte la réduction de puissance à la perte de débit. Une valeur plus élevée indique qu'une tâche peut absorber une limitation de puissance avec une dégradation proportionnellement plus faible. Pour l'exploitation, le point essentiel est que deux tâches ayant une consommation nominale comparable peuvent réagir très différemment au même plafond.
Les auteurs ont aussi reproduit six groupes d'expériences sur H100. L'ordre relatif est largement conservé, avec une corrélation de Spearman annoncée à 0,943 entre H100 et H200. Ils précisent néanmoins que cet échantillon H100 est trop petit pour permettre une généralisation large.
La télémétrie peut aider à classer les tâches, mais le modèle prédictif reste limité
Effectuer un balayage complet de plusieurs plafonds de puissance pour chaque tâche en production serait coûteux. Les chercheurs évaluent donc la possibilité d'estimer le PFI à partir de la télémétrie GPU courante. Leur meilleur prédicteur simple combine des signaux liés à l'activité DRAM et aux copies mémoire.
La base statistique reste toutefois réduite : le modèle repose sur 25 valeurs de PFI issues des 131 exécutions principales. Le R² en validation leave-one-out atteint 0,524, mais tombe à 0,246 lorsque les auteurs retirent un groupe complet d'architecture et de tâche. Ils indiquent eux-mêmes que ce volume de données ne justifie pas des modèles prédictifs plus complexes.
Pour un ordonnanceur réel, l'erreur de classement compte davantage qu'une simple corrélation moyenne. Une tâche peu flexible mal identifiée pourrait recevoir une réduction trop forte et manquer son objectif de débit. Le PFI est donc un signal prometteur à évaluer, pas encore un prédicteur universel validé pour toutes les architectures et tous les accélérateurs.
L'allocation ciblée conserve davantage de débit dans la simulation
Les chercheurs simulent ensuite 500 ensembles de 100 tâches et comparent plusieurs stratégies de réduction de puissance. L'une répartit la contrainte proportionnellement, une autre utilise le PFI, et une référence idéale connaît à l'avance la courbe complète puissance-performance de chaque tâche.
Dans le scénario censé se rapprocher d'un mélange de production, une réduction globale de 30 % permet à la stratégie fondée sur le PFI de récupérer environ 1,5 millier de jetons par seconde et par tâche par rapport à la répartition uniforme. Les auteurs estiment que cela ferme 63 % de l'écart de débit entre cette répartition simple et l'oracle.
Cette valeur ne constitue pas une démonstration en centre de données réel. L'expérience d'ordonnancement est une simulation construite à partir des mêmes courbes puissance-débit que celles utilisées pour caractériser les tâches. Les auteurs laissent à des travaux futurs la validation en boucle fermée sur des charges hors échantillon.
La bonne unité de décision est la tâche, pas seulement le GPU
L'analyse d'Aipolix est que le résultat le plus utile concerne l'architecture du contrôle. Affirmer qu'un cluster peut réduire sa consommation de 20 % masque le coût réel : celui-ci dépend des tâches en cours au moment où la contrainte arrive.
Un ordonnanceur de production pourrait traiter la flexibilité électrique comme un attribut de tâche, au même titre que la priorité, l'échéance, le nombre de GPU ou le placement. Pendant un événement réseau ou une limite de puissance du site, il pourrait réduire davantage les tâches dont la sensibilité mesurée est faible et protéger celles dont le débit chute rapidement.
Cela modifie aussi la manière de formuler une offre de calcul flexible. La capacité de réduction utile ne peut pas être déduite uniquement des mégawatts installés ou du nombre de GPU. Elle dépend du mélange de charges et varie avec lui. Il faut donc une télémétrie récente et un comportement prudent lorsque l'élasticité est mal connue.
Le PFI ne devrait pas non plus devenir une étiquette permanente attachée à une famille de modèles. L'étude montre des effets liés à la tâche, à l'échelle et à la configuration, et son annexe indique que la valeur absolue dépend aussi de la grille de plafonds utilisée pour la mesure.
La mesure GPU ne représente pas encore toute la consommation du site
Les expériences principales se limitent aux H200 sur des nœuds Google Cloud a3-ultragpu-8g, avec nvidia-smi -pl comme mécanisme de contrôle. Elles portent sur le préentraînement et l'ajustement LoRA de rang 32 pendant des séquences de 30 minutes.
La puissance mesurée correspond aux GPU agrégés. Les CPU hôtes, la mémoire principale, le réseau, les alimentations, les ventilateurs et le refroidissement de la baie ne sont pas inclus. Pour une utilisation en réponse au réseau électrique, cette différence est importante : réduire la puissance des cartes GPU ne garantit pas une baisse identique au compteur du centre de données.
Les auteurs reconnaissent également que 25 valeurs de PFI limitent la généralisation et que l'ordonnancement n'a pas encore été validé en boucle fermée. Les accélérateurs hétérogènes, le RLHF et l'inférence restent hors du périmètre.
La conclusion la plus solide est donc plus étroite : les tâches d'entraînement d'IA présentent des élasticités électriques différentes et cette différence est mesurable. En faire une capacité fiable pour le réseau nécessitera encore des charges plus variées, des mesures de bout en bout du site et une validation avec un ordonnanceur réel.