
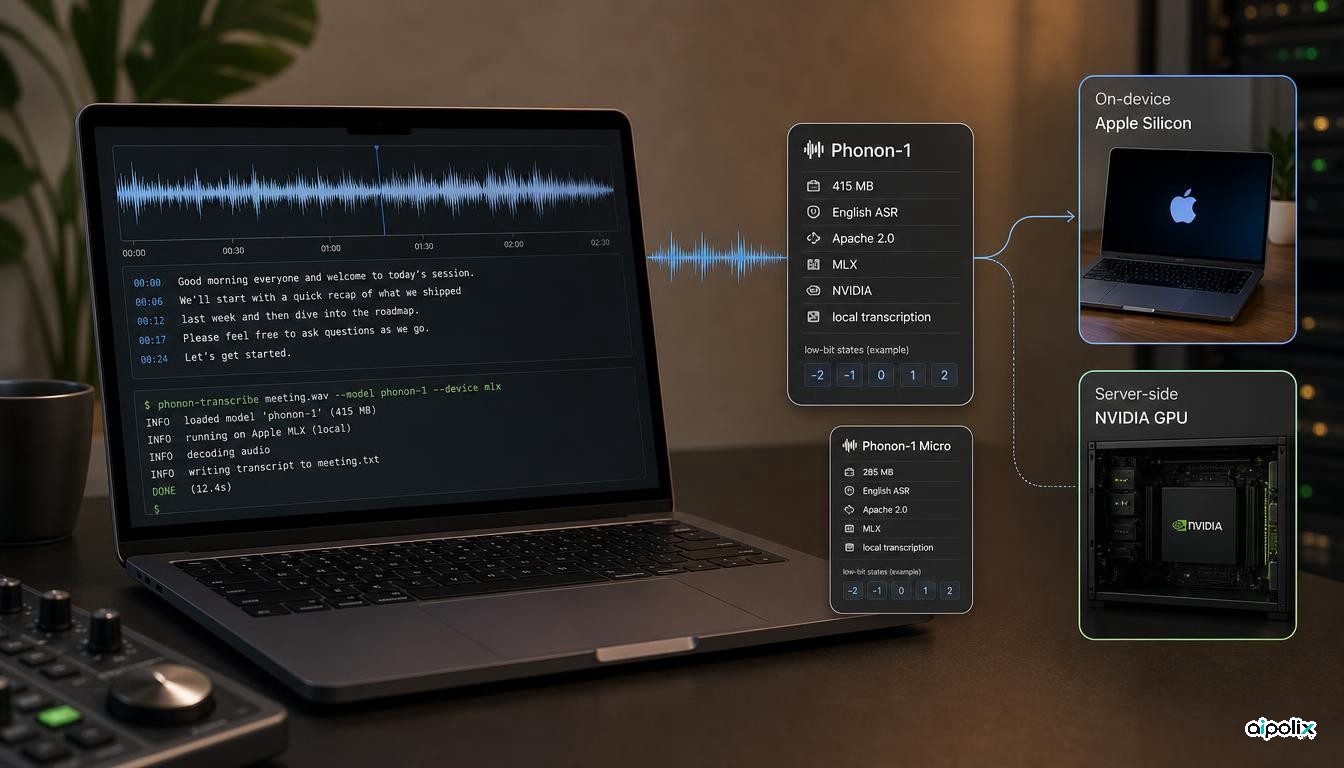
Fermion Research مدل Phonon-1 را منتشر کرده است؛ یک سامانهٔ فشردهٔ بازشناسی خودکار گفتار انگلیسی که هم روی رایانهٔ کیفی و هم روی پردازندههای گرافیکی مرکز دادهٔ NVIDIA اجرا میشود. مدل پیشفرض در 415 MB بارگیری میشود، تحت Apache 2.0 مجوز دارد و از ابزارهای خط فرمان Fermion یا از یک نقطهٔ دسترسی رونویسی سازگار با OpenAI قابل استفاده است.
اهمیت این عرضه در پر کردن شکافی عملی میان مدلهای بسیار کوچک گفتار محلی و سامانههای رونویسی بزرگتری است که ذخیره یا محاسبهٔ بهمراتب بیشتری میطلبند. Fermion میگوید Phonon-1 از Qwen3-ASR-0.6B و با رویکرد آموزش کمبیت ساخته شده، نه با کمیسازی معمولی پس از تکمیل مدل. شناسنامهٔ مدل در Hugging Face آن را برای تبدیل گفتار انگلیسی به متن، Apple Silicon و استفادهٔ کمبیت روی دستگاه فهرست میکند.
مدل 415 MB ساختهشده حول آموزش کمبیت
Fermion، Phonon-1 را مدلی توصیف میکند که از ابتدا با 2.4 bits بهازای هر وزن رمزگشا آموزش دیده است. شرکت میگوید مصنوع کامل بهطور میانگین 4.65 bits per parameter دارد و رمزگشای کمبیت با پنج حالت آموختهشده بازنمایی میشود. هدف این است که دقت مدل معلم بیش از تبدیل کمبیت متعارف پس از آموزش حفظ شود.
ساخت پیشفرض Phonon-1 برابر 415 MB است. Fermion همچنین Phonon-1 Micro را با حجم کوچکتر 285 MB و یک ساخت بزرگتر Big فراهم میکند. مدل پیشفرض برای توسعهدهندگان نقطهٔ مرجع جذابتری است، چون بهعنوان تعادل میان حجم، دقت و تأخیر مطرح شده است.
وزنها و ابزار خط فرمان تحت Apache 2.0 توزیع میشوند. Fermion اعلام میکند مدل پایه، یعنی Qwen3-ASR-0.6B، نیز Apache 2.0 است. این موضوع ارزیابی را برای بارهای کاری داخلی و تجاری آسانتر از مدلهایی میکند که شرایط سفارشی محدودکنندهتری دارند؛ هرچند سازمانها همچنان باید بازبینی معمول مجوز و انطباق را انجام دهند. مجوز سهلگیرتر مانع نیاز به آن بازبینی نمیشود، فقط مقایسهٔ حقوقی را نسبت به شرایط اختصاصی تنگتر سادهتر میکند.
جدولهای Fermion چه نشان میدهند
در ارزیابی منتشرشده، Fermion نرخ خطای واژهٔ 2.640 percent را روی LibriSpeech test-clean و 5.699 percent را روی test-other برای مدل 415 MB گزارش میکند. نتایج TED-LIUM، SPGISpeech، VoxPopuli، GigaSpeech، Earnings-22 و AMI نیز منتشر شدهاند و میانگین کلان هشت معیار برابر 7.67 است.
این ارقام امیدوارکنندهاند، اما قرائن نیازمند تفسیر محتاطانهاند. Fermion صریحاً بیشتر خانههای مقایسه را اندازهگیریهای تیم خود با مجموعههای کامل آزمون، هنجارساز متن انگلیسی Whisper و رمزگشایی حریصانه علامت میزند. برخی ارقام رقبا از شناسنامهٔ مدلها یا جدولهای ردهبندی منتشرشده گرفته شدهاند و بسیاری دوباره با پروتکل Fermion اندازهگیری شدهاند.
Fermion همچنین میگوید در پنج معیار دنیای واقعی نتوانسته مدل قابلبارگیریای بیابد که هم کوچکتر و هم دقیقتر از Phonon-1 باشد. این ادعای فروشنده است بر پایهٔ مجموعه و پروتکل انتخابی شرکت، نه نتیجهای پیشرو که مستقلاً تثبیت شده باشد. همان صفحه یادآور میشود مدل Parakeet-0.6B 4-bit شرکت NVIDIA در هر هشت معیار جدول Fermion دقیقتر است، اما بارگیری بزرگتری دارد.
استقرار محلی بخشی از محصول است
Phonon-1 تنها یک عرضه در شناسنامهٔ مدل نیست. بستهٔ fermion-research در PyPI گردشکاری محلی با fermion transcribe برای پروندههای صوتی و fermion serve برای مسیر سازگار با OpenAI در /v1/audio/transcriptions در اختیار میگذارد. کاربردهای موجود که حول کارخواههای رونویسی به سبک OpenAI ساخته شدهاند، میتوانند بهجای یکپارچهسازی کاملاً متفاوت، به یک کارساز محلی اشاره کنند.
Fermion میگوید همان وزنها از طریق MLX روی Apple Silicon و از طریق محیط اجرای GPU اختصاصی NVIDIA اجرا میشوند. شرکت سرعت رمزگشایی میانهٔ 23.9 برابر زمان واقعی را در نه پیکره روی یک M5 MacBook Air پایه گزارش میکند؛ که تقریباً معادل رونویسی یک ساعت صدا در حدود دو و نیم دقیقه است. همچنین تأخیر میانهٔ چندصد میلیثانیهای برای دیکتهٔ زنده گزارش شده است.
این ارقام سرعت نیز اندازهگیریهای خود Fermion هستند. گذردهی واقعی به طول صدا، دستهبندی، سختافزار، فشار حافظه، نسخهٔ محیط اجرا و ویژگیهای ورودی بستگی دارد.
تیمها کجا باید محتاط باشند
محدودیت اصلی پنهان نیست: این مدل ASR متمرکز بر انگلیسی است و انتظار صدای 16 kHz دارد. سازمانهایی که با چند زبان کار میکنند به مدل دیگری یا راهبرد مسیریابی نیاز خواهند داشت. تیمهایی که در جلسات پرنویز، گفتار لهجهدار، تلفن، واژگان تخصصی یا صدای حوزهای فعالیت میکنند نیز نباید مستقیماً از LibriSpeech یا یک میانگین کلان تعمیم دهند.
هنوز بازتولید مستقلی برای مهمترین ادعاهای عملکرد وجود ندارد. Hugging Face و PyPI تأیید میکنند که مصنوعات و ابزار در دسترسند، اما اینها سطوح توزیع تحت کنترل Fermion هستند، نه ارزیاب مستقل.
برای توسعهدهندگان، این موضوع عرضه را بیاهمیت نمیکند؛ گام بعدی درست را تغییر میدهد. Phonon-1 را باید مدل باز فشردهای دانست که بهاندازهٔ کافی ملموس است تا فوراً سنجیده شود، نه جدولی که بهجای آزمون بنشیند. ارزیابی مفید، نرخ خطای واژه، کیفیت نشانهگذاری، رفتار جریانی، مصرف حافظه و تأخیر سرتاسری را روی ضبطها و سختافزار هدف سازمان مقایسه میکند.
اگر آن نتایج پایدار بمانند، ترکیب بارگیری 415 MB، مجوز سهلگیر، اجرای محلی و API سازگار با OpenAI میتواند Phonon-1 را به لایهٔ گفتاری عملی برای ابزارهای رومیزی، سامانههای رونویسی خصوصی و کاربردهای هوش مصنوعی محلیمحور بدل کند. جدول معیار دلیل آزمون است، نه جایگزین آزمون.