
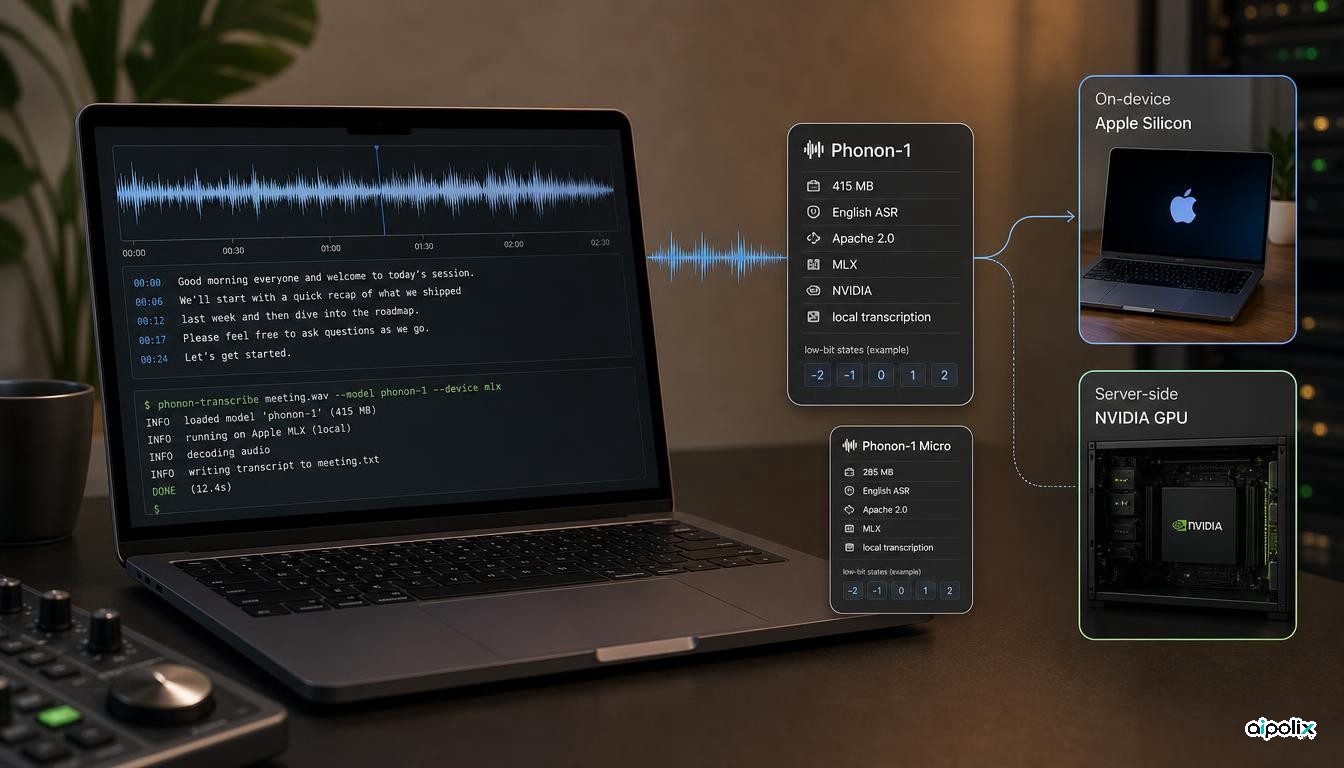
A Fermion Research lançou o Phonon-1, um modelo compacto de reconhecimento automático de fala em inglês, concebido para correr localmente num portátil e também em GPU de centro de dados NVIDIA. O modelo predefinido descarrega-se em 415 MB, está licenciado sob Apache 2.0 e pode usar-se através das ferramentas de linha de comandos da Fermion ou de um ponto de acesso de transcrição compatível com a OpenAI.
O lançamento interessa porque visa uma lacuna prática entre modelos de fala locais muito pequenos e sistemas de transcrição maiores, que exigem substancialmente mais armazenamento ou cálculo. A Fermion afirma que o Phonon-1 foi treinado a partir do Qwen3-ASR-0.6B com uma abordagem de treino a baixa profundidade de bits, em vez de aplicar uma quantização ordinária depois de o modelo estar concluído. A ficha do modelo no Hugging Face lista-o para conversão de fala inglesa em texto, Apple Silicon e uso a baixa profundidade de bits no dispositivo.
Um modelo de 415 MB construído em torno do treino a baixa profundidade de bits
A Fermion descreve o Phonon-1 como um modelo treinado a 2.4 bits por peso do descodificador desde o início. A empresa diz que o artefacto completo tem em média 4.65 bits per parameter e que o descodificador de baixa profundidade é representado com cinco estados aprendidos. A intenção é preservar mais da exactidão do modelo professor do que uma conversão convencional a baixa profundidade feita após o treino.
A construção predefinida do Phonon-1 tem 415 MB. A Fermion também disponibiliza o Phonon-1 Micro, uma variante mais pequena de 285 MB, e uma construção Big maior. O modelo predefinido é o ponto de referência mais interessante para programadores, porque é posicionado como equilíbrio entre tamanho, exactidão e latência.
Os pesos e as ferramentas de linha de comandos são distribuídos sob Apache 2.0. A Fermion declara que o modelo de base, o Qwen3-ASR-0.6B, também é Apache 2.0. Isso facilita avaliar o lançamento para cargas de trabalho internas e comerciais do que modelos com termos personalizados mais restritivos, embora as organizações devam mesmo assim proceder à verificação habitual de licença e conformidade.
O que mostram as medições da Fermion
Na avaliação publicada, a Fermion reporta uma taxa de erro de palavra de 2.640 percent no LibriSpeech test-clean e 5.699 percent no test-other para o modelo de 415 MB. Publica também resultados para TED-LIUM, SPGISpeech, VoxPopuli, GigaSpeech, Earnings-22 e AMI, com uma taxa macro de oito testes de 7.67.
Esses números são promissórios, mas os indícios exigem interpretação cuidadosa. A Fermion marca explicitamente a maior parte das células de comparação como medições da própria equipa, usando conjuntos de teste completos, o normalizador de texto inglês do Whisper e descodificação gananciosa. Algumas figuras de concorrentes vêm de fichas de modelo ou classificações publicadas, enquanto muitas foram refeitas pela Fermion segundo o seu protocolo.
A Fermion afirma ainda que, em five testes do mundo real, não encontrou um modelo descarregável que fosse ao mesmo tempo mais pequeno e mais exacto do que o Phonon-1. Trata-se de uma alegação do fornecedor, baseada no conjunto de comparação e no protocolo escolhidos pela empresa, não de um resultado de fronteira estabelecido de forma independente. A página nota também que o modelo Parakeet-0.6B 4-bit da NVIDIA é mais exacto nos oito testes da tabela da Fermion, mas tem um descarregamento maior.
A instalação local faz parte do produto
O Phonon-1 não é apenas um lançamento de ficha de modelo. O pacote fermion-research no PyPI expõe um fluxo de trabalho local com fermion transcribe para ficheiros de áudio e fermion serve para um percurso /v1/audio/transcriptions compatível com a OpenAI. Aplicações já construídas em torno de clientes de transcrição ao estilo da OpenAI podem portanto apontar para um servidor local, em vez de exigirem uma integração de cliente completamente diferente.
A Fermion diz que os mesmos pesos correm através de MLX em Apple Silicon e através do seu ambiente de execução em GPU NVIDIA. A empresa reporta uma velocidade mediana de descodificação de 23.9 vezes o tempo real em nine corpora num M5 MacBook Air de base, o que corresponderia a transcrever cerca de uma hora de áudio em cerca de dois minutos e meio. Reporta também latência mediana de algumas centenas de milissegundos para ditado ao vivo.
Estas figuras de velocidade são, novamente, medições da própria Fermion. O débito real dependerá da duração do áudio, do agrupamento, do equipamento, da pressão de memória, da versão do ambiente de execução e das características da entrada.
Onde as equipas devem ser cautelosas
A limitação principal não está escondida: trata-se de um modelo de reconhecimento de fala centrado no inglês, que espera áudio a 16 kHz. Organizações que trabalham em várias línguas precisarão de outro modelo ou de uma estratégia de encaminhamento. Equipas que operam em reuniões ruidosas, fala sotaqueada, telefonia, vocabulário especializado ou áudio de domínio específico também devem evitar extrapolar directamente a partir do LibriSpeech ou de uma média macro.
Ainda não há reprodução independente das alegações de desempenho mais importantes. O Hugging Face e o PyPI confirmam que os artefactos e as ferramentas estão disponíveis, mas são superfícies de distribuição controladas pela Fermion, não avaliadores independentes.
Para os programadores, isso não torna o lançamento desinteressante. Muda o passo seguinte correcto. O Phonon-1 deve ser tratado como um modelo aberto compacto, concreto o suficiente para ser medido de imediato. Uma avaliação útil compararia taxa de erro de palavra, qualidade da pontuação, comportamento em fluxo, uso de memória e latência de ponta a ponta nas gravações e no equipamento-alvo da organização.
Se esses resultados se confirmarem, a combinação de um descarregamento de 415 MB, licenciamento permissivo, execução local e uma API compatível com a OpenAI poderia tornar o Phonon-1 uma camada de fala prática para ferramentas de secretária, sistemas privados de transcrição e aplicações de IA centradas no local. A tabela de testes é um motivo para o ensaiar, não um substituto do ensaio.