
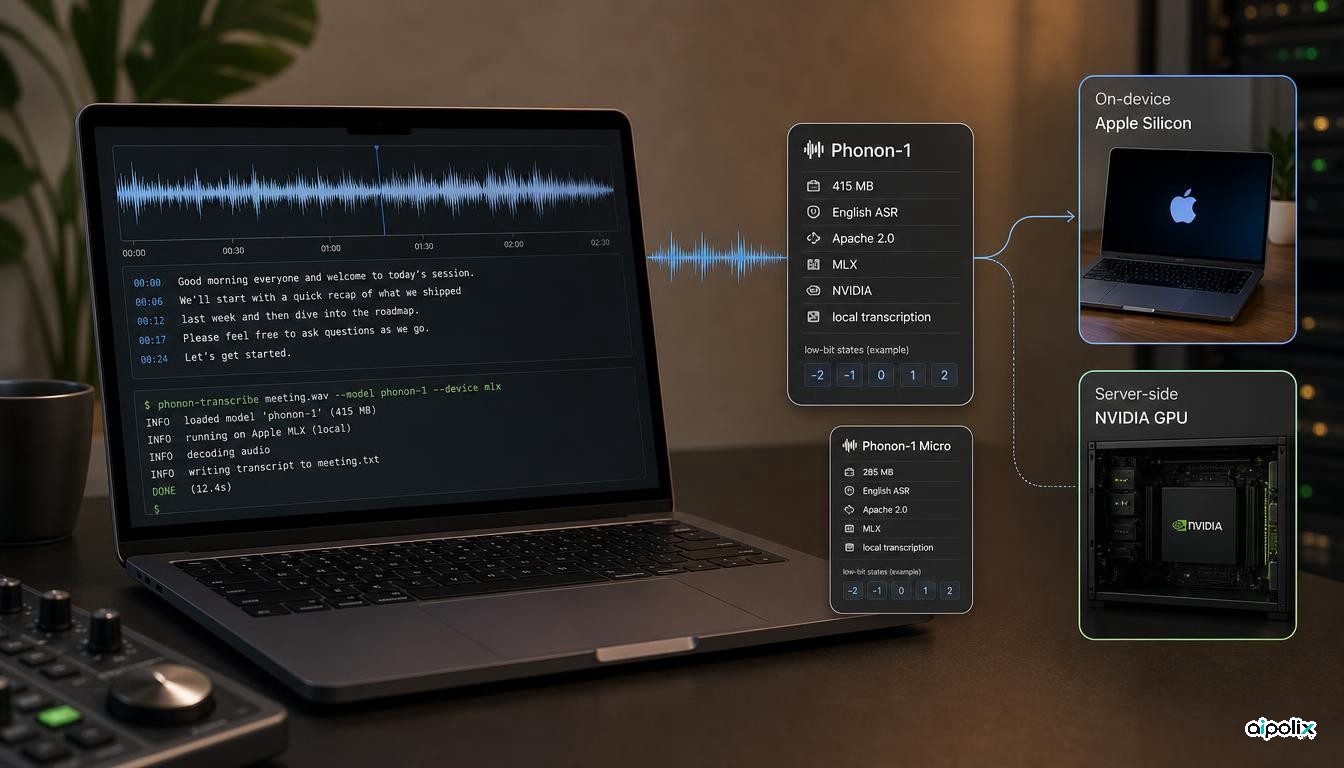
Fermion Research a publié Phonon-1, un modèle compact de reconnaissance automatique de la parole anglaise, conçu pour s’exécuter localement sur un ordinateur portable comme sur des GPU de centre de données NVIDIA. Le modèle par défaut se télécharge en 415 MB, est sous licence Apache 2.0, et peut s’utiliser via les outils en ligne de commande de Fermion ou via un point d’accès de transcription compatible avec OpenAI.
Cette publication compte parce qu’elle vise un écart pratique entre de très petits modèles de parole locaux et des systèmes de transcription plus lourds, qui exigent nettement plus de stockage ou de calcul. Fermion indique que Phonon-1 a été entraîné à partir de Qwen3-ASR-0.6B selon une approche d’entraînement à faible nombre de bits, plutôt que par une quantification ordinaire une fois le modèle achevé. La fiche du modèle sur Hugging Face le recense pour le passage de la parole anglaise au texte, Apple Silicon et l’usage à faible nombre de bits sur l’appareil.
Un modèle de 415 MB bâti autour de l’entraînement à faible nombre de bits
Fermion décrit Phonon-1 comme un modèle entraîné à 2.4 bits par poids du décodeur dès le départ. L’entreprise indique que l’artefact complet affiche en moyenne 4.65 bits per parameter et que le décodeur à faible nombre de bits est représenté à l’aide de cinq états appris. L’intention est de préserver davantage la précision du modèle enseignant qu’une conversion classique à faible nombre de bits réalisée après l’entraînement.
La construction par défaut de Phonon-1 pèse 415 MB. Fermion propose aussi Phonon-1 Micro, une variante plus petite de 285 MB, et une construction Big plus large. Le modèle par défaut est le point de référence le plus intéressant pour les développeurs, parce qu’il est présenté comme l’équilibre entre taille, précision et latence.
Les poids et les outils en ligne de commande sont distribués sous Apache 2.0. Fermion affirme que le modèle de base, Qwen3-ASR-0.6B, est également Apache 2.0. Cela rend la publication plus aisée à évaluer pour des charges de travail internes et commerciales que des modèles aux conditions personnalisées plus restrictives, même si les organisations doivent malgré tout mener leur vérification habituelle de licence et de conformité.
Ce que montrent les mesures de Fermion
Dans l’évaluation publiée, Fermion rapporte un taux d’erreur de mots de 2.640 percent sur LibriSpeech test-clean et de 5.699 percent sur test-other pour le modèle de 415 MB. L’entreprise publie aussi des résultats pour TED-LIUM, SPGISpeech, VoxPopuli, GigaSpeech, Earnings-22 et AMI, avec une moyenne macro de huit épreuves de 7.67.
Ces chiffres sont prometteurs, mais les éléments demandent une lecture prudente. Fermion marque explicitement la plupart des cellules de comparaison comme des mesures réalisées par sa propre équipe, avec des jeux de test complets, le normalisateur de texte anglais de Whisper et un décodage glouton. Certains chiffres concurrents proviennent de fiches de modèle ou de classements publiés, tandis que beaucoup ont été remesurés par Fermion selon son protocole.
Fermion affirme en outre que, sur cinq épreuves du monde réel, elle n’a pas trouvé de modèle téléchargeable à la fois plus petit et plus précis que Phonon-1. C’est une allégation du fournisseur, fondée sur l’ensemble de comparaison et le protocole choisis par l’entreprise, et non un résultat de premier plan établi de manière indépendante. La page note aussi que le modèle Parakeet-0.6B 4-bit de NVIDIA est plus précis sur les huit épreuves du tableau de Fermion, mais avec un téléchargement plus lourd.
L’installation locale fait partie du produit
Phonon-1 n’est pas seulement une publication de fiche de modèle. Le paquet fermion-research sur PyPI expose un flux de travail local avec fermion transcribe pour les fichiers audio et fermion serve pour un parcours /v1/audio/transcriptions compatible avec OpenAI. Les applications déjà construites autour de clients de transcription de type OpenAI peuvent donc pointer vers un serveur local, au lieu d’exiger une intégration cliente entièrement différente.
Fermion indique que les mêmes poids s’exécutent via MLX sur Apple Silicon et via son environnement d’exécution GPU NVIDIA. L’entreprise rapporte une vitesse médiane de décodage de 23.9 fois le temps réel sur neuf corpus sur un M5 MacBook Air de base, ce qui correspondrait à transcrire environ une heure d’audio en environ deux minutes et demie. Elle rapporte aussi une latence médiane de quelques centaines de millisecondes pour la dictée en direct.
Ces chiffres de vitesse sont, là encore, des mesures de Fermion. Le débit réel dépendra de la durée de l’audio, du regroupement, du matériel, de la pression mémoire, de la version de l’environnement d’exécution et des caractéristiques de l’entrée.
Où les équipes doivent rester prudentes
La limite principale n’est pas cachée : il s’agit d’un modèle de reconnaissance de la parole centré sur l’anglais, qui attend un signal à 16 kHz. Les organisations qui travaillent en plusieurs langues auront besoin d’un autre modèle ou d’une stratégie d’orientation. Les équipes actives en réunions bruyantes, en parole accentuée, en téléphonie, en vocabulaire spécialisé ou en audio de domaine ne doivent pas non plus extrapoler directement à partir de LibriSpeech ou d’une moyenne macro.
Il n’existe pas encore de reproduction indépendante des allégations de performance les plus importantes. Hugging Face et PyPI confirment que les artefacts et les outils sont disponibles, mais ce sont des surfaces de distribution contrôlées par Fermion, et non des évaluateurs indépendants.
Pour les développeurs, cela ne rend pas la publication inintéressante. Cela change la bonne étape suivante. Phonon-1 doit être traité comme un modèle ouvert compact, assez concret pour être mesuré immédiatement. Une évaluation utile comparerait le taux d’erreur de mots, la qualité de la ponctuation, le comportement en flux, l’usage mémoire et la latence de bout en bout sur les enregistrements et le matériel cible de l’organisation.
Si ces résultats tiennent, la combinaison d’un téléchargement de 415 MB, d’une licence permissive, d’une exécution locale et d’une API compatible avec OpenAI pourrait faire de Phonon-1 une couche de parole pratique pour des outils de bureau, des systèmes privés de transcription et des applications d’IA d’abord locales. Le tableau d’épreuves est une raison de l’essayer, non un substitut à l’essai.