
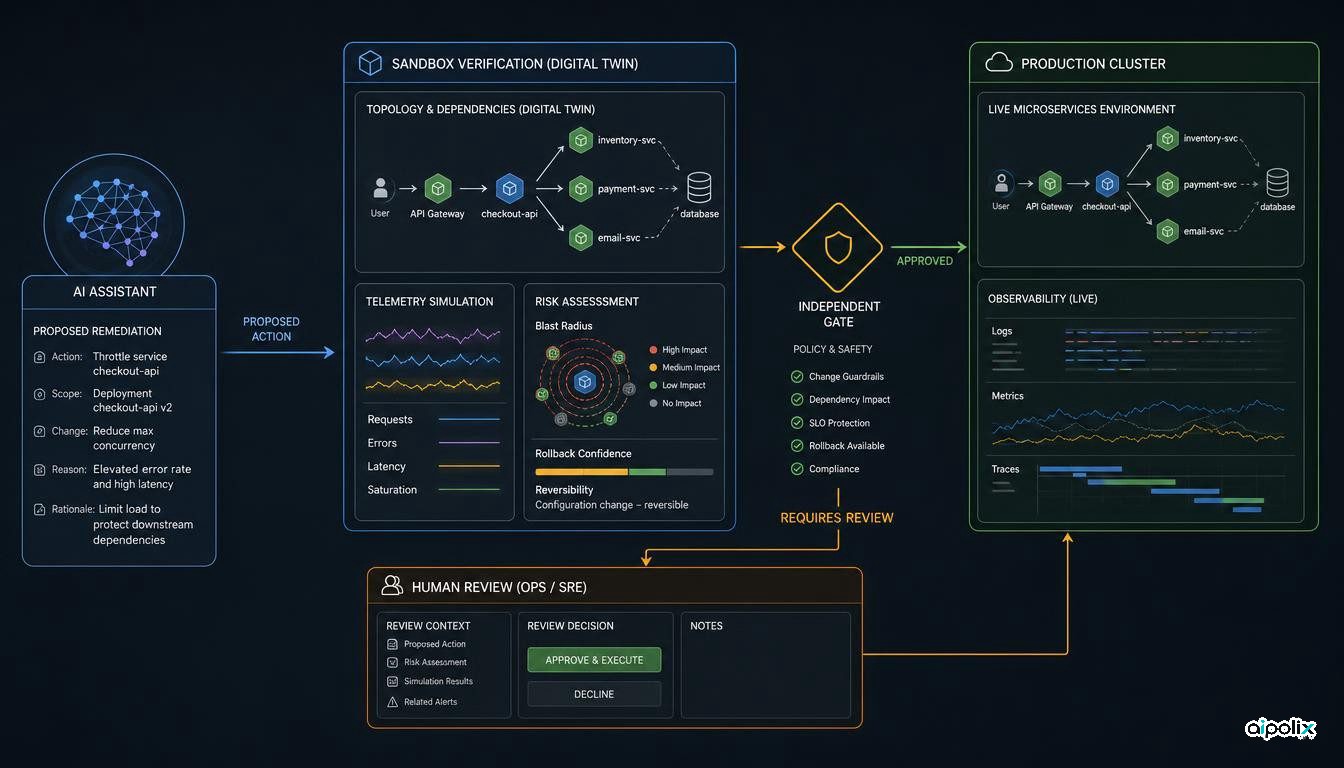
سامانههای هوش مصنوعی در مدیریت رخدادها کمکم از مرحله تشخیص مشکل به مرحله پیشنهاد اقدام برای زیرساخت واقعی نزدیک میشوند. مقاله تازه GuardedAct یک پرسش مشخصتر را بررسی میکند: اگر اقدام پیشنهادی مدل پیش از اجرا در محیطی شبیهسازی شود و از یک دروازه ارزیابی خطر بگذرد، آیا میتوان خسارت ناشی از تصمیم اشتباه را کمتر کرد؟
پژوهشگران این روش را روی پنج سناریوی خطای تزریقشده در بخش شبکه اجتماعی DeathStarBench آزمودهاند. طبق نتایج خود مقاله، سامانه در ۸۷٫۴ درصد موارد بازیابی را انجام داده و میزان خسارت جانبی را از ۲۵٫۶ درصد در اجرای مستقیم پیشنهاد مدل به ۵٫۲ درصد رسانده است. این کاهش ۷۹٫۷ درصدی با حدود هشت ثانیه افزایش میانگین زمان بازیابی همراه بوده است. این اعداد حاصل یک آزمایش کنترلشده و مقدماتیاند و نباید بهعنوان اثبات ایمنبودن اصلاح خودکار سامانههای واقعی تلقی شوند. ارزش اصلی کار در جای دیگری است: مدل زبانی اجازه ندارد خودش درباره اجرای نهایی تصمیم بگیرد.
اختیار اجرا از مدل جدا میشود
در GuardedAct، تشخیص و پیشنهاد راهحل از صدور اجازه اجرا جدا شده است. سامانه ابتدا گزارش تشخیص را همراه با توپولوژی فعلی و دادههای تلهمتری اخیر دریافت میکند. سپس مدل زبانی چند اقدام احتمالی را بهترتیب اولویت پیشنهاد میدهد. هر اقدام ابتدا در یک محیط شبیهسازی سبک بررسی میشود تا محدوده اثر احتمالی آن و سطح خطر برآورد شود.
در مرحله بعد، معیاری برای امکان بازگردانی تغییر بررسی میشود. فقط اقداماتی که کمخطر تشخیص داده شوند میتوانند خودکار اجرا شوند؛ موارد پرخطر به بازبینی انسانی میروند. بنابراین مدل نقش پیشنهاددهنده دارد، نه مرجع نهایی صدور مجوز.
این تفکیک از انتخاب مدل مهمتر است. اگر یک عامل هوشمند هم اقدام را بسازد و هم اجازه اجرای آن را داشته باشد، یک تشخیص اشتباه، داده قدیمی یا خطای استدلال میتواند مستقیماً به تغییر در زیرساخت تبدیل شود. GuardedAct خروجی مدل را در حد یک پیشنهاد نگه میدارد تا سامانهای مستقل درباره ورود آن به محیط عملیاتی تصمیم بگیرد.
اعداد امیدوارکنندهاند، اما دامنه آزمایش محدود است
آزمایش روی پنج نوع خرابی در برنامه شبکه اجتماعی DeathStarBench انجام شده است. این مجموعه یک محیط متنباز برای آزمایش سامانههای ریزخدمت فراهم میکند و امکان تکرار سناریوهای توزیعشده را میدهد، اما با محیط واقعی یک شرکت که سالها تغییر پیکربندی، وابستگیهای ثبتنشده، هشدارهای پرنویز و تصمیمهای همزمان اپراتورها را در خود دارد یکسان نیست.
نرخ بازیابی ۸۷٫۴ درصد و کاهش خسارت جانبی از ۲۵٫۶ به ۵٫۲ درصد، طبق گزارش نویسندگان، تفاوت میان اجرای مستقیم و روش دارای کنترل میانی را نشان میدهد. حدود هشت ثانیه تأخیر بیشتر نیز بهای همین مرحله بررسی است. با این حال، پنج سناریو برای نتیجهگیری درباره مجموعه گسترده رخدادهای واقعی کافی نیست.
محدودیت مهم دیگر این است که کیفیت تصمیم سامانه به دقت محیط شبیهسازی وابسته است. اگر روابط میان سرویسها، وضعیت فعلی یا اثرهای غیرمستقیم درست بازنمایی نشوند، یک اقدام ممکن است در آزمایش بیخطر به نظر برسد اما در سامانه واقعی نتیجه دیگری داشته باشد.
محیط شبیهسازی خودش بخشی از سطح خطر است
افزودن محیط آزمایشی بهتنهایی مسئله ایمنی را حل نمیکند. تیم بهرهبرداری باید بداند چه بخشی از وضعیت واقعی در آن بازسازی میشود، دادهها تا چه حد بهروزند، کدام پیامدها قابل شبیهسازی نیستند و چه میزان اطمینان برای صدور اجازه اجرا لازم است.
نکته کاربردی مقاله همین تغییر زاویه دید است. بهجای اینکه بپرسیم «آیا این عامل قابل اعتماد است؟»، میتوان درباره هر اقدام مشخص پرسید: این تغییر ممکن است چه بخشهایی را درگیر کند و آیا در صورت شکست، بازگردانی آن با اطمینان کافی ممکن است؟
با این نگاه، ایمنی دیگر فقط ویژگی مدل نیست. تصمیم نهایی در لحظه اجرا و بر اساس شواهد مربوط به همان اقدام گرفته میشود.
الگوی قابل استفاده، مرزبندی اختیار است نه اداره خودکار زیرساخت
برای تیمهای مهندسی، نتیجه مهمتر از خود اعداد این است که تولید پیشنهاد، ارزیابی خطر و اجازه اجرا میتوانند در سه لایه جدا قرار گیرند. عامل هوشمند صرفاً به این دلیل که فرمانی معتبر تولید میکند نباید اختیار تغییر محیط عملیاتی را نیز به دست آورد.
این تفکیک برای ممیزی هم مفید است. میتوان گزارش تشخیص، اقدامات پیشنهادی، نتیجه شبیهسازی، سطح خطر، امکان بازگردانی و تصمیم نهایی را ثبت کرد. اگر بعداً مشخص شود مدل اشتباه کرده، تیم همچنان میتواند ببیند آیا سازوکار مستقل کنترل اجرا درست عمل کرده است یا نه.
هزینه این الگو، افزایش زمان و پیچیدگی عملیاتی است. در بسیاری از رخدادها هشت ثانیه تأخیر میتواند در برابر جلوگیری از یک اصلاح مخرب قابل قبول باشد. در سامانههای بسیار حساس به زمان، راه منطقیتر شاید این باشد که فقط مجموعه کوچکی از اقدامات کاملاً برگشتپذیر از قبل مجاز باشند و بقیه نیاز به تأیید انسان داشته باشند.
GuardedAct ثابت نمیکند که اصلاح خودکار خطا برای محیط واقعی آماده است. اما یک اصل معماری روشن را آزمایش میکند: عامل پیشنهاد بدهد، سامانهای مستقل پیامد را ارزیابی کند و اختیار اجرا بر پایه آن ارزیابی تعیین شود، نه صرفاً بر اساس اطمینان خود مدل.