
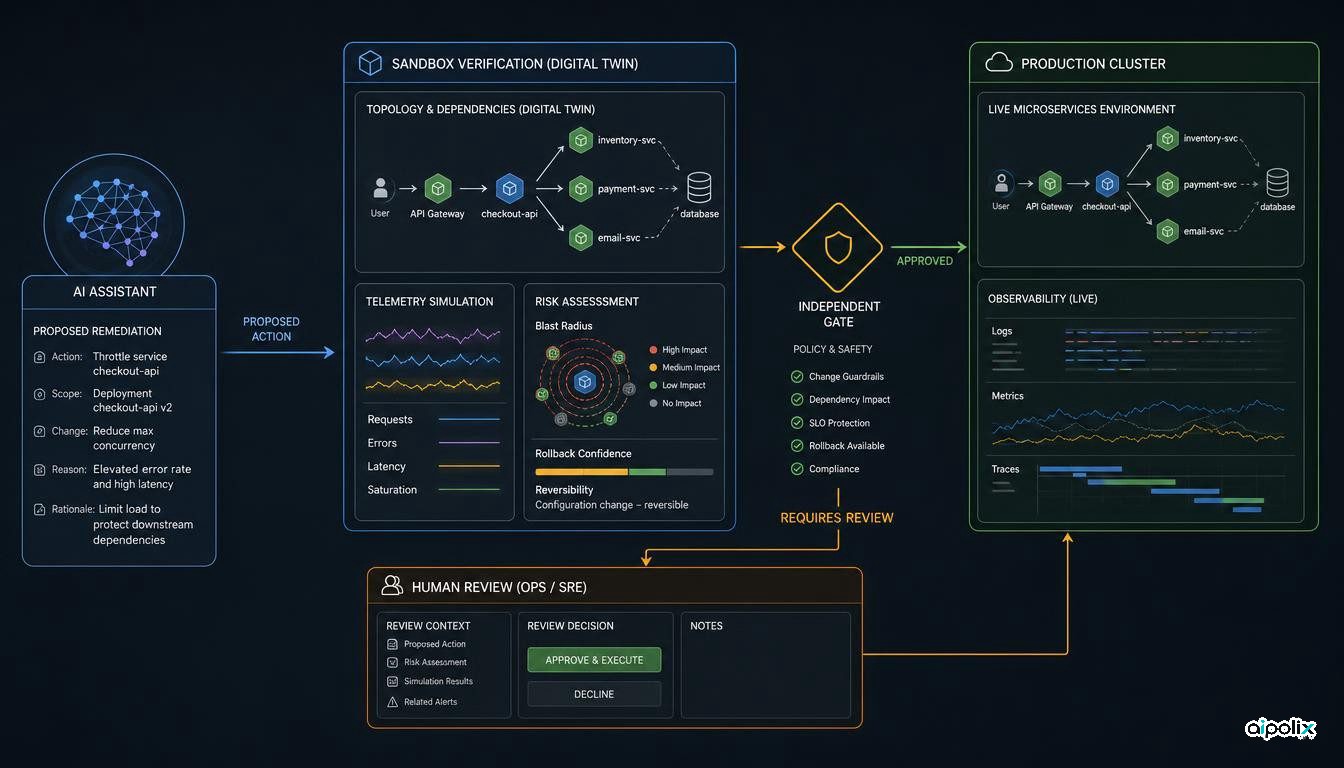
Os sistemas de IA usados no diagnóstico de incidentes estão cada vez mais próximos de poder sugerir alterações diretamente sobre infraestruturas de produção. O preprint GuardedAct testa uma questão mais limitada e operacional: o que muda quando cada ação proposta por um modelo tem de ser ensaiada num ambiente simulado e passar por uma avaliação de risco antes de poder chegar ao sistema real?
Os autores avaliaram a abordagem em cinco cenários de falha introduzidos na aplicação de rede social do DeathStarBench. Segundo o artigo, o método alcançou uma taxa global de recuperação de 87,4% e reduziu os danos colaterais de 25,6%, com execução direta pelo LLM, para 5,2%. A redução indicada pelos autores é de 79,7%, com cerca de oito segundos adicionais no tempo médio de recuperação devido à fase de simulação. São resultados preliminares obtidos num ambiente controlado, não uma demonstração de que a remediação autónoma seja segura em produção. O contributo mais interessante é a separação de responsabilidades: o modelo propõe uma ação, mas não decide sozinho se essa ação pode ser executada.
Propor uma correção não equivale a autorizá-la
O GuardedAct separa o diagnóstico e a geração de ações da autorização final. O sistema começa por receber um relatório de diagnóstico, a topologia atual e telemetria recente. Um LLM produz depois uma lista ordenada de possíveis intervenções. Cada proposta é testada num gémeo digital simplificado, que estima a extensão dos efeitos e atribui um nível de risco.
Existe ainda uma verificação da confiança na possibilidade de reverter a alteração. Apenas as ações consideradas de baixo risco podem seguir automaticamente para execução. As restantes são encaminhadas para análise humana.
Esta fronteira é mais relevante do que a escolha de um modelo específico. Se o mesmo agente puder inventar uma ação e conceder a si próprio autorização para a aplicar, um diagnóstico incorreto, informação desatualizada ou uma alucinação podem transformar-se imediatamente numa mudança em produção. No desenho do GuardedAct, a saída do modelo continua a ser apenas uma proposta até passar por um mecanismo independente de admissão.
Os números são úteis, mas o ensaio é pequeno
A avaliação usa cinco falhas introduzidas na aplicação Social Network do DeathStarBench, uma suite aberta para estudar sistemas distribuídos de microsserviços. O ambiente ajuda a repetir experiências de forma controlada, mas não reproduz toda a realidade de uma infraestrutura empresarial: alterações acumuladas de configuração, dependências pouco documentadas, alertas ruidosos, intervenções simultâneas e decisões tomadas por várias equipas.
Os autores indicam uma recuperação global de 87,4% e uma descida dos danos colaterais de 25,6% para 5,2%. A simulação acrescentou aproximadamente oito segundos ao tempo médio de recuperação. Estes valores tornam visível a troca entre rapidez e controlo, mas não justificam extrapolações para outros ambientes sem testes adicionais.
A limitação mais clara é o número de cenários. Cinco casos permitem observar uma diferença entre execução direta e execução sujeita a controlo, mas não representam a variedade de incidentes que aparece em produção. O artigo também não demonstra que o gémeo digital consiga reproduzir todas as dependências e todos os efeitos secundários relevantes de uma infraestrutura complexa.
A simulação também pode falhar
Introduzir uma zona de ensaio não elimina o risco. Se a topologia estiver incompleta, se a telemetria estiver desatualizada ou se uma dependência importante não estiver representada, uma ação pode parecer segura na simulação e ter consequências diferentes no sistema real.
Por isso, uma adoção prática exigiria respostas concretas sobre o próprio ambiente de verificação: que estado é reproduzido, com que atualidade, que efeitos não podem ser simulados e que nível de confiança é necessário antes de autorizar uma mudança.
A ideia de medir o raio de impacto é útil porque desloca a questão. Em vez de perguntar se um agente é genericamente fiável, a equipa pode avaliar uma ação concreta: que componentes pode afetar e até que ponto é possível revertê-la com segurança? A proteção passa assim a depender de uma decisão de autorização no momento da execução, e não apenas da qualidade percebida do modelo.
O padrão útil é a separação de autoridade
Para equipas de engenharia e operações, a conclusão mais robusta é arquitetural. Gerar uma correção, avaliar o risco e autorizar a execução podem ser funções independentes. Um agente não deve receber acesso de produção apenas porque consegue produzir comandos plausíveis.
Esta separação também melhora a capacidade de auditoria. O sistema pode registar o diagnóstico, as ações propostas, o resultado do ensaio, o nível de risco, a estimativa de reversibilidade e a decisão final. Se mais tarde se concluir que o modelo raciocinou mal, continua a ser possível verificar se o mecanismo independente de controlo funcionou como previsto.
O preço é maior latência e mais complexidade operacional. Os cerca de oito segundos adicionais reportados no estudo podem ser aceitáveis em muitos incidentes se evitarem uma intervenção destrutiva. Em sistemas extremamente sensíveis ao tempo, uma política mais prudente poderá pré-autorizar apenas um conjunto muito pequeno de ações reversíveis e exigir intervenção humana para todas as restantes.
O GuardedAct não prova que a remediação autónoma esteja pronta para ambientes reais. Mostra, porém, uma forma concreta de testar um princípio mais defensável: o agente recomenda, um mecanismo separado estima as consequências e a autorização para executar depende dessa avaliação, não apenas da confiança do próprio modelo.