
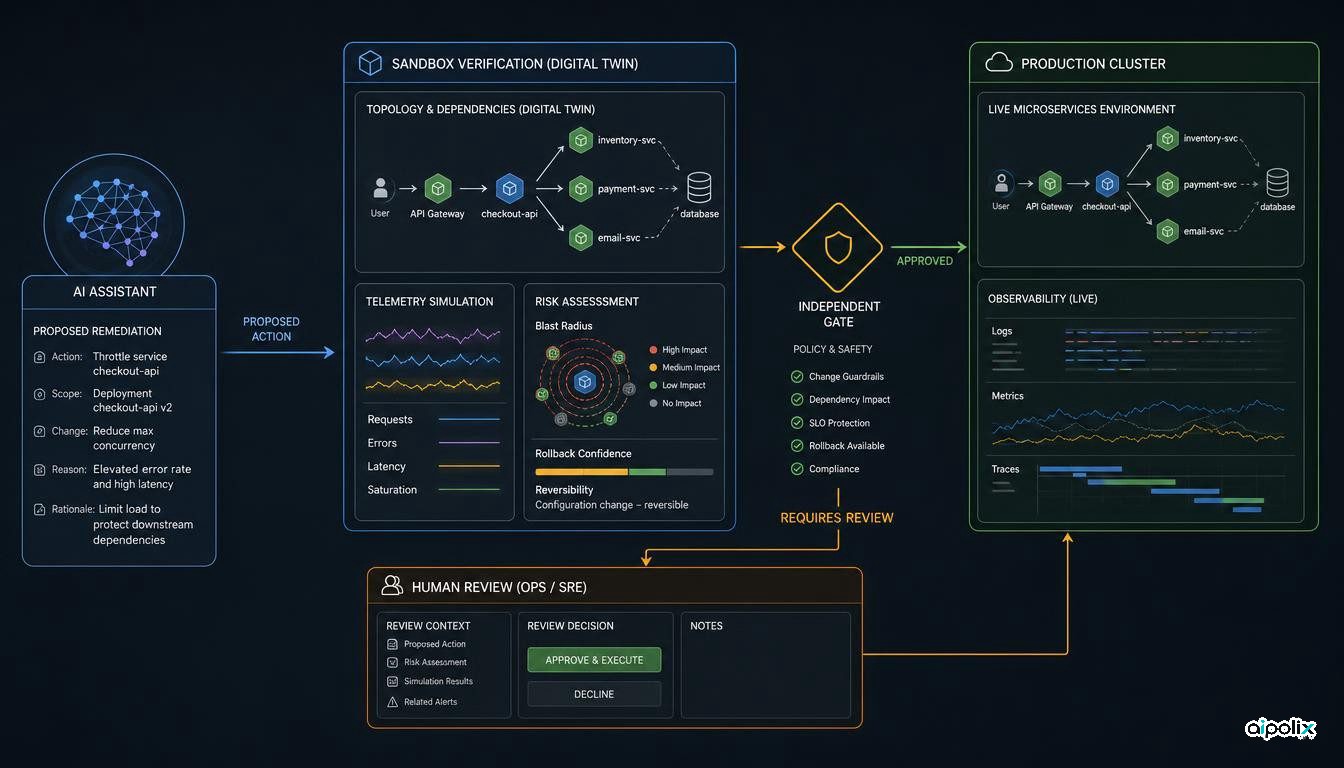
Les systèmes d’IA utilisés pour diagnostiquer des incidents se rapprochent d’un point où ils peuvent aussi proposer des actions sur l’infrastructure de production. Le préprint GuardedAct étudie une question plus précise : que se passe-t-il si chaque remédiation générée par un modèle doit d’abord être testée dans un environnement simulé puis franchir un contrôle de risque avant toute exécution réelle ?
Les auteurs ont évalué leur approche sur cinq scénarios de panne injectés dans l’application de réseau social de DeathStarBench. D’après le papier, le système obtient un taux global de rétablissement de 87,4 % et fait passer les dommages collatéraux de 25,6 % avec une exécution directe par le LLM à 5,2 %. Cela correspond à une baisse annoncée de 79,7 %, au prix d’environ huit secondes supplémentaires sur le temps moyen de rétablissement. Ces résultats restent préliminaires et proviennent d’un banc d’essai contrôlé. Ils ne démontrent donc pas qu’une remédiation autonome serait sûre en production. L’intérêt principal est architectural : le modèle ne décide pas seul si son action peut être exécutée.
Séparer la proposition de l’autorisation
GuardedAct dissocie le diagnostic et la génération d’actions de l’autorisation finale. Le système reçoit d’abord un rapport de diagnostic, la topologie actuelle et des données de télémétrie récentes. Un LLM produit ensuite une liste ordonnée d’actions possibles. Chacune est simulée dans un jumeau numérique allégé afin d’estimer l’étendue des effets possibles et de lui attribuer un niveau de risque.
Un contrôle supplémentaire évalue la confiance dans la capacité à revenir en arrière. Seules les actions jugées peu risquées peuvent être exécutées automatiquement. Les autres sont transmises à un opérateur humain.
Ce découpage compte davantage que le choix précis du modèle. Si le même agent peut à la fois inventer une commande et s’autoriser à l’appliquer, une erreur de diagnostic, un contexte périmé ou une hallucination peut devenir immédiatement une modification de production. Ici, la sortie du modèle reste une proposition qui doit satisfaire un mécanisme d’admission distinct.
Des résultats mesurables, mais sur un périmètre réduit
L’évaluation repose sur cinq pannes injectées dans l’application Social Network de DeathStarBench, une suite ouverte destinée à reproduire des architectures de microservices. Ce type de banc d’essai facilite la répétition des expériences, mais il ne reproduit pas toute la complexité d’un parc de production : dérive de configuration, dépendances mal documentées, alertes bruitées, changements simultanés et décisions prises par plusieurs équipes.
Les auteurs rapportent 87,4 % de rétablissement global. Ils indiquent aussi une baisse des dommages collatéraux de 25,6 % à 5,2 %, avec environ huit secondes de délai supplémentaire en moyenne. Ces chiffres rendent visible le compromis entre vitesse et contrôle, mais ils ne doivent pas être extrapolés à d’autres environnements sans validation complémentaire.
La principale limite est le nombre de scénarios. Cinq cas peuvent montrer qu’un mécanisme de contrôle se comporte différemment d’une exécution directe, mais pas couvrir la longue traîne des incidents réels. Le papier ne montre pas non plus qu’un jumeau numérique peut représenter fidèlement chaque dépendance ou chaque effet indirect d’une infrastructure complexe.
Le simulateur devient lui aussi un composant critique
Ajouter un bac à sable ne suffit pas à garantir la sécurité. Si la topologie y est incomplète, si la télémétrie est trop ancienne ou si certaines dépendances ne sont pas modélisées, une action peut paraître acceptable dans la simulation et se révéler dangereuse une fois appliquée.
Pour une équipe d’exploitation, la vraie question devient donc la qualité du modèle du système : quelles données sont répliquées, avec quelle fraîcheur, quels effets restent impossibles à simuler et quel niveau de confiance est exigé avant de permettre une modification ?
La notion de rayon d’impact proposée par GuardedAct est utile parce qu’elle évite de traiter la confiance comme une propriété générale de l’agent. Le contrôle porte sur une action donnée : quels composants peut-elle toucher et peut-on revenir en arrière de manière suffisamment fiable ? La sécurité devient alors une décision d’autorisation au moment de l’exécution.
Un modèle de contrôle, pas une preuve d’autonomie opérationnelle
Pour les équipes d’ingénierie, la conclusion la plus solide est que trois fonctions peuvent être séparées : proposer une correction, estimer son risque et autoriser son exécution. Un agent ne devrait pas recevoir des droits de production simplement parce qu’il sait générer une commande plausible.
Cette séparation améliore aussi la traçabilité. Un journal peut conserver le diagnostic, les actions proposées, le résultat de la simulation, le niveau de risque, l’évaluation du retour arrière et la décision finale. Si le raisonnement du modèle s’avère ensuite erroné, il reste possible d’évaluer le fonctionnement du contrôle indépendant.
Le coût est une latence plus élevée et davantage de complexité opérationnelle. Les huit secondes rapportées par l’étude peuvent être acceptables pour de nombreux incidents si elles évitent une correction dommageable. Dans les systèmes où chaque seconde compte, une politique plus prudente peut consister à préautoriser uniquement un petit ensemble d’actions réversibles et à soumettre toutes les autres à une validation humaine.
GuardedAct ne prouve pas que la remédiation autonome est prête pour la production. Il fournit toutefois un test concret d’un principe plus robuste : laisser l’agent proposer, confier l’évaluation des conséquences à un mécanisme indépendant, puis accorder ou refuser l’autorité d’exécution à partir de cette évaluation.