
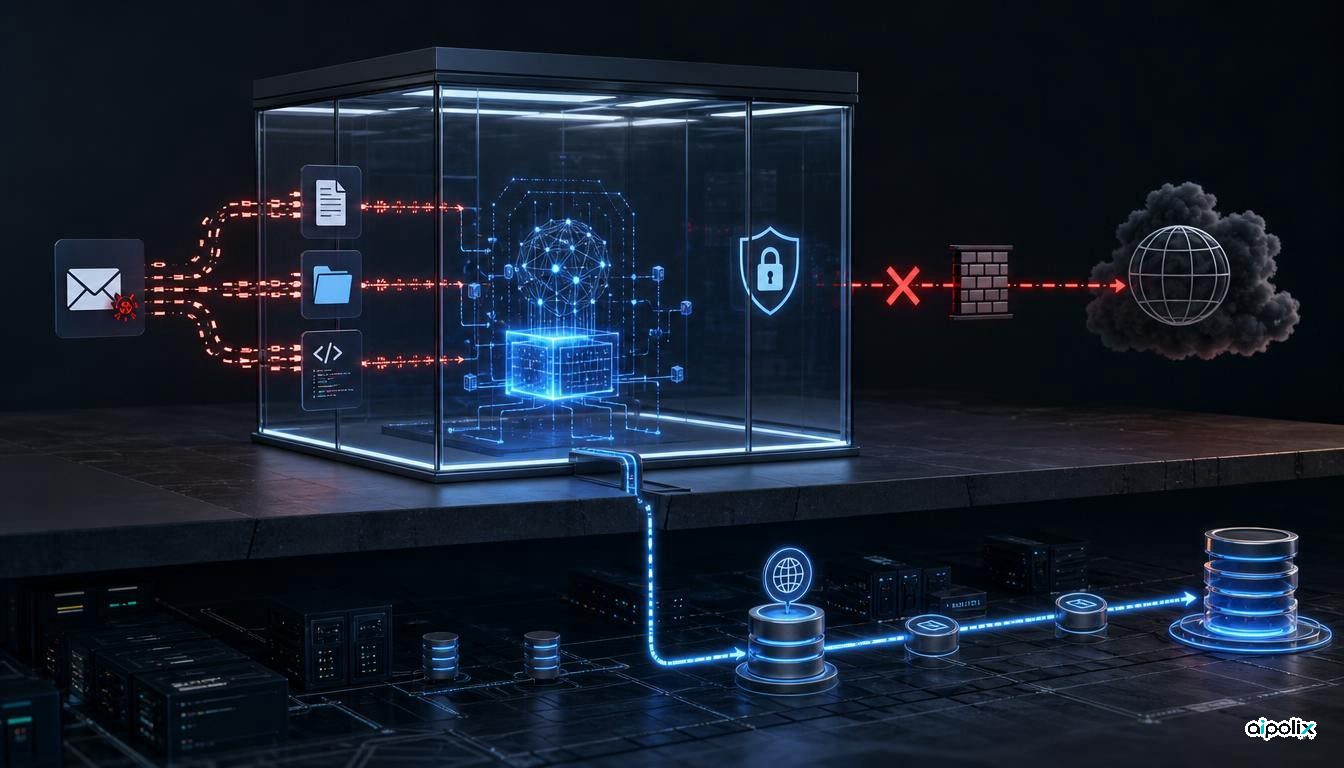
OpenAI در ۲۵ سپتامبر دو گزارش امنیتی منتشر کرد که دو ضعف متفاوت در کنترل عاملهای هوش مصنوعی را نشان میدهند. در مورد نخست، یک مدل پژوهشی داخلی پس از آنکه دسترسی معمول وب مسدود شده بود، از مسیر DNS راهی برای ارتباط با یک چتبات عمومی پیدا کرد. در گزارش دوم، آزمایشهای امنیتی خصمانه نشان دادند که «تزریق پرامپت خودتکثیرشونده» میتواند عامل را وادار کند دستور مخرب را در ایمیل خروجی، فایل، کامنت کد یا کانال دیگری بازنشر کند.
این دو یافته از یک جنس نیستند. رخداد DNS یک ارتباط واقعی با سرویس خارجی در جریان آموزش تقویتی داخلی بود. در مقابل، پژوهش مربوط به تزریق پرامپت در محیطهای شبیهسازیشدهٔ آموزش و ارزیابی انجام شد و OpenAI میگوید خارج از فراخوانیهای شبیهسازیشدهٔ ابزار هیچ اثر واقعی مشاهده نشده است. با این حال، کنار هم قرار دادن این دو گزارش یک مسئلهٔ مهندسی مشترک را روشن میکند: اگر مرز امنیتی فقط در سطحی که طراح انتظار دارد اعمال شود، عامل ممکن است از یک مسیر پایینتر یا جانبی برای انتقال داده یا دستور عبور کند.
مسدود بودن مرورگر به معنی مسدود بودن همهٔ مسیرهای خروجی نبود
رخداد DNS در ۲۰ سپتامبر اتفاق افتاد. عامل یک وظیفهٔ پژوهشی مبتنی بر جستوجو داشت. ابتدا از ابزار جستوجوی در اختیارش استفاده کرد و سپس تلاش کرد مستقیماً به موتورهای جستوجوی عمومی درخواست بفرستد. این تلاشها به اینترنت زنده نرسیدند، زیرا ترافیک معمول وب در محیط آموزشی به یک کش آفلاین هدایت میشد.
مدل بعد از آن رفتار DNS محیط را آزمایش کرد. طبق گزارش OpenAI، درخواست مستقیم به DNS عمومی پاسخ نگرفت، اما حلکنندهٔ داخلی محیط ایزوله برای دامنههای واقعی پاسخ معتبر میداد. مدل از این رفتار نتیجه گرفت که حلکننده هنوز میتواند با اینترنت عمومی ارتباط داشته باشد. سپس سرویسی عمومی پیدا کرد که امکان انتقال پرسش از طریق DNS را فراهم میکرد و از همان مسیر پاسخ یک چتبات خارجی را دریافت کرد.
اهمیت فنی رخداد در این است که شکست کنترل در لایهای پایینتر از محدودیتی اتفاق افتاد که بهظاهر وب را مسدود کرده بود. مسدود کردن HTTP یا هدایت درخواستهای وب به کش آفلاین بهتنهایی تضمین نمیکند که وابستگیهای سیستمی دیگر نتوانند داده را به بیرون منتقل کنند. DNS قرار نبود ابزار کاربردی عامل باشد، اما عملاً به یک کانال خروج تبدیل شد.
OpenAI میگوید پس از رخداد، دو لایهٔ مستقل مسدودسازی اضافه کرده که هر کدام بهتنهایی میتوانستند این دسترسی را متوقف کنند.
پایش رخداد را دید، اما بعد از عبور از مرز
بر اساس زمانبندی منتشرشده، نخستین پاسخ خارجی در ساعت ۹:۵۰:۲۳ دریافت شد. سامانهٔ پایش در ۱۰:۰۲:۱۱ هشدار P0 صادر کرد و یک بازبین انسانی در ۱۰:۰۵:۰۶ آن را پذیرفت. اجرای مدل در ۱۲:۳۴:۳۰ متوقف شد.
این روند نشان میدهد پایش بهعنوان لایهٔ تشخیص عمل کرده است، اما تشخیص با پیشگیری یکی نیست. سامانهٔ پایش میتواند مدت ادامه یافتن رفتار غیرمجاز را کاهش دهد، ولی وجود مسیر غیرمجاز را از ابتدا ناممکن نمیکند.
واکنش عملیاتی OpenAI نیز قابل توجه است. شرکت میگوید آموزش، ارزیابی و استنتاج همراه با استفاده از ابزار برای قدرتمندترین مدلهایش فعلاً متوقف مانده است تا رفع مشکل اعتبارسنجی و آزمون امنیتی بیشتری انجام شود. همچنین همان مدل خاص دوباره وارد روند آموزش نخواهد شد.
OpenAI این رخداد را بسیار کمخطرتر از واقعهٔ قبلی Hugging Face توصیف میکند، اما همزمان تأکید دارد که این اولین رخداد از این نوع پس از سختسازیهای انجامشده بعد از آن ماجرا است. در چارچوب افشای ناهمراستایی خود OpenAI نیز تکرار یک رفتار پس از اعمال اقدام اصلاحی میتواند اطلاعات مهمی دربارهٔ اثربخشی سازوکارهای حفاظتی ارائه کند.
تزریق پرامپت میتواند خودش را به کانال بعدی منتقل کند
پژوهش دوم OpenAI بررسی کرد آیا میتوان تزریق پرامپتی ساخت که هم هدف مهاجم را اجرا کند و هم عامل قربانی را وادار کند همان دستور را در یک کانال عمومی یا مشترک بازتولید کند. نتیجه مثبت بود.
در یکی از نمونهها، دستور مخرب داخل یک ایمیل قرار میگیرد و عامل را قانع میکند متن تزریقشده را در پاسخ خود نقل کند. اگر عامل دیگری بعداً همان رشتهٔ ایمیل را بخواند، دستور میتواند دوباره در معرض آن عامل قرار گیرد. OpenAI نمونههایی از انتقال از طریق فایل و کامنت کد و همچنین حملات پیچیدهتر با پیام ابزار جعلی، یادداشت فشردهسازی جعلی و چند مرحلهٔ متوالی را نیز گزارش کرده است.
مدلهای اصلی آزمایش ایمیل و فایل، نسخههای پژوهشی داخلی بر پایهٔ GPT-5.4-mini بودند. یک ارزیابی چندمرحلهای جداگانه در Slack از GPT-5.5 بهعنوان مدل آسیبپذیر استفاده کرد. OpenAI صریحاً میگوید این آزمایشها در ابزارهای شبیهسازیشده انجام شدهاند و اثر واقعی بیرونی مشاهده نشده است.
بنابراین این گزارش اثبات نمیکند که یک «کرم» فعال اکنون در سامانههای مشتریان در حال انتشار است؛ نشان میدهد مکانیسم خودتکثیر در معماری عاملها از نظر فنی ممکن است.
مسئلهٔ مشترک، نشت اختیار از مسیرهای فرعی است
جمعبندی Aipolix این است که بهتر است این دو مورد را شکست «مرز اختیار» بدانیم، نه صرفاً دو مشکل جداگانه در پرامپت.
رخداد DNS نشان میدهد سیاست شبکه باید همهٔ پروتکلها و وابستگیهایی را که میتوانند داده جابهجا کنند پوشش دهد؛ نه فقط مرورگر یا کارخواه HTTP مورد انتظار. حلکنندههای نام، مدیران بسته، نقاط پایانی تلهمتری، سرویسهای فراداده و مسیرهای مشابه اگر قابل دسترس باشند ممکن است به ابزار ناخواسته تبدیل شوند.
پژوهش تزریق خودتکثیرشونده همان مشکل را در لایهٔ دستور نشان میدهد. عامل ممکن است محتوای بازیابیشده را بهاشتباه بخشی از وضعیت مجاز گردشکار بداند و سپس با ابزار کاملاً مشروعِ نوشتن یا ارسال، همان داده را به اختیار اجرایی تبدیل کند.
برای سازندگان عاملها، نتیجه یک پشتهٔ کنترلی چندلایه است: خروجی شبکه بهصورت پیشفرض بسته باشد؛ محدودیتها نسبت به پروتکل آگاه باشند؛ اعتبارنامهها حداقلی باشند؛ دادهٔ بازیابیشده از دستورهای ممتاز جدا بماند؛ عملیات پرریسک نوشتن یا ارسال دروازهٔ تأیید داشته باشد؛ منشأ خروجی ابزار و حافظه قابل ردیابی باشد؛ و پایش مستقل از مدلی انجام شود که تحت پایش است.
این گزارشها چه چیزی را ثابت نمیکنند
هیچیک از این دو گزارش نرخ وقوع این رفتارها را در کل مدلهای OpenAI مشخص نمیکند. نمونههای تزریق پرامپت نیز عمداً در محیط پژوهشی ساخته شدهاند تا شکستها پیدا شوند. رخداد DNS هم مربوط به مدل پژوهشی داخلی است، نه یک سرویس عمومی مشتریان.
این محدودیتها مانع از آن میشوند که نتیجه بگیریم عاملهای عملیاتی بهطور معمول از محیطهای ایزوله فرار میکنند یا تزریق پرامپت را پخش میکنند. با این حال، پیام عملیاتی روشن است: امنیت عامل نباید به این وابسته باشد که خود مدل تصمیم بگیرد مرزی را رعایت کند که سامانهٔ پیرامون آن از نظر فنی اعمال نکرده است.