
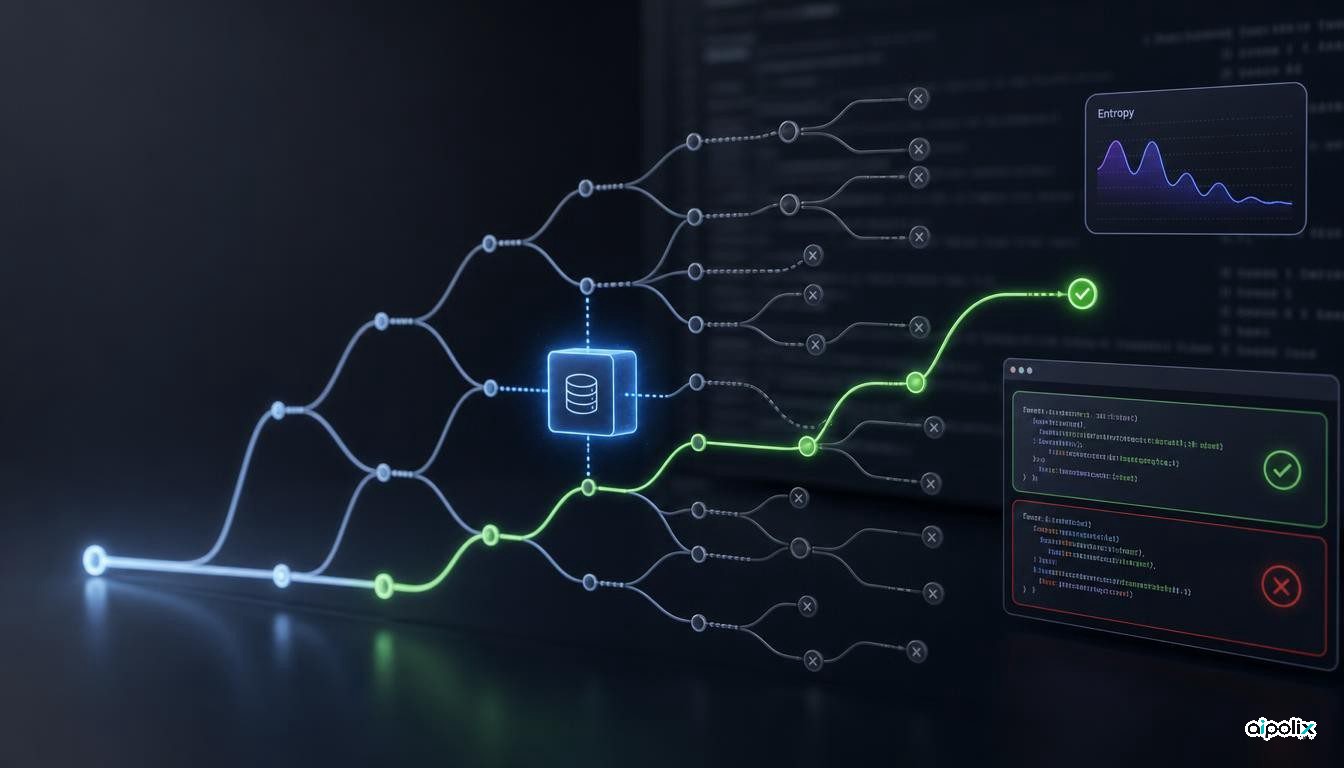
FLEET یک روش تازه برای decoding در زمان inference است که سراغ یک اتلاف ساده اما پرهزینه در نمونهگیری تکراری مدلهای زبانی میرود: هر completion جدید معمولاً نمیداند completionهای قبلی چه مسیرهایی را امتحان کردهاند. نویسندگان استدلال میکنند این وضعیت باعث میشود روشهای pass@k بخشی از بودجه محاسباتی را صرف پاسخهای بسیار شبیه یا شاخههایی کنند که قبلاً شکست خوردهاند. FLEET به فرایند تولید حافظه اضافه میکند و نمونهگیری تکراری را به جستوجویی ساختیافته در نقاط تصمیم با عدمقطعیت بالا تبدیل میکند.
در مهمترین نتیجه مقاله، FLEET در تنظیم آزمایششده Pass@32 در LiveCodeBench را از ۵۹٫۹ درصد به ۶۶٫۲ درصد میرساند و گزارش میکند برای رسیدن به دقت baseline نمونهگیری تکراری تقریباً به یکسوم تعداد نمونهها نیاز دارد؛ نویسندگان این نتیجه را بهصورت سرعت ۳ برابری بیان میکنند. اهمیت این نتیجه در این است که بهجای بزرگتر کردن مدل یا آموزش بیشتر، مستقیماً بهرهوری inference را هدف میگیرد.
مسئله، کمبود تنوع در همه توکنها نیست
Temperature sampling در همه مراحل تولید مقداری تصادفیبودن وارد میکند. این کار ممکن است مدل را از یک شاخه اشتباه اما پراحتمال خارج کند، اما در بخشهایی که مدل از قبل مطمئن است نیز نویز ایجاد میکند.
FLEET تلاش میکند این دو وضعیت را از هم جدا کند. روش با بررسی entropy و varentropy در حالتهای داخلی مدل، نقاطی را که احتمالاً محل انشعاب واقعی هستند شناسایی میکند. ساختار VectorDSU حالتهای پنهان مشابه را خوشهبندی میکند تا سیستم به خاطر بسپارد چه انتخابهایی قبلاً امتحان شدهاند و نتیجه هر مسیر چه بوده است.
سپس اطلاعات پاداش حاصل از trajectoryهای کاملشده در یک فرایند شبیه pUCT وارد جستوجو میشود. بهجای افزایش کورکورانه temperature، FLEET انتخابهای قبلی کمفایده را جریمه میکند و تولیدهای بعدی را به گزینههای دیگر هدایت میکند. در تنظیم آزمایششده، پس از اعمال این جریمهها decoding بهصورت greedy و قطعی انجام میشود.
در نتیجه، inference تکراری دیگر مجموعهای از قرعهکشیهای مستقل از یک توزیع ثابت نیست؛ هر تلاش تازه از شواهد تلاشهای قبلی استفاده میکند.
نتیجه کدنویسی مهم است، اما دامنه آن محدود است
مقاله FLEET را روی GSM8K و یک مجموعه فیلترشده از LiveCodeBench با Llama 3.2 3B و ۳۲ trajectory برای هر مسئله ارزیابی میکند. با verifier مبتنی بر پاسخ صحیح، Pass@32 در بخش کدنویسی از ۵۹٫۹ درصد به ۶۶٫۲ درصد میرسد؛ یعنی ۱۴۷ مسئله از ۲۲۲ مسئله حل میشود، در حالی که baseline عدد ۱۳۳ را ثبت میکند. در GSM8K بهبود کوچکتر است، چون baseline از ابتدا نزدیک سقف عملکرد قرار دارد.
نویسندگان همچنین یک Outcome Reward Model را بهعنوان جایگزینی واقعبینانهتر برای verifier قطعی بررسی میکنند. این بخش مهم است، چون در سامانههای واقعی معمولاً بلافاصله نمیدانیم یک خروجی واقعاً درست است یا نه. نتایج نشان میدهد کیفیت جستوجو و انتخاب پاسخ نهایی تا حدی به کیفیت سیگنال ارزیابی وابسته میشود.
این محدودیت اساسی است: حتی اگر الگوریتم گزینههای بهتری پیدا کند، evaluator ضعیف میتواند در پایان گزینه نادرست را انتخاب کند.
مناسبترین کاربرد، inference خودمیزبان است
مخزن رسمی بهصورت بسته fleet-search قابل نصب است و برای Transformers، nnsight و Ray مثال دارد. با این حال FLEET جایگزینی شفاف برای APIهای بسته معمول نیست.
پیادهسازی به دسترسی white-box به hidden stateهای مدل نیاز دارد. بنابراین این روش فعلاً برای تیمهایی که مدلهای open-weight را خودشان سرو میکنند یا کنترل inference stack را در اختیار دارند عملیتر از توسعهدهندگانی است که فقط متن یا خروجی استاندارد API را دریافت میکنند.
برای coding agentها، بهترین محیط جایی است که verifier ارزان و قطعی وجود دارد: تستها، compilation، static checks یا امتیاز عینی دیگری برای کار. در چنین حالتی completion ناموفق صرفاً دور ریخته نمیشود؛ اطلاعات trajectory آن میتواند تلاش بعدی را از همان شاخه شکستخورده دور کند.
این نگاه، تعریف inference-time scaling را تغییر میدهد. مسئله فقط تعداد sampleها نیست؛ مسئله این است که آیا sampleهای بعدی از هزینهای که sampleهای قبلی ایجاد کردهاند چیزی یاد میگیرند یا نه.
ادعای ۳ برابر هنوز قابل تعمیم نیست
FLEET فعلاً یک preprint در arXiv است و benchmark تولیدی peer-reviewed محسوب نمیشود. آزمایشها نیز محدودند: یک مدل 3B، دو خانواده benchmark و زیرمجموعهای ۲۲۲تایی از مسائل نسبتاً ساده LiveCodeBench. خود repository هم الزام دسترسی به hidden state را صریحاً ذکر میکند.
بنابراین عدد ۳ برابر باید نتیجه sample-efficiency در همین تنظیم آزمایشی تلقی شود، نه وعدهای عمومی برای کاهش ۳ برابری latency یا هزینه زیرساخت در همه مدلها و workloadها.
شواهد بعدی که میتواند این نتیجه را واقعاً قویتر کند، تکرار روی مدلهای بزرگتر و متفاوت، مسائل کدنویسی دشوارتر، اندازهگیری wall-clock روی serving stack واقعی و آزمایش با verifierهای ناقص است. اگر این نتایج حفظ شوند، FLEET میتواند نشانه یک تغییر مهم در test-time scaling باشد: بهجای پرداخت هزینه برای حدسهای مستقل بیشتر، inference system باید به خاطر بسپارد کدام حدسها قبلاً شکست خوردهاند.