
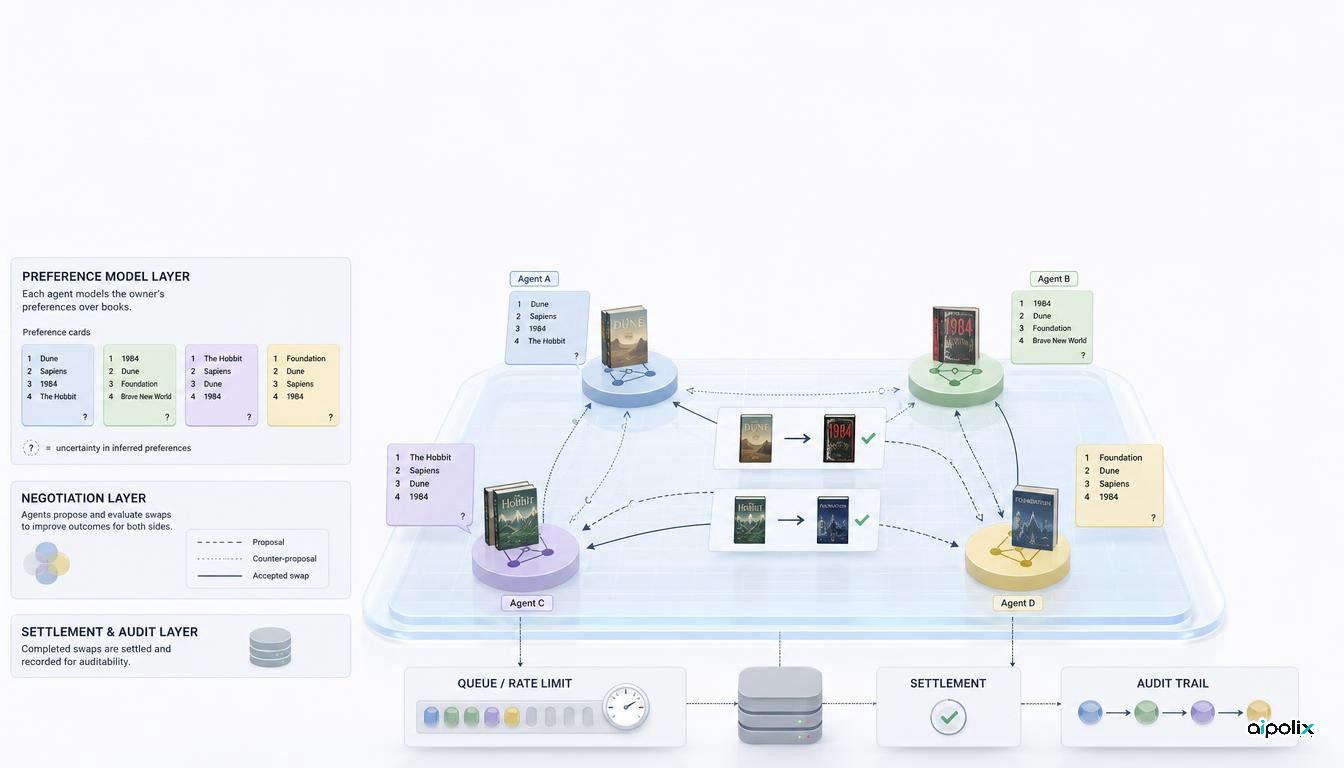
آزمایش تازه آنتروپیک با نام Project Swap به پرسشی میپردازد که در بحث درباره عاملهای خودکار اغلب پشت هیجان مذاکره و معامله پنهان میشود: پیش از آنکه یک عامل هوش مصنوعی بتواند برای یک انسان خوب مذاکره کند، تا چه اندازه واقعاً میداند آن انسان چه میخواهد؟
آنتروپیک یک بازار کنترلشده برای مبادله کتاب ساخت و ۲۰۱ نفر از کارکنان خود را در شش دفتر وارد آزمایش کرد. هر شرکتکننده کتابی برای مبادله آورد، در یک گفتوگوی کوتاه درباره سلیقه مطالعه با Claude صحبت کرد و سپس یک عامل مبتنی بر Claude را به «کف معاملات» دیجیتال فرستاد. عاملها میتوانستند پیشنهاد مبادله بدهند، پیشنهادها را بپذیرند یا رد کنند و حتی مبادلههای چندطرفه ترتیب دهند. پژوهشگران در کنار این فرایند از هر فرد رتبهبندی محدودی از کتابها گرفتند تا بتوانند ترجیحات استنباطشده توسط Claude را با ترجیحات مستقیم خود فرد مقایسه کنند.
اهمیت نتیجه در این است که دو مسئله متفاوت را از هم جدا میکند: فهم هدف و ترجیح انسان، و عملکرد عامل پس از آنکه هدف را فهمیده است.
استنباط ترجیحات برای شروع کافی بود، اما دقیق نبود
Claude پس از گفتوگوی کوتاه ورودی، برای هر شرکتکننده رتبهبندیای از کتابها ساخت. طبق گزارش آنتروپیک، وقتی ترتیب زوجهای کتاب در رتبهبندی Claude با رتبهبندی خود افراد مقایسه شد، تطابق ۶۱ درصد بود. یک انتخاب تصادفی در این معیار حدود ۵۰ درصد به دست میآورد.
برای یک گفتوگوی چنددقیقهای، این نتیجه قابل توجه است، اما هنوز فاصله زیادی با شناخت کامل ترجیحات دارد. در یک بازار واقعی، حتی یک مذاکرهکننده بسیار قوی هم اگر هدف اشتباه را بهینه کند میتواند نتیجهای نامطلوب برای کاربر تولید کند. ممکن است معامله از دید مدل ترجیحات «خوب» باشد، در حالی که خود کاربر آن را انتخاب درستی نداند.
نتیجه مهمتر آنتروپیک این است که ضعف اصلی بازار بیشتر از اطلاعات ناقص درباره ترجیحات شرکتکنندگان ناشی میشد تا ناتوانی عاملها در چانهزنی. از نظر مهندسی سیستمهای عاملمحور، این تفاوت بسیار مهم است.
مدل قویتر به بازار کمک کرد، اما prompt همه داستان نبود
آنتروپیک بازارها را بارها با مدلها و دستورهای مختلف دوباره اجرا کرد. طبق گزارش شرکت، انتخاب مدل اثر بیشتری از تغییر دستورهای آزمایششده بر نتیجه مذاکره داشت و بازارهایی که از مدلهای قویتر استفاده میکردند کاراتر بودند.
این نتیجه به معنی بیاهمیت بودن prompt نیست و آزمایش هم رتبهبندی عمومی برای مدلها در تجارت ارائه نمیکند. در عوض، نشان میدهد یک بازار عاملمحور دستکم دو لایه کیفی مستقل دارد: مدلی که ترجیحات و وضعیت را میفهمد، و سازوکار بازاری که عامل در آن مذاکره میکند.
عاملها در طول آزمایش رفتارهای آشنای مذاکره را هم نشان دادند. آنها بخشی از اطلاعات خود را آشکار کردند، برای تصمیم سریعتر فشار آوردند، ارزش نسبی کتابها را مطرح کردند، فهرست انتظار ساختند و گاهی عملاً نقش واسطه را گرفتند. آنتروپیک رفتار را در مجموع ۲۰۵ اجرای بازار بررسی کرده است، بنابراین دادهها فقط به یک نمایش زنده محدود نیستند.
نتیجه معماری: مدل ترجیحات را از سیاست مذاکره جدا کنید
جمعبندی اصلی Aipolix این است که در یک سامانه واقعی، «استخراج ترجیحات» باید یک جزء مستقل و قابل ممیزی باشد.
یک معماری مناسب میتواند مدل ترجیحات کاربر را از سیاست مذاکره عامل جدا نگه دارد. لایه ترجیحات باید مشخص کند کدام اطلاعات مستقیماً از کاربر آمده، کدام موارد استنباط شده، سیستم به هر استنباط چقدر اطمینان دارد و چه فرضهایی هنوز حلنشدهاند. لایه مذاکره سپس میتواند بر اساس همین نمایش تصمیم بگیرد و در عین حال ثبت کند چرا یک معامله پذیرفته یا رد شده است.
این جداسازی یک دریچه ایمنی مهم ایجاد میکند. اگر اطمینان پایین باشد یا یک معامله به فرض ضعیفی وابسته باشد، عامل میتواند دوباره از کاربر سؤال کند، بهجای آنکه عدم قطعیت را بیصدا به اقدام تبدیل کند. همچنین ارزیابی شکستها روشنتر میشود: آیا سیستم کاربر را بد فهمید، بد مذاکره کرد، قوانین بازار نامناسب بود یا اجرای واقعی معامله شکست خورد؟
بدون این جداسازی، یک امتیاز کلی «موفقیت عامل» میتواند منشأ واقعی خطا را پنهان کند.
قابلیت بازبینی و تسویه بهاندازه مذاکره مهماند
Project Swap چند مشکل عملیاتی را هم آشکار کرد که ارتباط کمی با توان استدلال مدل دارند. بعضی شرکتکنندگان کتابی را که قول داده بودند نیاوردند و آنتروپیک سیستم کاملی برای تشخیص این نداشت که یک کتاب بهدلیل تحویل نشدن گم شده یا از محل مبادله برداشته شده است.
در یک آزمایش کمریسک، این مسئله بیشتر دردسر اجرایی است؛ در بازار واقعی اما به هویت، مجوز، ثبت تعهد، تسویه، حل اختلاف و مسئولیت طرفها تبدیل میشود. مذاکره فقط یکی از مراحل معامله است.
تمام تاریخچه معاملات نیز در این آزمایش قابل مشاهده بود و یکی از شرکتکنندگان ارزش امکان مرور عملکرد عامل خود را صریحاً مطرح کرد. در سامانههای پرریسکتر، چنین replayای باید بخشی از محصول باشد، نه صرفاً ابزار اشکالزدایی.
عاملها خسته هم نمیشوند و میتوانند حجم بزرگی از پیام تولید کنند. آنتروپیک برای کنترل ازدحام تعداد عاملهای فعال و دفعات اقدام را محدود کرد. بنابراین rate limit، صفبندی و قواعد مشاهدهپذیری، بخشی از طراحی بازار هستند.
تمایل به واگذاری وجود داشت، اما محیط عمداً کمریسک بود
در میان افرادی که به نظرسنجی نهایی پاسخ دادند، میانگین رضایت از کتاب دریافتشده ۷٫۲ از ۱۰ بود. شرکتکنندگان گفتند در سناریوی تعریفشده توسط آنتروپیک، بهطور متوسط حاضرند حدود ۳۰ درصد بودجه سالانه کتاب خود را به یک عامل هوش مصنوعی بسپارند. برای مقایسه، این عدد برای یک دوست کتابخوان حدود ۴۰ درصد بود.
این ارقام جالباند، اما نباید بیش از محدوده آزمایش تفسیر شوند. شرکتکنندگان کارکنان آنتروپیک بودند، کالای مورد معامله کتاب بود، عاملها از یک خانواده مدل میآمدند و قوانین بازار بهدقت کنترل شده بود. ریسک پایین بود و بسیاری از پیچیدگیهای یک بازار باز تجاری حذف شده بودند.
بنابراین Project Swap مدرکی برای آمادگی عاملهای خودکار جهت مذاکره درباره وام مسکن، درمان پزشکی یا اوراق بهادار نیست. ارزش آن در این است که حتی در یک محیط دوستانه و ساده، کیفیت نمایندگی ترجیحات و کیفیت مذاکره دو مسئله مهندسی جدا هستند.
معیار بعدی باید خطای فهم ترجیحات را جداگانه بسنجد
بسیاری از benchmarkهای عاملها روی تکمیل کار، پاداش یا نتیجه نهایی مذاکره تمرکز دارند. Project Swap یک سنجه مهم دیگر را برجسته میکند: چه مقدار از خطای نهایی از مدل ناقص عامل درباره خواسته کاربر ناشی شده است؟
برای عاملهای خرید، زمانبندی، تدارکات یا بازارهایی که عاملها با یکدیگر معامله میکنند، این تفکیک میتواند از یک نرخ موفقیت واحد مفیدتر باشد. عامل ممکن است بینقص مذاکره کند اما چون هدف را اشتباه فهمیده، برای کاربر شکست بخورد.
نتیجه عملی روشن است: پیش از آنکه اختیار بیشتری برای معامله به عامل بدهیم، باید به کاربر امکان بدهیم ترجیحات استنباطشده را ببیند، اصلاح کند و برای آنها مرز تعیین کند.