
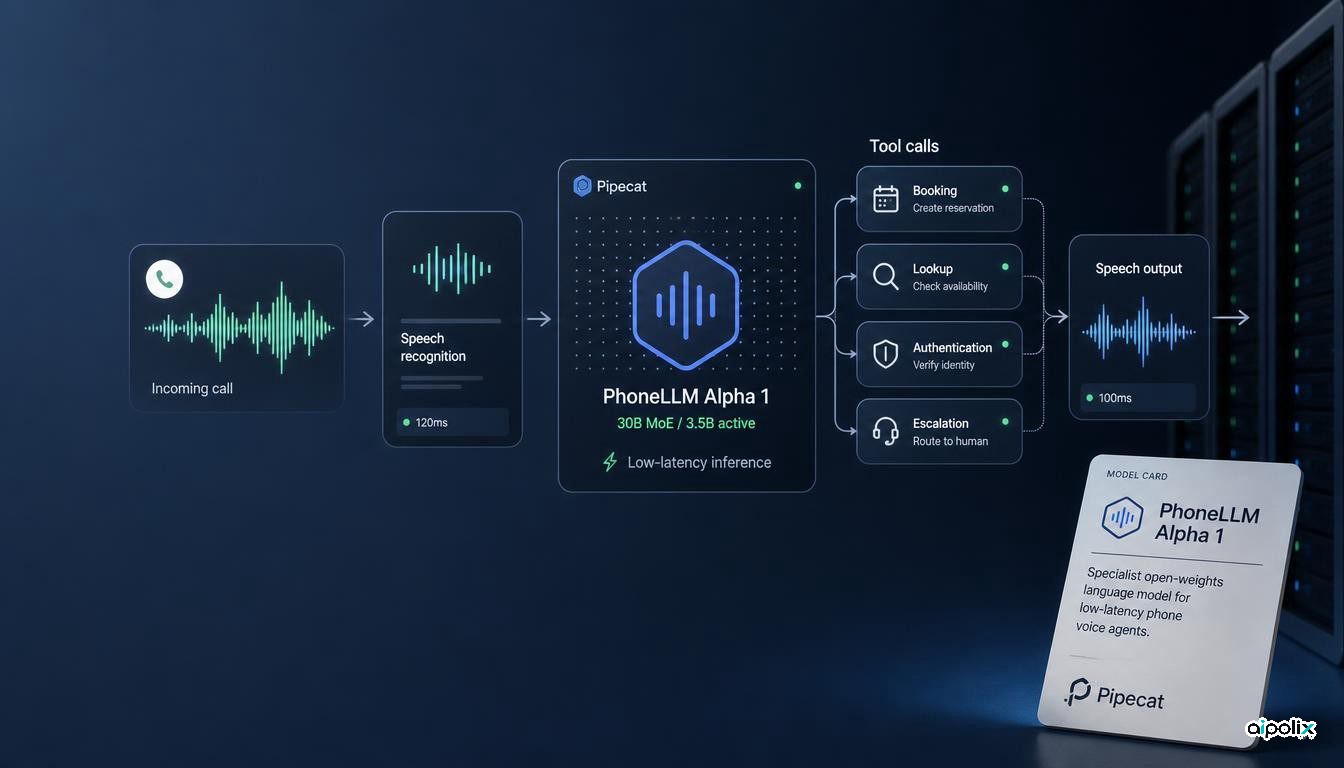
تیم Daily در Pipecat، PhoneLLM Alpha 1 را عرضه کرده است؛ مدل زبانی با وزنهای باز که مشخصاً برای عاملهای صوتی تلفنی آموزش دیده است. بهجای رقابت بهعنوان مدل عمومی مرزی، PhoneLLM حول مسئلهٔ تولیدی محدودتری بهینه شده: پاسخ سریع، حفظ وضعیت چندنوبتی و فراخوانی درست ابزارها، بدون تکیه بر ردپاهای طولانی استدلال.
این تمایز برای عاملهای صوتی اهمیت دارد. در واسط متنی، یک ثانیه تأخیر اضافهٔ مدل میتواند آزاردهنده باشد. در مکالمهٔ تلفنی، میتواند تعامل را شکسته جلوه دهد. Pipecat استدلال میکند بسیاری از مدلهای مرزی برای بارهایی بهینه شدهاند که زمان استدلال اضافه در آنها پذیرفتنی است، در حالی که عاملهای تلفنی تولیدی اغلب به تعادل متفاوتی از سرعت، دقت ابزار و هزینه نیاز دارند.
مدل مخلوط متخصصان 30B با 3.5B پارامتر فعال
PhoneLLM Alpha 1 تنظیم ریز همهٔ پارامترهای NVIDIA Nemotron 3 Nano 30B-A3B است. مدل حدود 30B پارامتر کل دارد اما بهخاطر معماری مخلوط متخصصان حدود 3.5B پارامتر فعال بهازای هر توکن.
Pipecat مدل را با NVIDIA NeMo آموزش داده و وزنها را در Hugging Face منتشر میکند. مشخصات مدل پنجرهٔ زمینهٔ 262,144 توکن، انگلیسی بهعنوان زبان پشتیبانیشده و استنتاج قطعی با دما صفر و استدلال خاموش را فهرست میکند.
مدل را میتوان با vLLM یا SGLang ارائه کرد. Pipecat میگوید روی یک NVIDIA B200 بهراحتی جا میشود و زمان رسیدن به نخستین توکن P95 برای درخواست منفرد را sub-100 ms روی آن سختافزار گزارش میکند. این ارقام ارائه، اندازهگیریهای طرف اولاند؛ باید آنها را راهنمای استقرار دانست، نه اعتبارسنجی مستقل عملکرد.
PhoneLLM همچنین مدل گفتاربهگفتار نیست. در لایهٔ مدل زبانی یک زنجیرهٔ متعارف عامل صوتی مینشیند و برای کار در کنار سامانههای بازشناسی گفتار و تبدیل متن به گفتار طراحی شده است.
PhoneBench اقتصاد یک عامل تلفنی را میسنجد
شاید بخش جالبتر عرضه، PhoneBench Alpha 1 باشد؛ معیار تازهٔ Pipecat برای مدلهای زبانی عامل تلفنی.
PhoneBench، 15 مدل را در مکالمههای واقعگرایانهٔ چندنوبتی خدمات مشتری ارزیابی میکند، از جمله فراخوانی ابزار، رفتار احراز هویت، انضباط ارجاع، تکیهگاه واقعی، انسجام مکالمه و اینکه آیا پاسخ گفتاری مدل با کنشی که واقعاً انجام داده مطابقت دارد.
چون بسیاری از این ویژگیها با تطبیق دقیق رشته سخت امتیازدهی میشوند، Pipecat از هیئتی از داوران مدل زبانی کالیبرهشده با برچسب انسانی استفاده میکند. تیم میگوید سناریوها، ابزارها و دستورهای معیار از دادهٔ آموزشی PhoneLLM جدا نگه داشته شدهاند.
معیار همچنین زمان تا نخستین توکن پاسخ و برآورد هزینه در دقیقه را میسنجد. همین آن را به تصمیم تولیدی عامل صوتی نزدیکتر میکند تا به معیار دانشگاهی متعارف زبان، جایی که تأخیر و اقتصاد ارائه اغلب غایباند.
Pipecat کیفیتی نزدیک به GPT-5.6 Terra را با هزینهٔ بسیار کمتر گزارش میکند
در PhoneBench Alpha 1، Pipecat امتیاز 72.3% را برای PhoneLLM گزارش میکند، تقریباً همان 72.4% برای GPT-5.6 Terra. Gemini 3.6 Flash با 78.6% در صدر معیار است.
اعداد هزینه و تأخیر جایی است که PhoneLLM در نتایج Pipecat متمایز میشود. معیار هزینهٔ PhoneLLM را حدود $0.0025 در دقیقهٔ مکالمه برآورد میکند، در برابر $0.0347 برای GPT-5.6 Terra. Pipecat آن را تقریباً 94% ارزانتر توصیف میکند.
PhoneBench همچنین PhoneLLM را حدود 600 ms در صدک 95 زمان تا نخستین توکن پاسخ گزارش میکند، در برابر 1,957 ms برای GPT-5.6 Terra؛ اختلافی حدود 1.3 ثانیه.
این اعداد درخور توجهاند، اما قید مهمی میطلبند. PhoneBench را همان سازمانی طراحی و اجرا کرده که PhoneLLM را آموزش داده است. معیار از داوران مدل زبانی، هزینههای برآوردی ارائه و پیکربندی تولیدی منتخب Pipecat استفاده میکند. بنابراین نتایج نشان میدهد PhoneLLM داخل چارچوب ارزیابی Pipecat چگونه عمل میکند، نه برتری مستقلاً تثبیتشده.
سیگنال بزرگتر تخصصیسازی است
عرضه به انتخاب معماری وسیعتری برای عاملهای تولیدی اشاره میکند.
یک مدل عمومی مرزی جذاب است چون یک مدل میتواند وظایف بسیاری را پوشش دهد. اما عاملی با دامنهٔ تنگ اغلب به دانش گستردهٔ جهان یا استدلال طولانی در هر نوبت نیاز ندارد. به استفادهٔ پیشبینیپذیر از ابزار، تأخیر کم، رفتار پایدار گفتوگو و اقتصادی نیاز دارد که تا هزاران تعامل مقیاس شود.
Pipecat عملاً میآزماید آیا این نیازها را میتوان از راه تنظیم ریز هدفمند به وزنهای مدل منتقل کرد، نه اینکه فقط با دستوردهی و مسیریابی به مدلهای بزرگتر حل شوند.
این الگو میتواند بسیار فراتر از عاملهای تلفنی اهمیت داشته باشد. پشتیبانی مشتری، زمانبندی، دستیارهای تراکنشی و دیگر جریانهای کراندار ممکن است بیشازپیش از مدلهای تخصصی برای اکثر نوبتها استفاده کنند و موارد استثنایی را به مدلهای بزرگتر بفرستند.
وزنهای باز معادلهٔ استقرار را نیز عوض میکنند. تیمها میتوانند PhoneLLM را خود میزبانی کنند، تنظیمات استنتاج را حول هدف تأخیر خود تنظیم کنند و بارهای مکالمهٔ حساس را داخل زیرساخت کنترلشده نگه دارند. تعهدات مجوز زیربنایی Nemotron در کنار شرایط BSD متعلق به Pipecat همچنان اعمال میشود.
بعد از این باید چه را دید
PhoneLLM Alpha 1 هنوز عرضهٔ آزمایشی است و فعلاً فقط انگلیسی است. قویترین ادعاها از معیار خود Pipecat میآیند؛ بنابراین آزمون مستقل مهم خواهد بود، بهویژه در لهجههای مختلف، زنجیرههای صوتی نویزی، مکالمههای طولانیتر، طرحوارههای ابزار و ترافیک واقعی تولید.
ایدهٔ پایدارتر از هماکنون روشن است: عملکرد عامل صوتی به مسئلهای سامانهای بدل میشود که تخصصیسازی مدل، پیکربندی ارائه، ارزیابی، تأخیر و هزینه را همزمان در بر میگیرد.
PhoneLLM و PhoneBench این تبادل را صریح میکنند. بهجای پرسیدن کدام مدل زبانی در کل بهتر است، پرسش تولیدی این میشود که کدام مدل برای این عامل، در این هدف تأخیر، با این مجموعه ابزار و این پوشش هزینه بهتر است.