
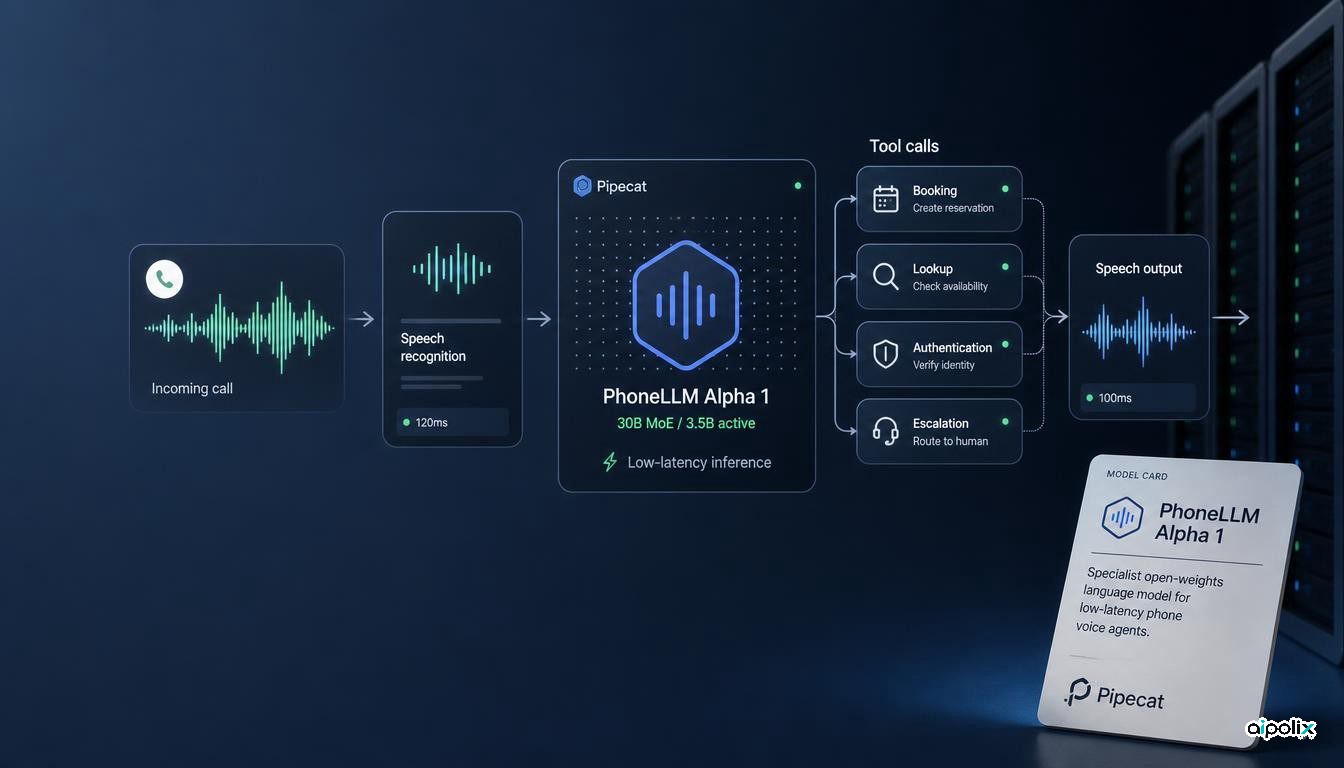
L’équipe Daily de Pipecat a lancé PhoneLLM Alpha 1, un modèle de langue à poids ouverts entraîné spécifiquement pour les agents vocaux téléphoniques. Plutôt que de rivaliser comme modèle généraliste de pointe, PhoneLLM est optimisé autour d’un problème de production plus étroit : répondre vite, conserver l’état sur plusieurs tours et invoquer correctement les outils, sans s’appuyer sur de longues traces de raisonnement.
Cette distinction compte pour les agents vocaux. Dans une interface textuelle, une seconde de latence supplémentaire du modèle peut être gênante. Dans une conversation téléphonique, elle peut faire paraître l’interaction cassée. Pipecat soutient que de nombreux modèles de pointe sont optimisés pour des charges où un temps de raisonnement supplémentaire est acceptable, alors que les agents téléphoniques de production ont souvent besoin d’un autre équilibre entre vitesse, précision des outils et coût.
Un mélange d’experts de 30B avec 3.5B paramètres actifs
PhoneLLM Alpha 1 est un affinage de l’ensemble des paramètres de NVIDIA Nemotron 3 Nano 30B-A3B. Le modèle compte environ 30 milliards de paramètres au total, mais environ 3.5B paramètres actifs par jeton, parce qu’il utilise une architecture en mélange d’experts.
Pipecat a entraîné le modèle avec NVIDIA NeMo et publie les poids sur Hugging Face. La fiche du modèle indique une fenêtre de contexte de 262,144 jetons, l’anglais comme langue prise en charge, et recommande une inférence déterministe avec une température nulle et le raisonnement désactivé.
Le modèle peut être mis en service avec vLLM ou SGLang. Pipecat indique qu’il tient confortablement sur un seul NVIDIA B200 et rapporte un temps P95 jusqu’au premier jeton sub-100 ms pour une requête isolée sur ce matériel. Ces chiffres de mise en service sont des mesures de première partie ; ils doivent être lus comme un guide de déploiement, non comme une validation indépendante des performances.
PhoneLLM n’est pas non plus un modèle de parole à parole. Il occupe la couche de modèle de langue d’une chaîne classique d’agent vocal et est conçu pour fonctionner aux côtés de systèmes de reconnaissance de la parole et de synthèse de texte en parole.
PhoneBench mesure l’économie d’un agent téléphonique
La partie la plus intéressante du lancement est peut-être PhoneBench Alpha 1, le nouveau banc d’essai de Pipecat pour les modèles de langue d’agents téléphoniques.
PhoneBench évalue 15 modèles sur des conversations réalistes de service client à plusieurs tours, y compris les appels d’outils, le comportement d’authentification, la discipline d’escalade, l’ancrage factuel, la cohérence de la conversation et le fait que la réponse parlée du modèle corresponde à l’action réellement effectuée.
Parce que beaucoup de ces propriétés sont difficiles à noter par correspondance exacte de chaînes, Pipecat utilise un panel de juges modèles de langue calibrés sur des annotations humaines. L’équipe indique que les scénarios, les outils et les consignes du banc d’essai sont tenus séparés des données d’entraînement de PhoneLLM.
Le banc d’essai mesure aussi le temps jusqu’au premier jeton de réponse et estime le coût par minute. Cela le rapproche d’une décision de production d’agent vocal plus que d’un critère universitaire classique de langue, où la latence et l’économie de mise en service sont souvent absentes.
Pipecat rapporte une qualité proche de GPT-5.6 Terra à un coût bien moindre
Sur PhoneBench Alpha 1, Pipecat rapporte un score de 72.3% pour PhoneLLM, presque identique aux 72.4% de GPT-5.6 Terra. Gemini 3.6 Flash mène le banc d’essai à 78.6%.
Les chiffres de coût et de latence sont le point où PhoneLLM se distingue dans les résultats de Pipecat. Le banc d’essai estime PhoneLLM à environ $0.0025 par minute de conversation, contre $0.0347 pour GPT-5.6 Terra. Pipecat décrit cela comme environ 94% moins cher.
PhoneBench rapporte aussi PhoneLLM à environ 600 ms de P95 jusqu’au premier jeton de réponse, contre 1,957 ms pour GPT-5.6 Terra, soit un écart d’environ 1.3 seconde.
Ce sont des chiffres notables, mais ils appellent une réserve importante. PhoneBench a été conçu et exécuté par la même organisation qui a entraîné PhoneLLM. Le banc d’essai utilise des juges modèles de langue, des coûts de mise en service estimés et la configuration de production choisie par Pipecat. Les résultats montrent donc comment PhoneLLM se comporte dans le cadre d’évaluation de Pipecat, et non une supériorité établie de manière indépendante.
Le signal plus large est la spécialisation
Le lancement pointe vers un choix d’architecture plus large pour les agents de production.
Un modèle généraliste de pointe est attrayant parce qu’un seul modèle peut traiter de nombreuses tâches. Mais un agent au périmètre étroit n’a souvent besoin ni d’une vaste connaissance du monde ni d’un long raisonnement à chaque tour. Il a besoin d’un usage prévisible des outils, d’une faible latence, d’un comportement de dialogue stable et d’une économie qui monte à des milliers d’interactions.
Pipecat teste en pratique si ces exigences peuvent être déplacées dans les poids du modèle par un affinage ciblé, plutôt que d’être résolues seulement par des consignes et un acheminement vers des modèles plus grands.
Ce schéma pourrait compter bien au-delà des agents téléphoniques. Le soutien client, la prise de rendez-vous, les assistants transactionnels et d’autres flux bornés pourraient de plus en plus recourir à des modèles spécialisés pour la majorité des tours, en envoyant les cas exceptionnels vers des modèles plus grands.
Les poids ouverts changent aussi l’équation de déploiement. Les équipes peuvent héberger PhoneLLM elles-mêmes, régler l’inférence autour de leurs propres cibles de latence et conserver des charges conversationnelles sensibles dans une infrastructure maîtrisée. Les obligations de licence de Nemotron sous-jacent s’appliquent toujours, aux côtés des conditions BSD de Pipecat.
Ce qu’il faudra surveiller ensuite
PhoneLLM Alpha 1 reste une version alpha et, pour l’instant, uniquement en anglais. Les affirmations les plus fortes viennent du banc d’essai de Pipecat lui-même ; un essai indépendant sera donc important, en particulier sur des accents différents, des chaînes audio bruitées, des conversations plus longues, des schémas d’outils et un trafic réel de production.
L’idée plus durable est déjà claire : la performance d’un agent vocal devient un problème de systèmes, impliquant en même temps la spécialisation du modèle, la configuration de mise en service, l’évaluation, la latence et le coût.
PhoneLLM et PhoneBench rendent ce compromis explicite. Au lieu de demander quel modèle de langue est le meilleur en général, la question de production devient quel modèle convient le mieux à cet agent, à cette cible de latence, avec cet ensemble d’outils et cette enveloppe de coût.