
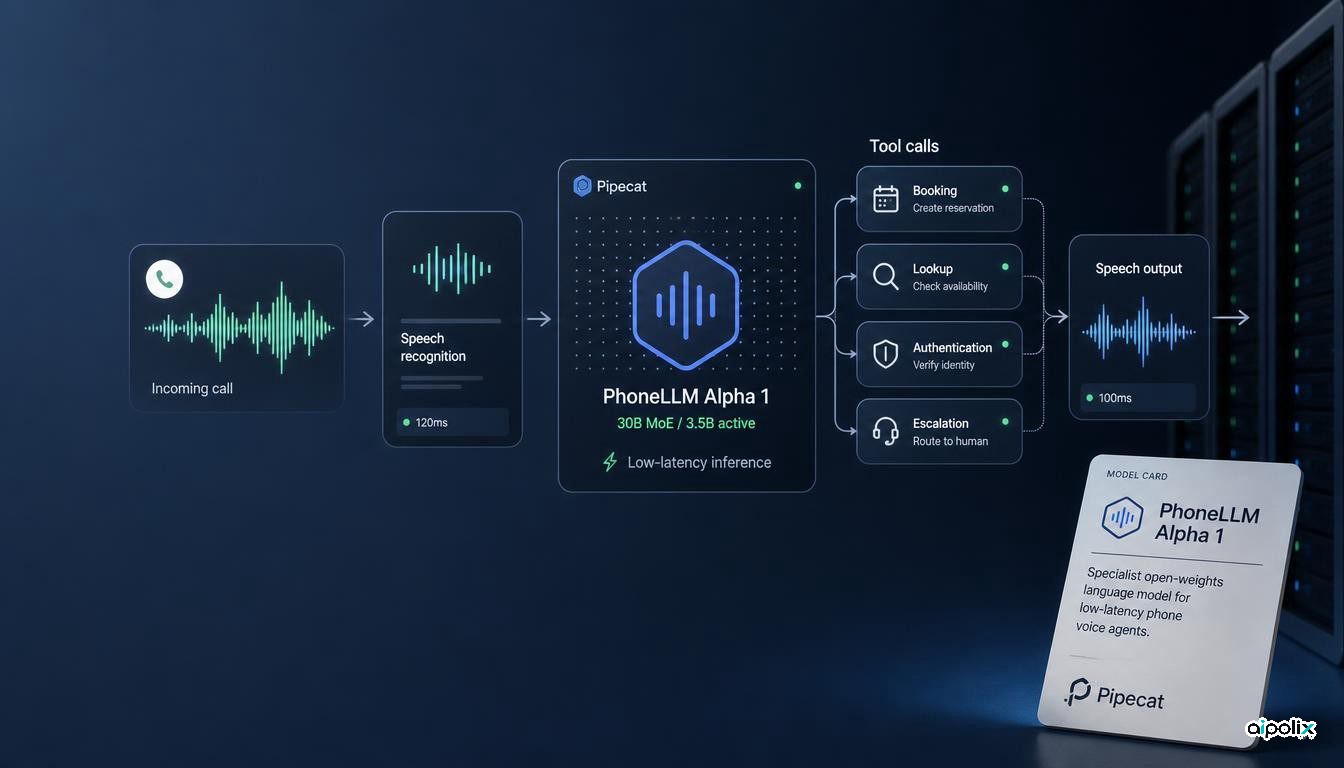
A equipa Daily da Pipecat lançou o PhoneLLM Alpha 1, um modelo linguístico de pesos abertos treinado especificamente para agentes de voz telefónicos. Em vez de competir como modelo geral de fronteira, o PhoneLLM está otimizado em torno de um problema de produção mais estreito: responder depressa, manter estado em vários turnos e invocar ferramentas corretamente, sem depender de rasto longo de raciocínio.
Essa distinção importa para os agentes de voz. Numa interface de texto, um segundo extra de latência do modelo pode ser inconveniente. Numa conversa telefónica, pode fazer a interação parecer partida. A Pipecat argumenta que muitos modelos de fronteira estão otimizados para cargas em que tempo adicional de raciocínio é aceitável, enquanto os agentes telefónicos de produção precisam muitas vezes de um equilíbrio diferente entre velocidade, precisão das ferramentas e custo.
Uma mistura de especialistas de 30B com 3.5B parâmetros ativos
O PhoneLLM Alpha 1 é uma afinação de todos os parâmetros do NVIDIA Nemotron 3 Nano 30B-A3B. O modelo tem cerca de 30 mil milhões de parâmetros no total, mas cerca de 3.5B parâmetros ativos por token porque usa uma arquitetura de mistura de especialistas.
A Pipecat treinou o modelo com NVIDIA NeMo e publica os pesos no Hugging Face. A ficha do modelo indica uma janela de contexto de 262,144 tokens, inglês como língua suportada e recomenda inferência determinística com temperatura a zero e raciocínio desligado.
O modelo pode ser disponibilizado com vLLM ou SGLang. A Pipecat diz que cabe folgadamente num único NVIDIA B200 e relata sub-100 ms de P95 no tempo até ao primeiro token em pedido isolado nesse equipamento. Esses números de disponibilização são medições da própria equipa, pelo que devem ser lidos como orientação de implantação, não como validação independente de desempenho.
O PhoneLLM também não é um modelo de fala para fala. Ocupa a camada de modelo linguístico de uma cadeia convencional de agente de voz e foi concebido para trabalhar ao lado de sistemas de reconhecimento de fala e de síntese de texto em fala.
O PhoneBench mede a economia de um agente telefónico
A parte mais interessante do lançamento pode ser o PhoneBench Alpha 1, o novo critério da Pipecat para modelos linguísticos de agentes telefónicos.
O PhoneBench avalia 15 modelos em conversas realistas de apoio ao cliente com vários turnos, incluindo chamadas a ferramentas, comportamento de autenticação, disciplina de escalamento, ancoragem factual, coerência da conversa e se a resposta falada do modelo corresponde à ação que realmente executou.
Como muitas dessas propriedades são difíceis de pontuar por correspondência exata de cadeias, a Pipecat usa um painel de juízes de modelos linguísticos calibrado com rótulos humanos. A equipa diz que os cenários, as ferramentas e as instruções do critério se mantêm separados dos dados de treino do PhoneLLM.
O critério também mede o tempo até ao primeiro token de resposta e estima o custo por minuto. Isso aproxima-o de uma decisão de produção de agente de voz mais do que de um critério académico convencional de língua, em que a latência e a economia de disponibilização costumam estar ausentes.
A Pipecat relata qualidade próxima do GPT-5.6 Terra a custo muito inferior
No PhoneBench Alpha 1, a Pipecat relata uma pontuação de 72.3% para o PhoneLLM, quase idêntica aos 72.4% do GPT-5.6 Terra. O Gemini 3.6 Flash lidera o critério com 78.6%.
Os números de custo e latência são o ponto em que o PhoneLLM se destaca nos resultados da Pipecat. O critério estima o PhoneLLM em cerca de $0.0025 por minuto de conversa, face a $0.0347 para o GPT-5.6 Terra. A Pipecat descreve isso como cerca de 94% mais barato.
O PhoneBench também relata o PhoneLLM em cerca de 600 ms de P95 no tempo até ao primeiro token de resposta, face a 1,957 ms para o GPT-5.6 Terra, uma diferença de cerca de 1.3 segundos.
São números notáveis, mas exigem um qualificativo importante. O PhoneBench foi concebido e executado pela mesma organização que treinou o PhoneLLM. O critério usa juízes de modelos linguísticos, custos estimados de disponibilização e a configuração de produção escolhida pela Pipecat. Os resultados mostram, por isso, como o PhoneLLM se comporta dentro do quadro de avaliação da Pipecat, não uma superioridade estabelecida de forma independente.
O sinal maior é a especialização
O lançamento aponta para uma escolha de arquitetura mais ampla para agentes de produção.
Um modelo geral de fronteira é atraente porque um só modelo pode tratar muitas tarefas. Mas um agente de âmbito estreito muitas vezes não precisa de conhecimento mundial amplo nem de raciocínio longo em cada turno. Precisa de uso previsível de ferramentas, baixa latência, comportamento estável de diálogo e uma economia que escale a milhares de interações.
A Pipecat está, na prática, a testar se esses requisitos podem ser deslocados para os pesos do modelo através de afinação dirigida, em vez de serem resolvidos apenas por instruções e encaminhamento para modelos maiores.
Esse padrão pode importar bem para além dos agentes telefónicos. O apoio ao cliente, a marcação de horários, os assistentes transacionais e outros fluxos delimitados podem usar cada vez mais modelos especializados na maioria dos turnos, enviando os casos excecionais para modelos maiores.
Os pesos abertos também mudam a equação de implantação. As equipas podem alojar o PhoneLLM nas suas instalações, afinar as definições de inferência em torno dos seus próprios alvos de latência e manter cargas conversacionais sensíveis dentro de infraestrutura controlada. As obrigações da licença Nemotron subjacente continuam a aplicar-se, a par dos termos BSD da Pipecat.
O que convém observar a seguir
O PhoneLLM Alpha 1 continua a ser um lançamento alfa e, de momento, apenas em inglês. As afirmações mais fortes vêm do próprio critério da Pipecat, pelo que o teste independente será importante, em especial com sotaques diferentes, cadeias de áudio ruidosas, conversas mais longas, esquemas de ferramentas e tráfego real de produção.
A ideia mais duradoura já é clara: o desempenho de um agente de voz está a tornar-se um problema de sistemas, envolvendo ao mesmo tempo especialização do modelo, configuração de disponibilização, avaliação, latência e custo.
O PhoneLLM e o PhoneBench tornam esse compromisso explícito. Em vez de perguntar qual o melhor modelo linguístico em geral, a pergunta de produção passa a ser qual o modelo melhor para este agente, neste alvo de latência, com este conjunto de ferramentas e este envelope de custo.