
Infrastructure et puces
-
Nouveaux produits
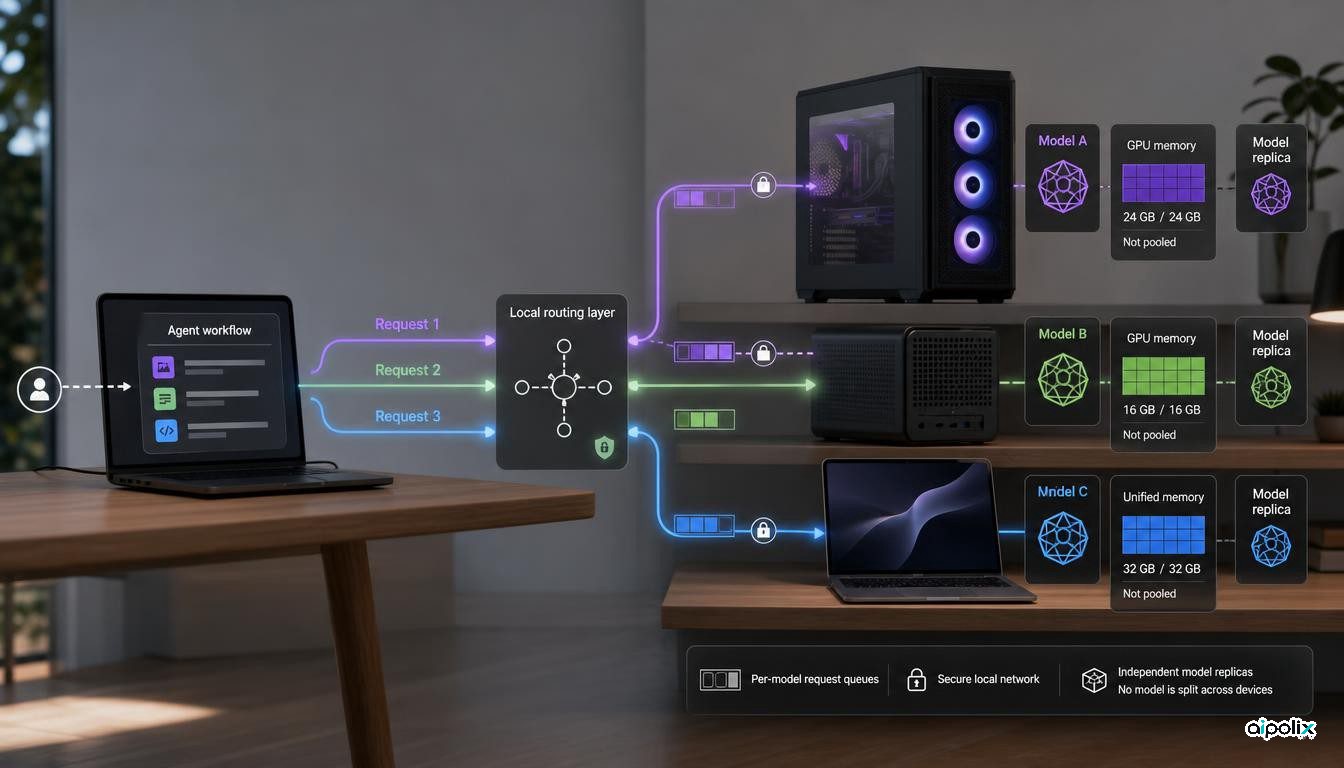
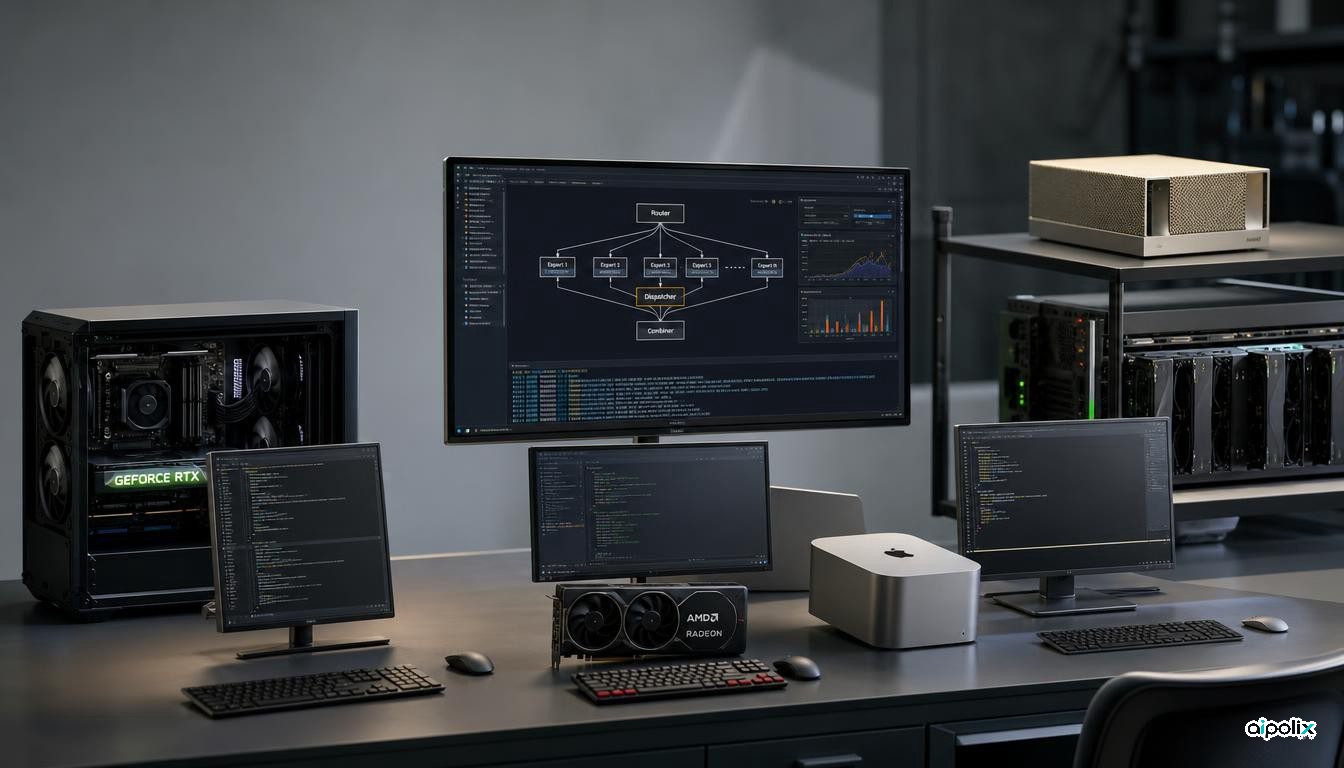
NVIDIA PAIR répartit l’inférence locale entre plusieurs machines
PAIR distribue des requêtes d’IA locales entre plusieurs PC et Mac, sans mutualiser la mémoire GPU ni répartir un même modèle entre machines.
-
Open source
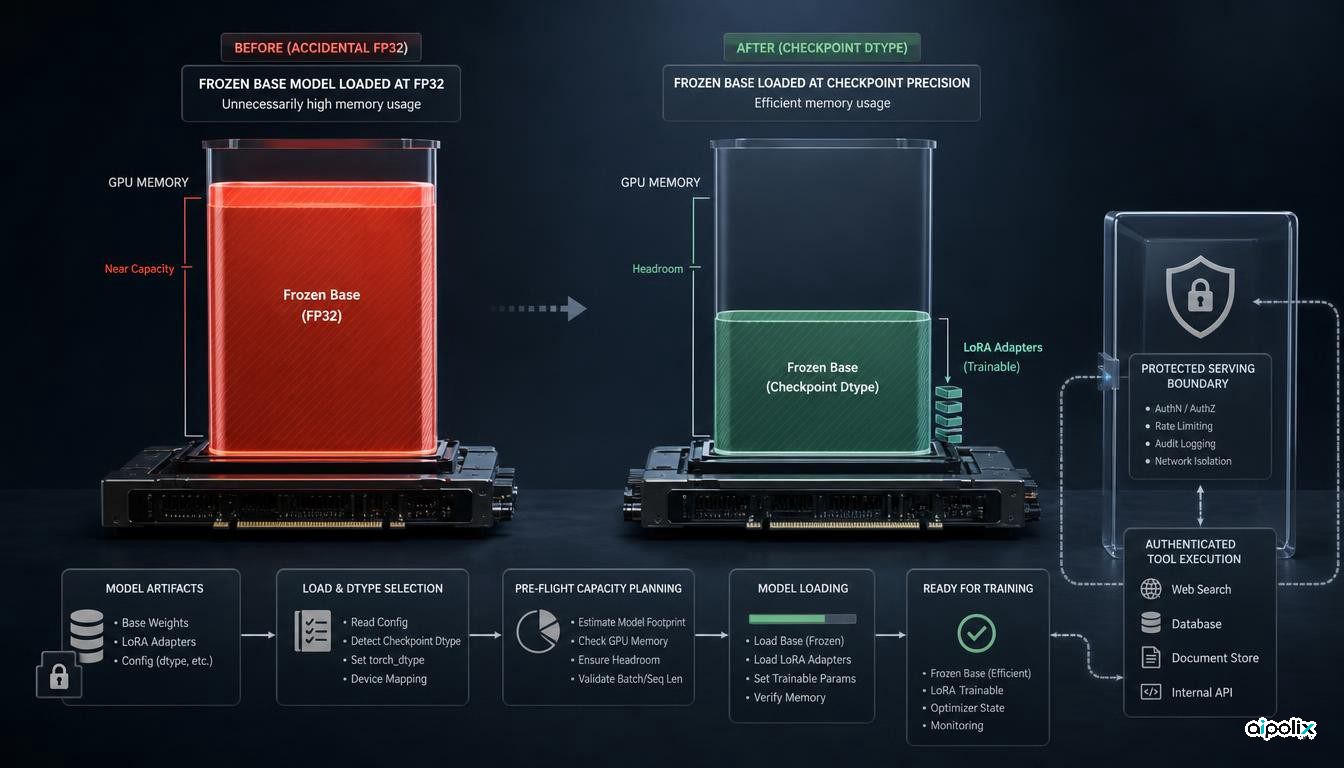
Soup 0.74 corrige un chargement fp32 qui gonflait la mémoire des entraînements LoRA
Soup 0.74.0 corrige un chargement fp32 inutile, publie une forte baisse mémoire sur H100 et durcit plusieurs contrôles de sécurité.
-
Recherche
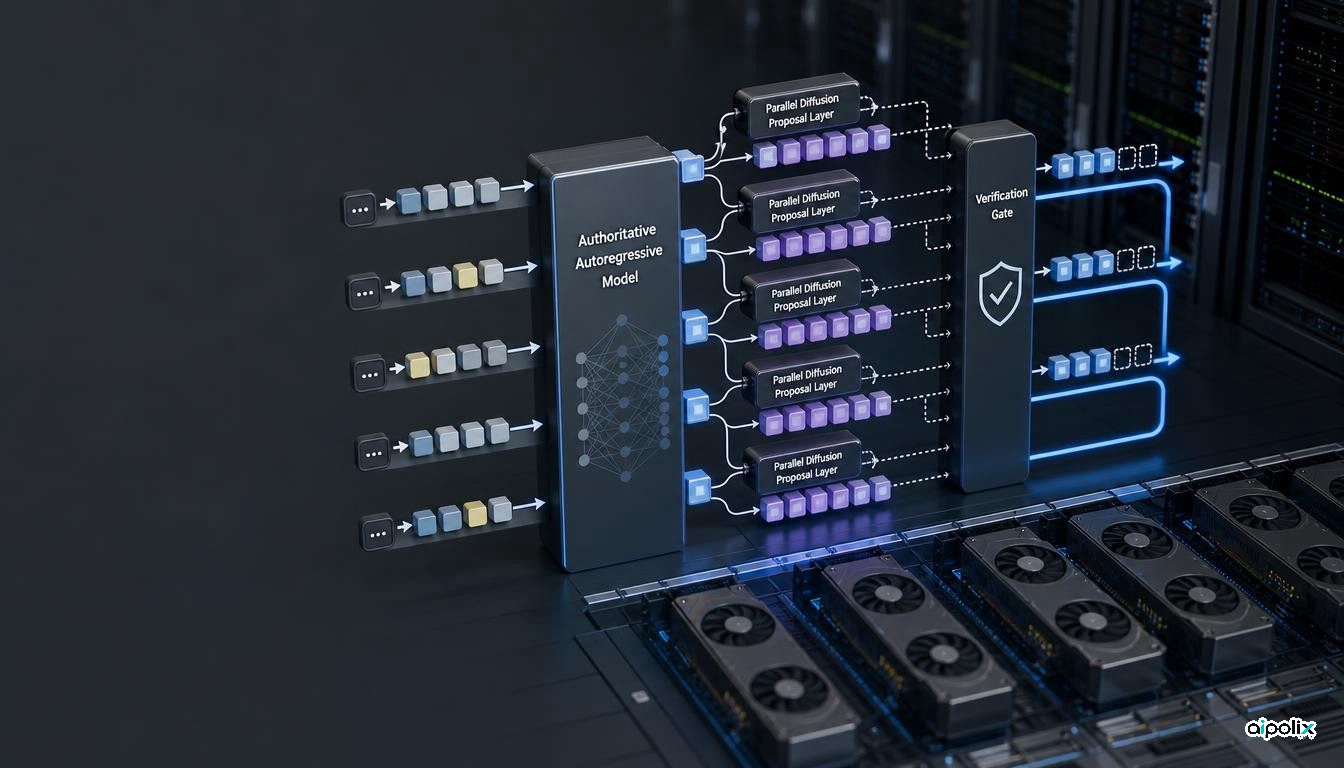
Uno accélère la génération des LLM sans modifier la distribution du modèle de référence
Uno associe des adaptateurs de diffusion à Ψ-Spec pour paralléliser le décodage tout en conservant la distribution du modèle autorégressif.
-
Agents
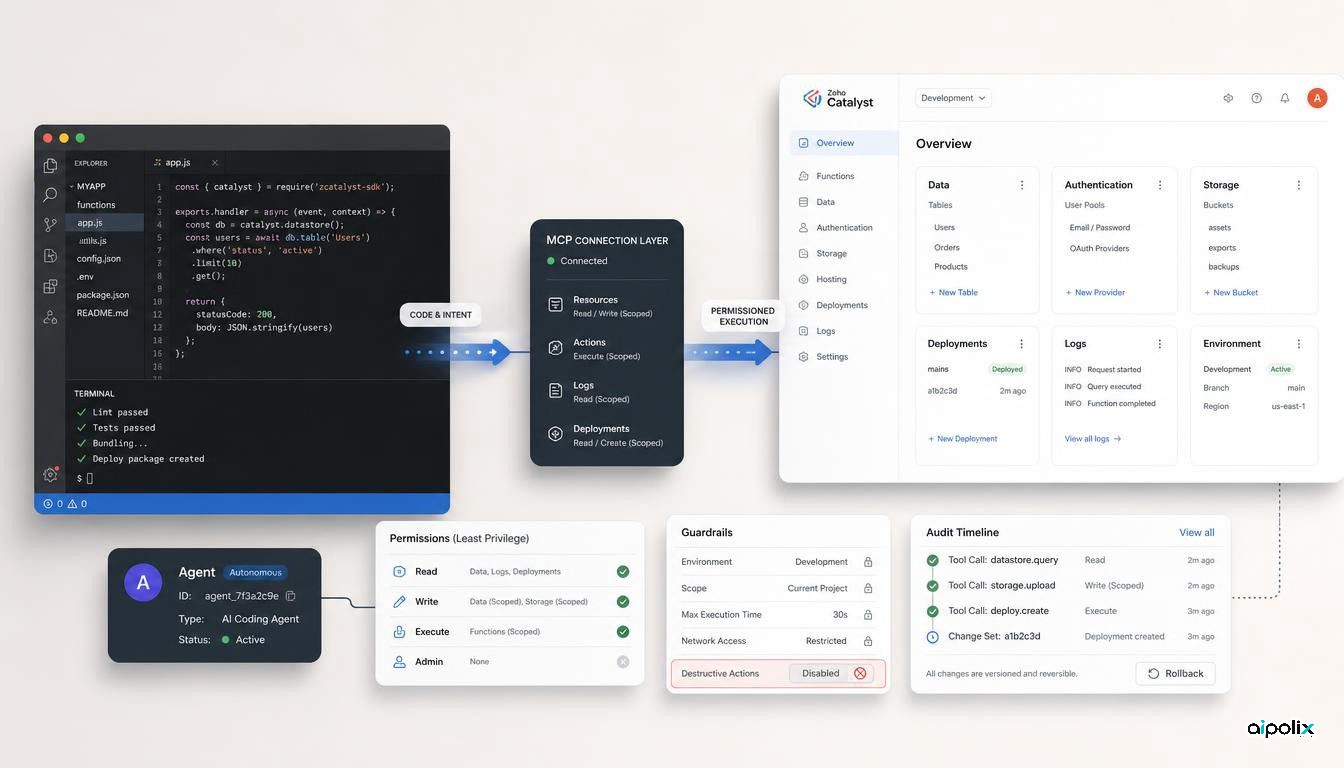
Catalyst 3.0 encadre l'accès des agents de code à l'infrastructure cloud
Zoho relie les agents de programmation à Catalyst via MCP et ajoute permissions dédiées, journaux d'outils et changements réversibles.
-
Open source
La feuille de route FreeToken vise AMD, Apple Silicon et l’expansion multi-GPU
La feuille de route 2026 de FreeToken vise ROCm pour AMD, Metal pour Apple Silicon, DGX Spark, plusieurs GPU, des modèles multimodaux et le décodage spéculatif, au-delà du soutien actuel limité à NVIDIA.
-
Infrastructure et puces
EuroHPC verrouille 387.8 millions d’euros pour la capacité publique de LUMI-AI
LUMI-AI ajoutera une capacité publique de calcul d’IA fondée sur AMD pour les start-up, PME et chercheurs européens, avec une architecture multi-locataires et un accès par API prévus pour 2027.
-
Nouveaux produits
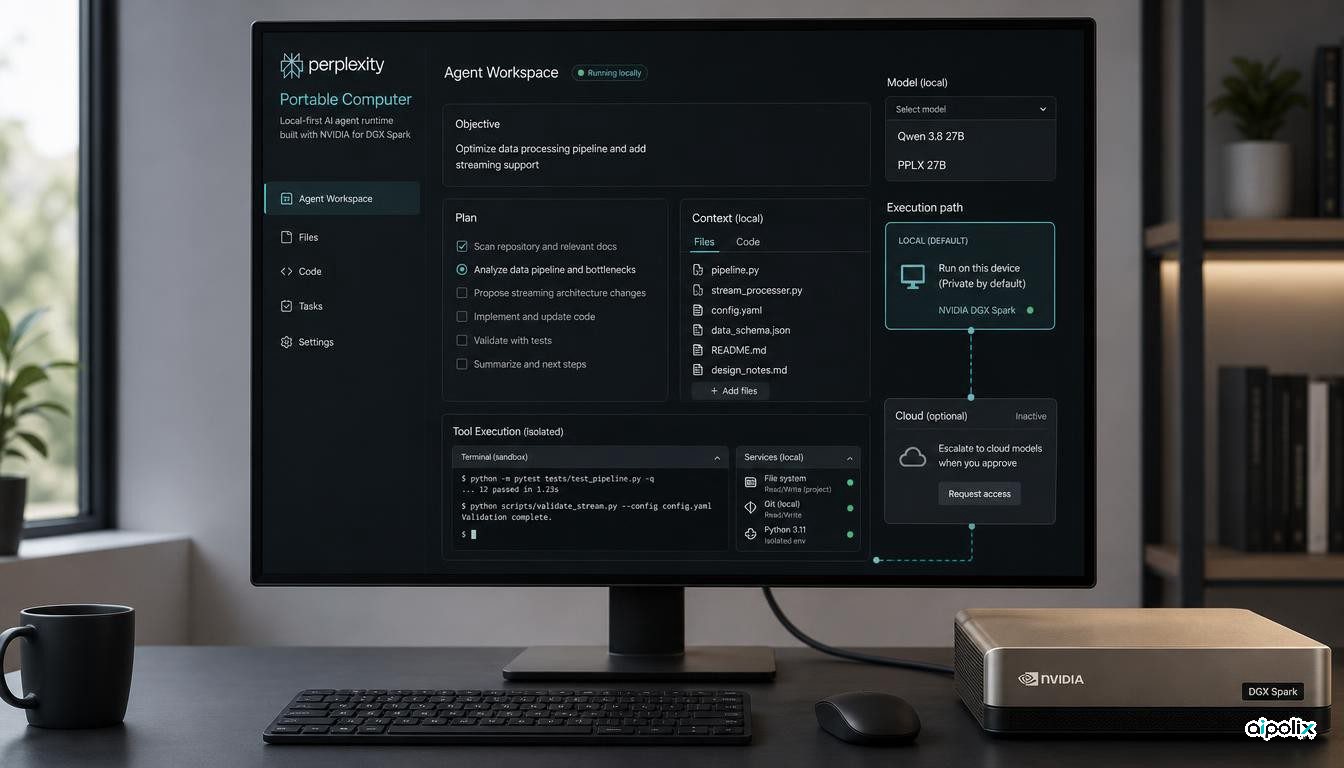
Perplexity déplace son agent Computer sur du matériel NVIDIA local
Portable Computer exécute modèles, orchestration, recherche locale et outils sandboxed sur NVIDIA DGX Spark avec escalade cloud optionnelle.
-
Infrastructure et puces
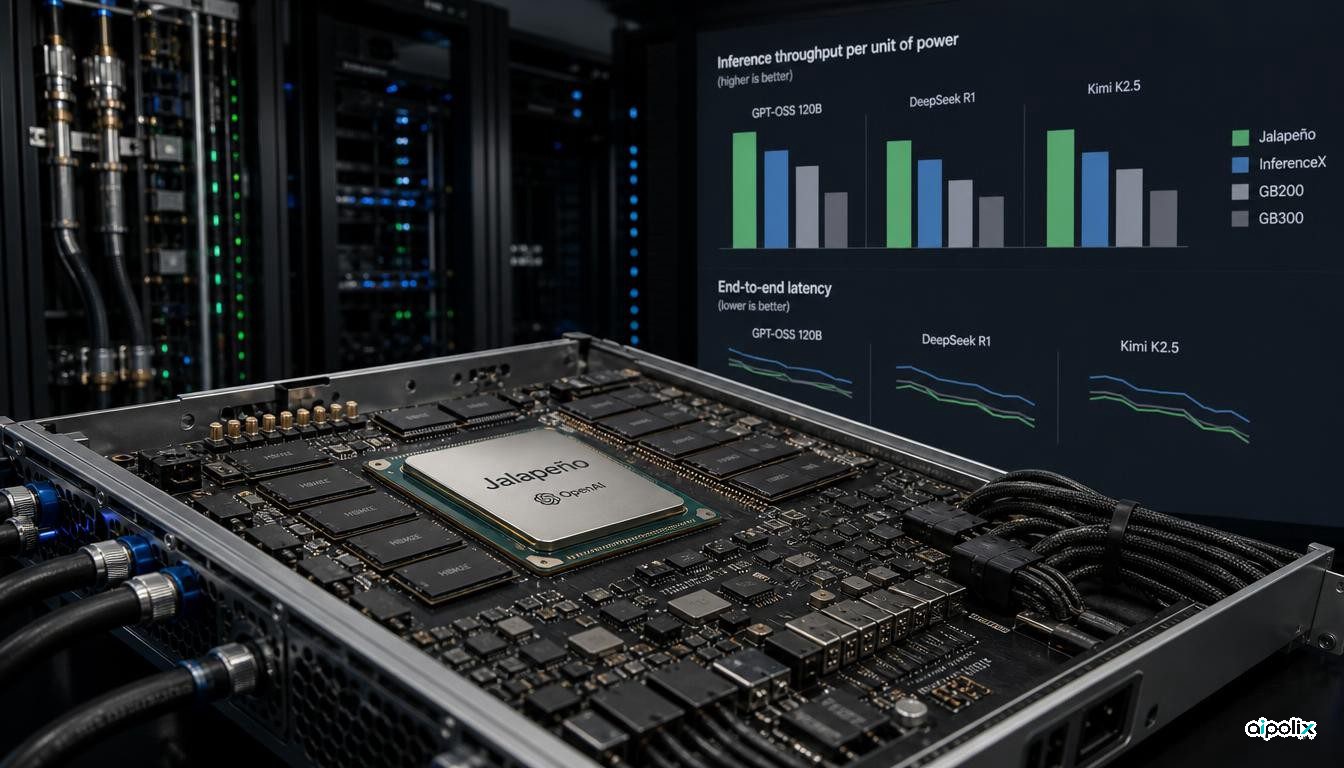
OpenAI place sa puce d’inférence Jalapeño sur la carte des benchmarks
Les premiers benchmarks de Jalapeño montrent des gains de performance par watt et de latence face aux systèmes Nvidia Blackwell actuels.
-
Open source
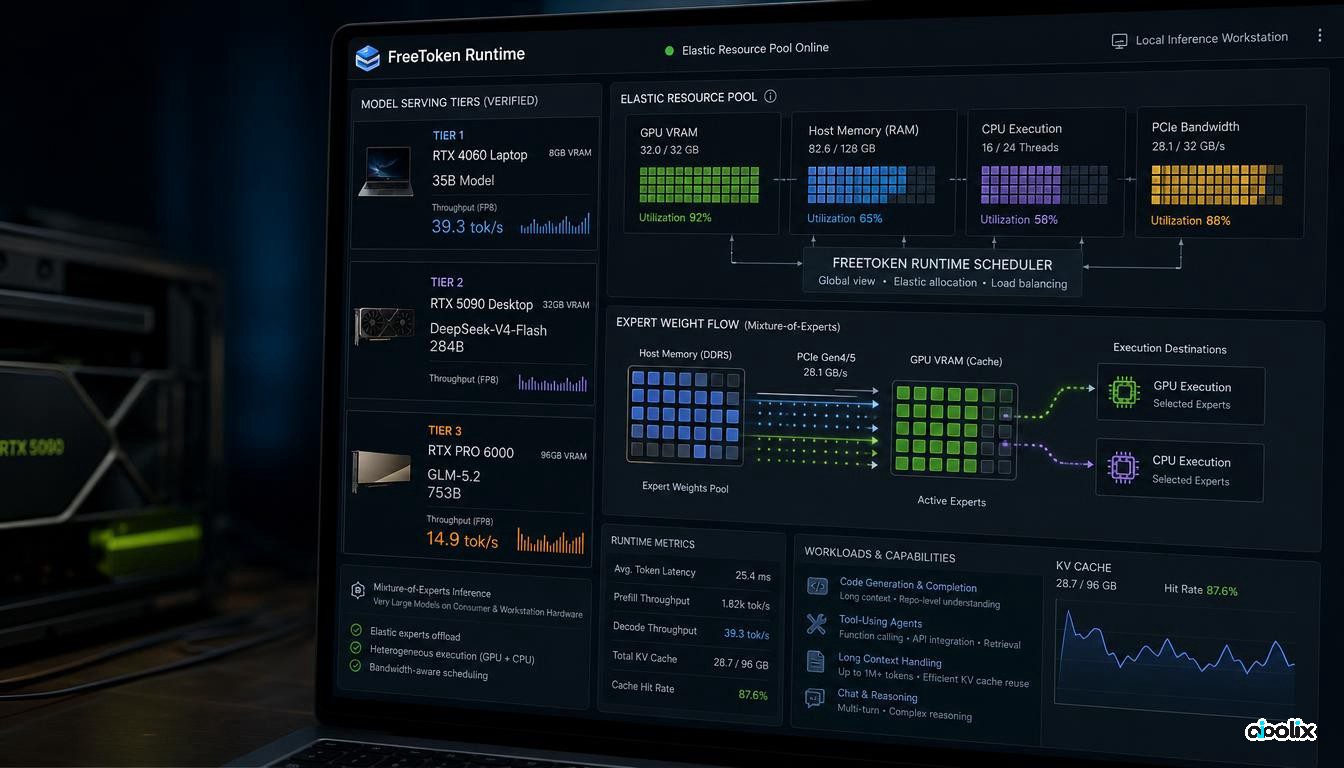
FreeToken exécute des modèles MoE géants sur des GPU grand public
FreeToken combine exécution CPU-GPU adaptative et cache sémantique pour servir des modèles MoE de 35B à 753B sur du matériel local.
-
Les data centers d'IA européens se rapprochent de l'électricité, pas seulement des utilisateurs
Les données de JLL suggèrent que les nouveaux projets hyperscale européens s'éloignent des grands hubs à mesure que l'accès à l'électricité, au foncier et au réseau devient déterminant.