Nouveaux produits
-
Nouveaux modèles
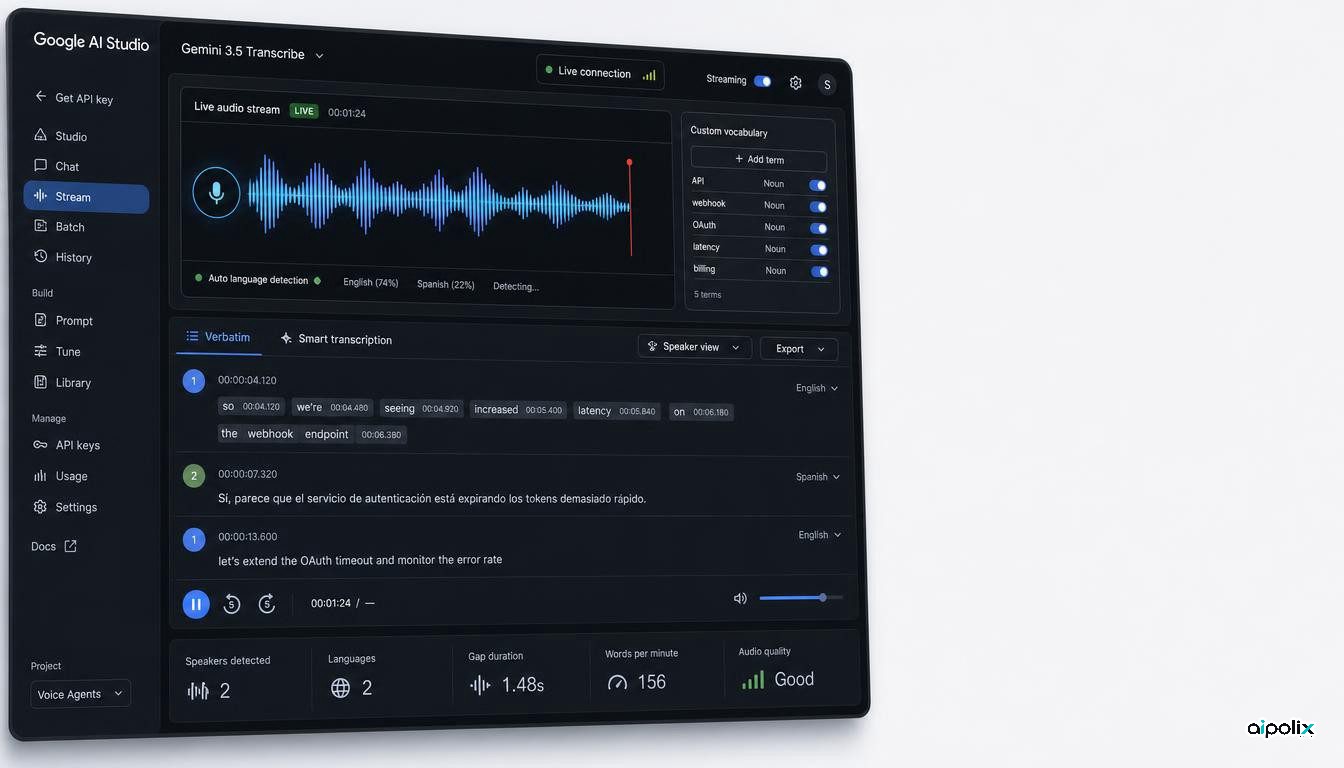
Google transforme Gemini 3.5 Transcribe en stack vocale pour développeurs
Gemini 3.5 Transcribe propose API live et fichiers, 85+ langues, vocabulaire personnalisé, diarisation, timestamps et formatage intelligent.
-
Agents
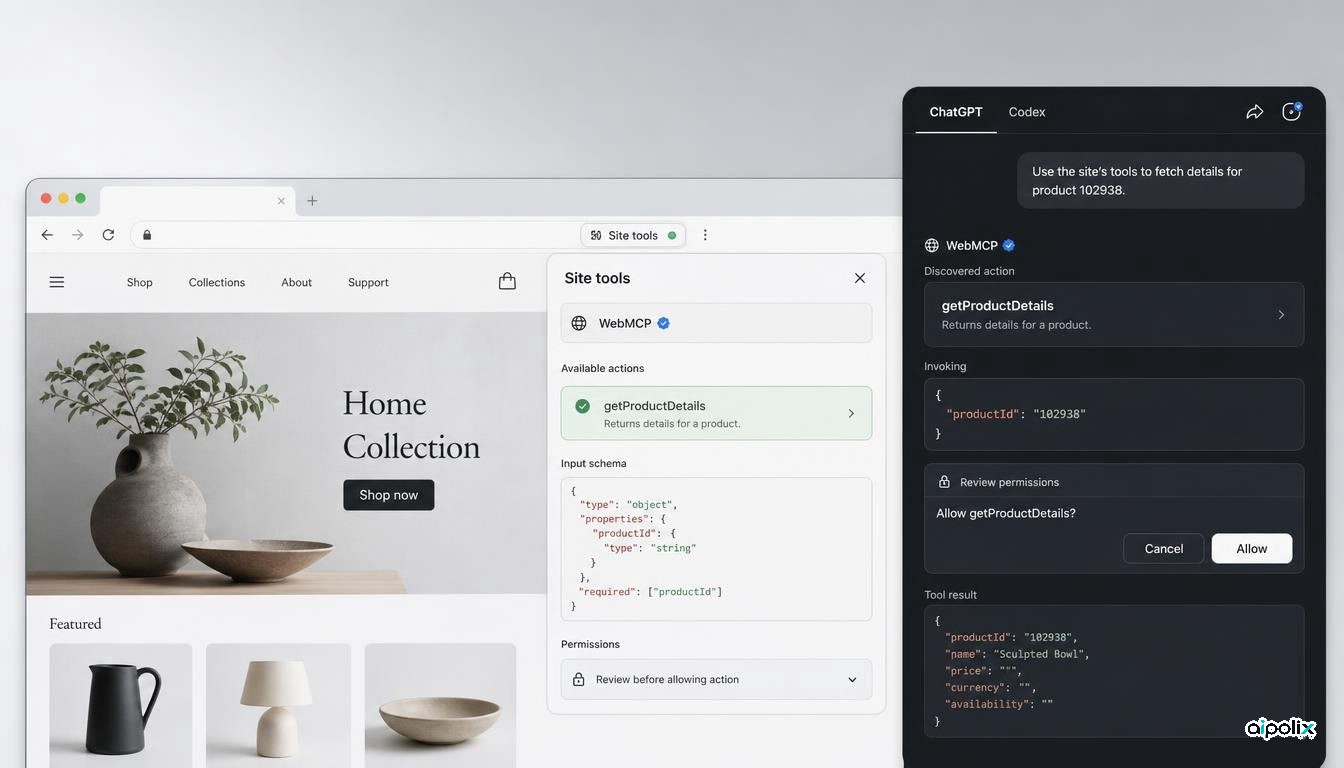
OpenAI donne à ChatGPT et Codex un accès WebMCP structuré aux sites web
OpenAI ajoute les Site tools WebMCP à ChatGPT et Codex afin que les agents de navigateur invoquent des actions structurées dans une session authentifiée.
-
Nouveaux produits
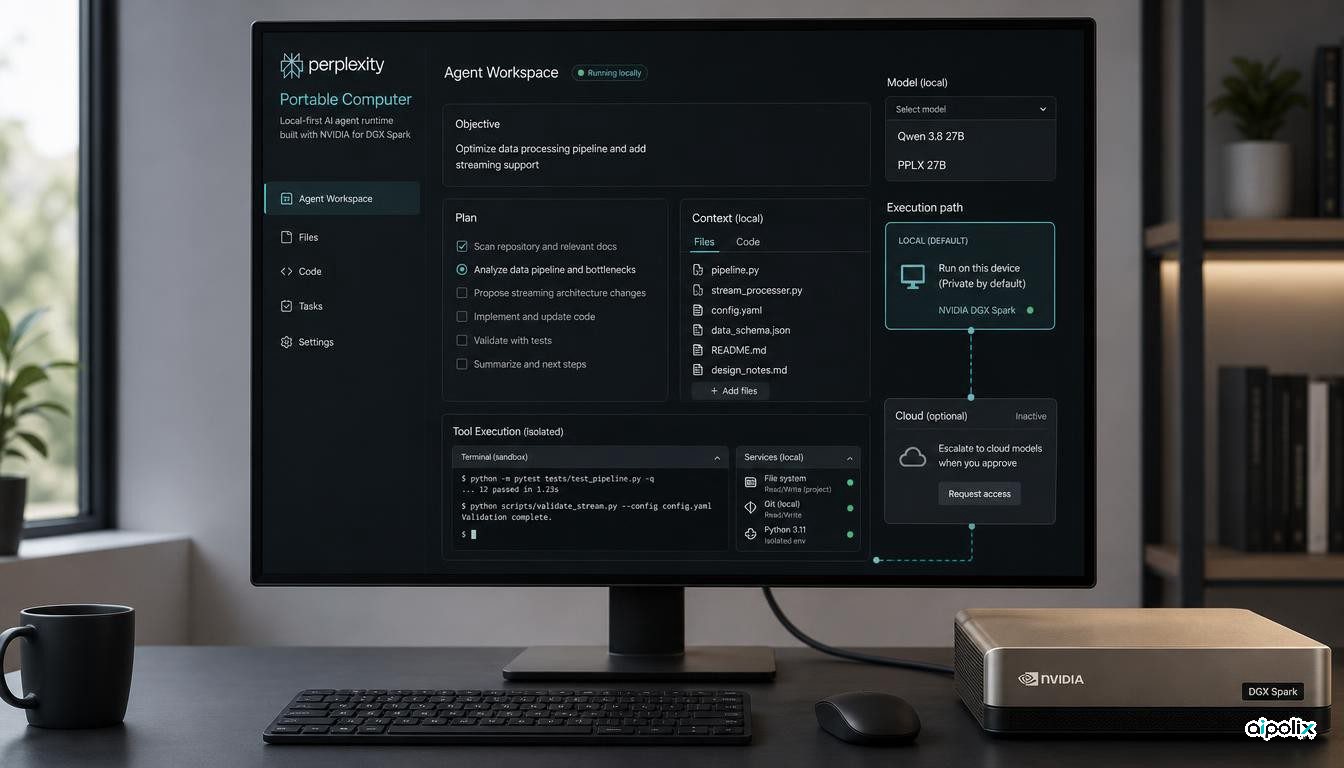
Perplexity déplace son agent Computer sur du matériel NVIDIA local
Portable Computer exécute modèles, orchestration, recherche locale et outils sandboxed sur NVIDIA DGX Spark avec escalade cloud optionnelle.
-
Agents
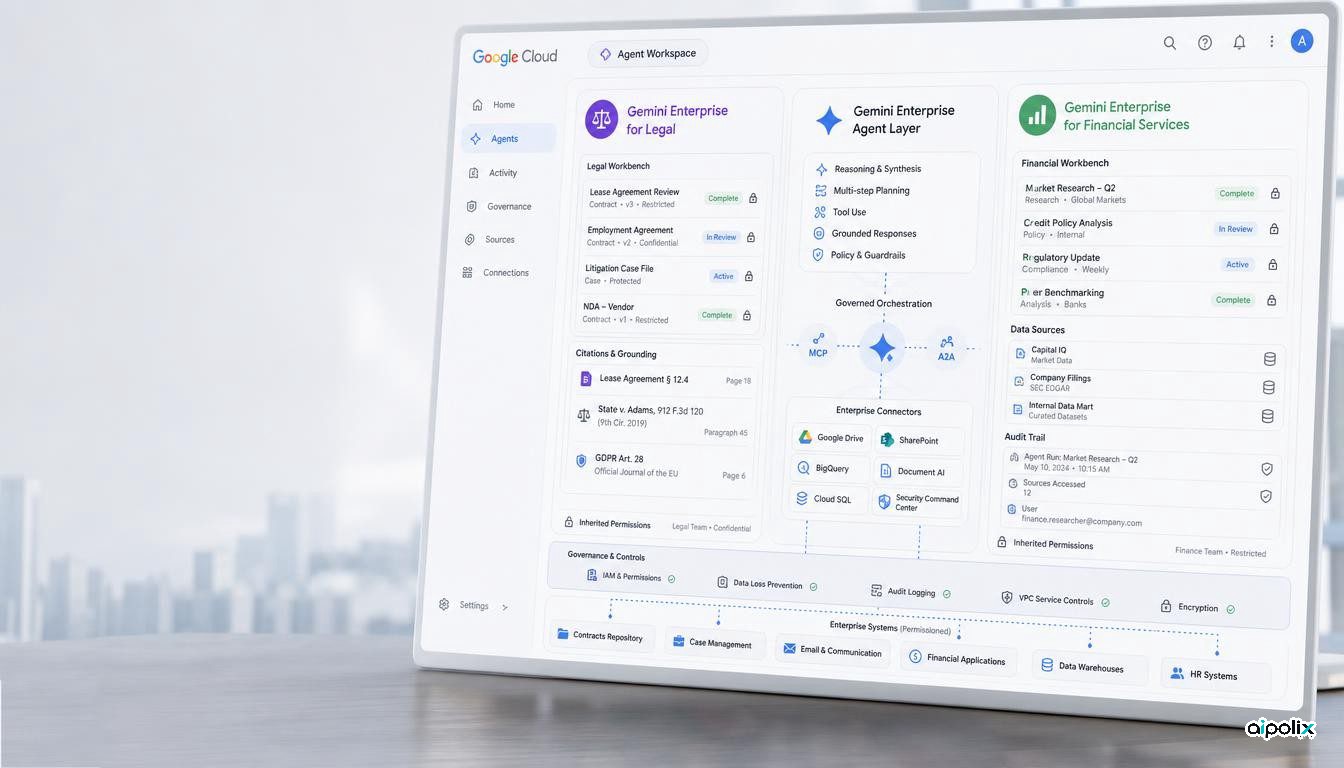
Google spécialise les agents Gemini Enterprise pour le juridique et la finance
Google Cloud lance Gemini Enterprise for Legal et Financial Services avec MCP, A2A, agents gérés et contrôles de gouvernance d'entreprise.
-
Infrastructure et puces
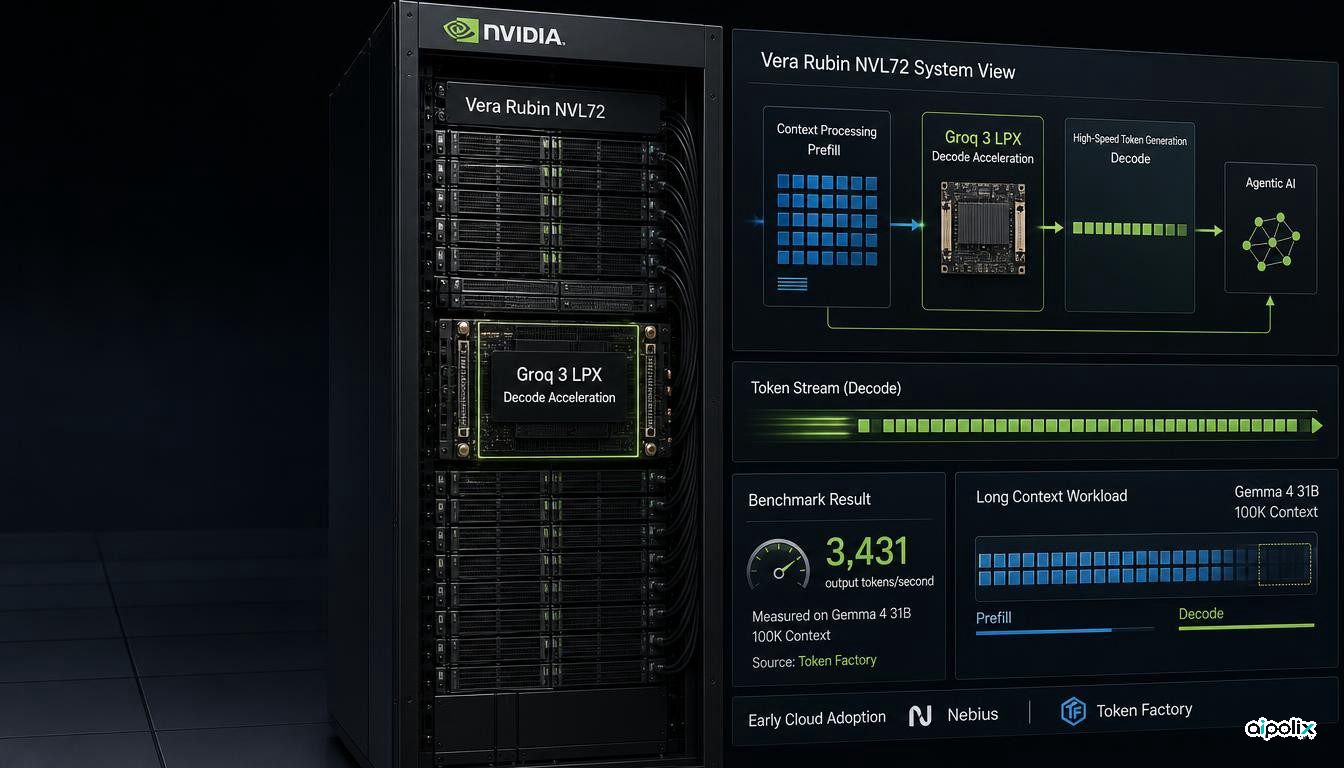
NVIDIA met Groq 3 LPX en production pour accélérer l’inférence des agents
NVIDIA passe Groq 3 LPX en production avec Vera Rubin pour cibler la latence de décodage des agents riches en tokens, avec Nebius comme premier adopteur cloud.
-
Nouveaux modèles
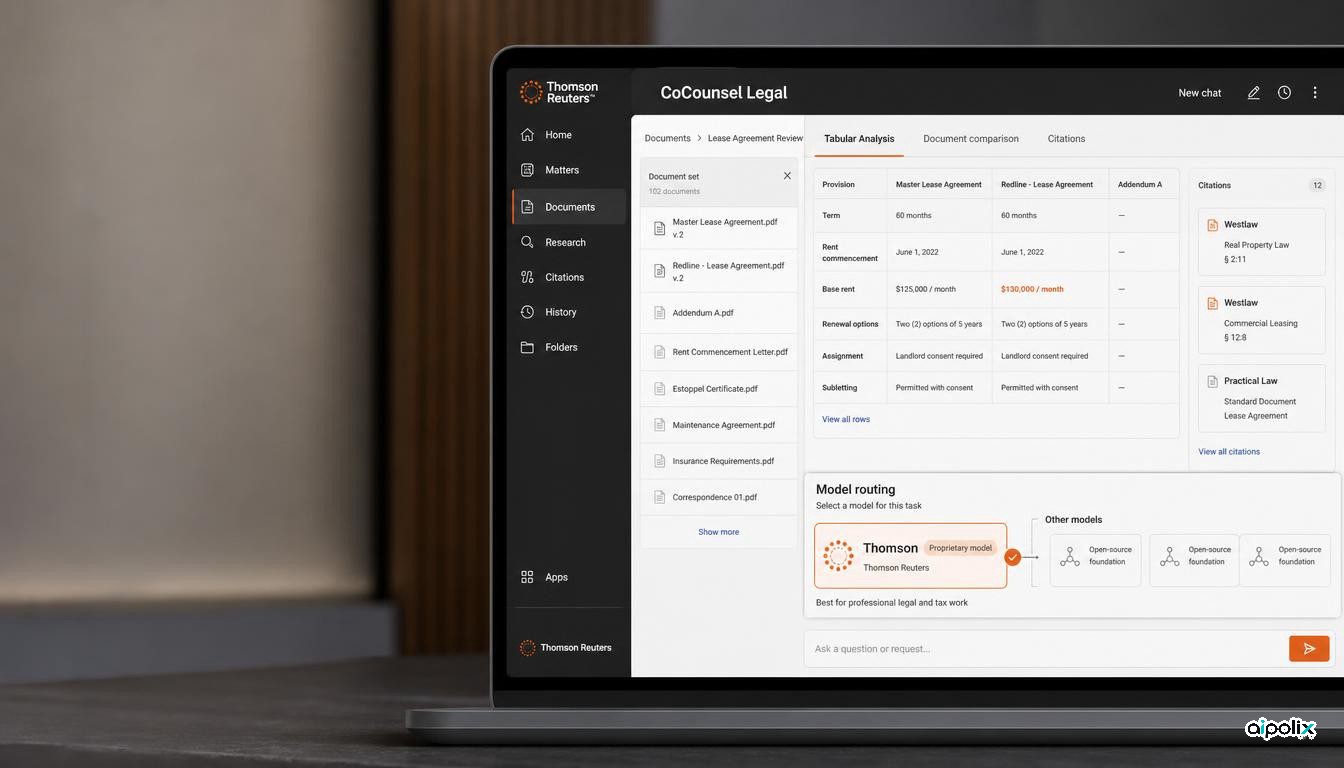
Thomson Reuters lance son propre LLM pour les workflows professionnels
Thomson Reuters lance un LLM propriétaire développé pour 40 M$, d'abord intégré à CoCounsel Legal tout en conservant une architecture multi-modèles.
-
Nouveaux modèles
DeepSeek ajoute la vision à V4 Flash pour les agents multimodaux
DeepSeek ajoute la compréhension d’images et une Files API à V4 Flash, ouvrant une option multimodale moins coûteuse pour les agents, encore expérimentale.
-
Nouveaux modèles
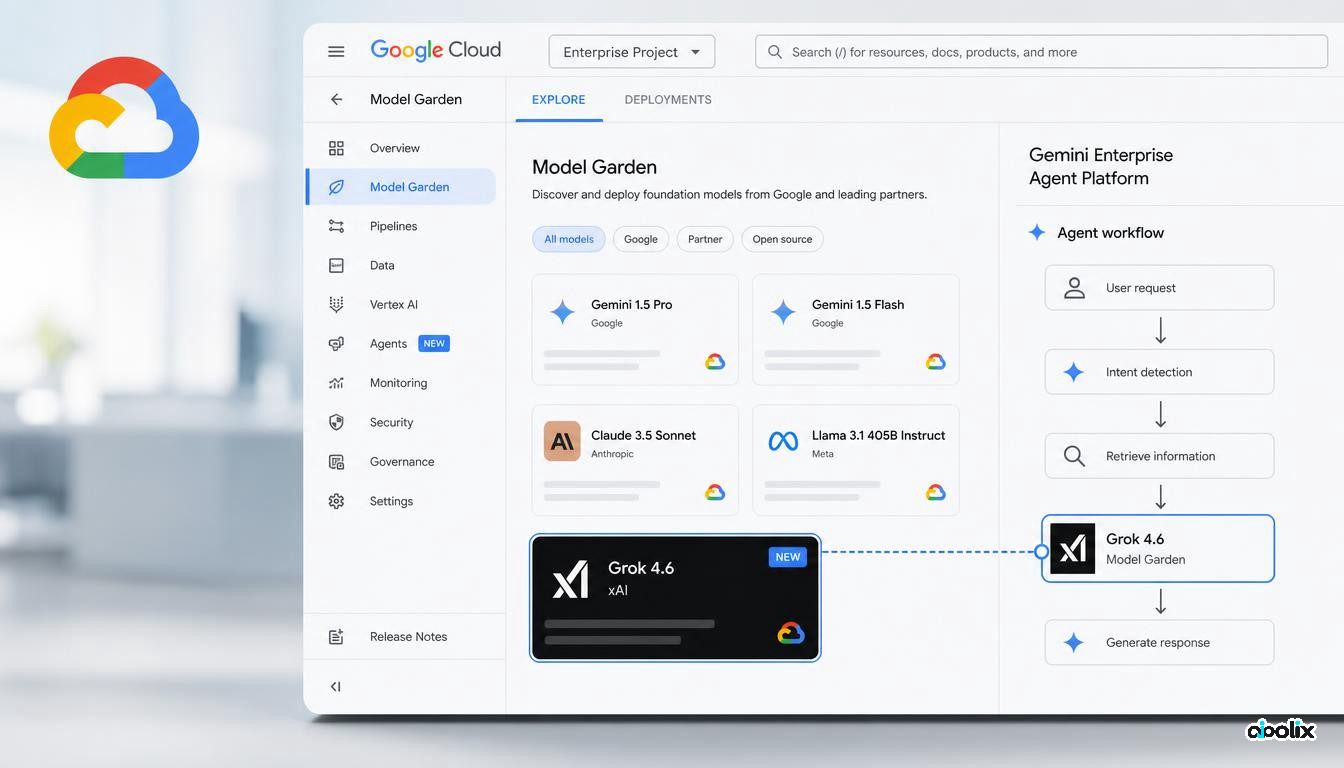
Grok 4.6 rejoint le catalogue de modèles d’entreprise de Google
Google ajoute Grok 4.6 en Preview à Gemini Enterprise Agent Platform, avec grand contexte, reasoning, function calling et quotas fixes au lancement.
-
Nouveaux produits
OpenAI teste le mode Ultrafast pour l'IA en temps réel
OpenAI teste un nouveau mode d'inférence Ultrafast destiné aux applications sensibles à la latence. GPT-5.4 Mini pourrait atteindre jusqu'à 1 000 tokens par seconde, selon l'entreprise. Source OpenAI — Previewing Ultrafa…
-
Nouveaux produits
OpenAI ralentit l'entraînement de ses modèles de pointe face aux risques cyber
OpenAI suspend une partie de l'entraînement de ses modèles de pointe et renforce la sécurité de ses infrastructures face aux capacités cyber croissantes de l'IA.