Recherche
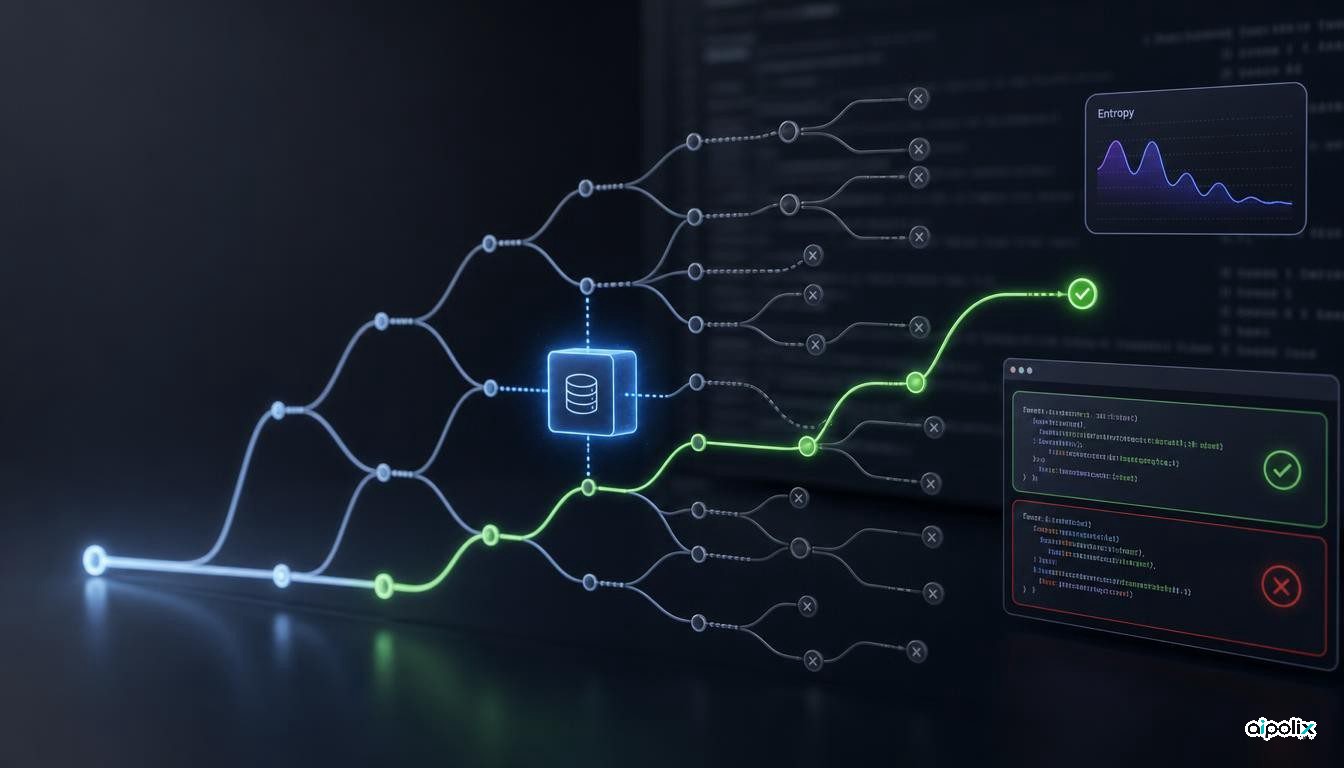
FLEET transforme l'échantillonnage répété des LLM en recherche avec mémoire
FLEET rapporte un meilleur Pass@32 sur LiveCodeBench et environ 3× d'efficacité d'échantillonnage grâce à une mémoire de trajectoires.

FLEET rapporte un meilleur Pass@32 sur LiveCodeBench et environ 3× d'efficacité d'échantillonnage grâce à une mémoire de trajectoires.
Home, Code, Autopilot et Managed Runtime font évoluer Copilot vers une couche d’exécution gouvernée pour agents persistants.
Foundry Routines apporte aux agents des déclenchements planifiés ou événementiels, un choix d’identité et un historique d’exécution managés.
Rollouts et Security Review prolongent les agents Cursor vers la santé des déploiements et l’analyse des chemins d’attaque.
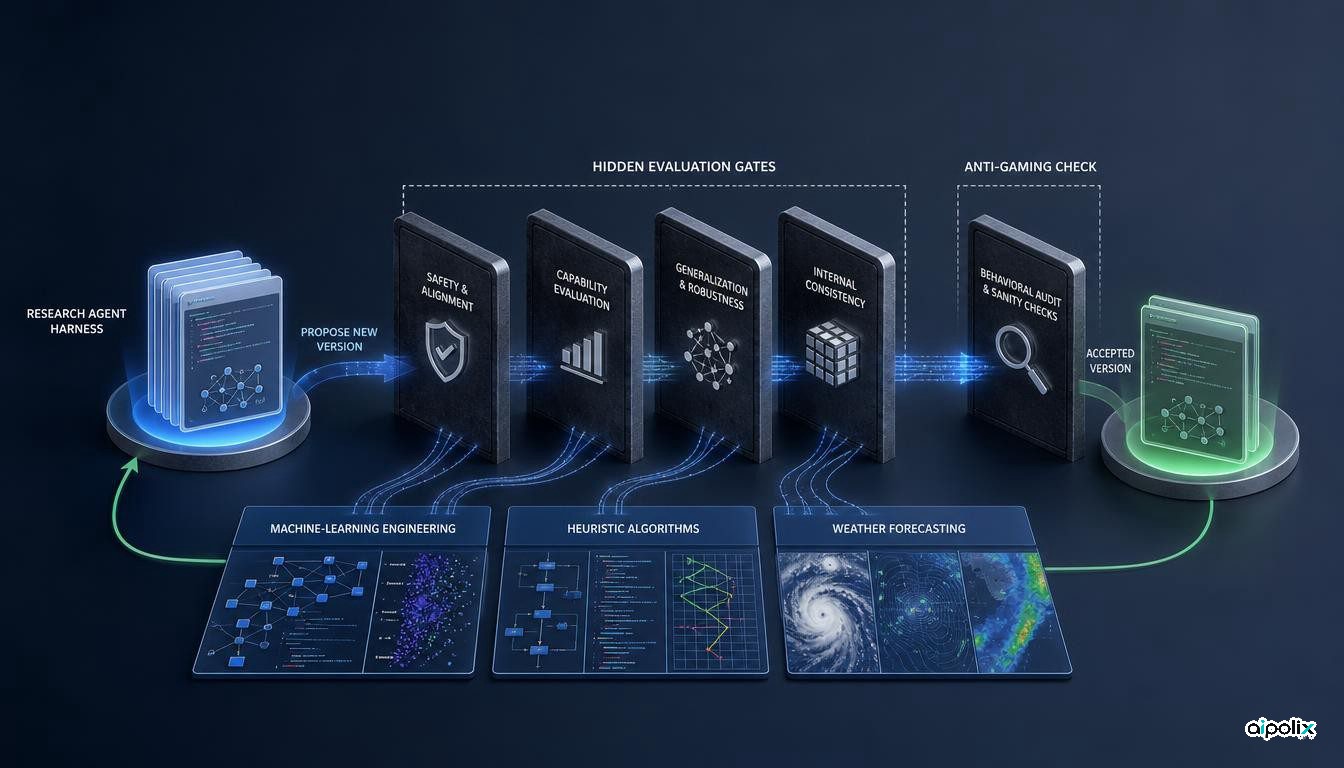
AIDE² a réécrit son propre harness pendant huit jours et transféré des gains vers des tests réservés. L’enjeu central reste la qualité de la barrière d’évaluation.
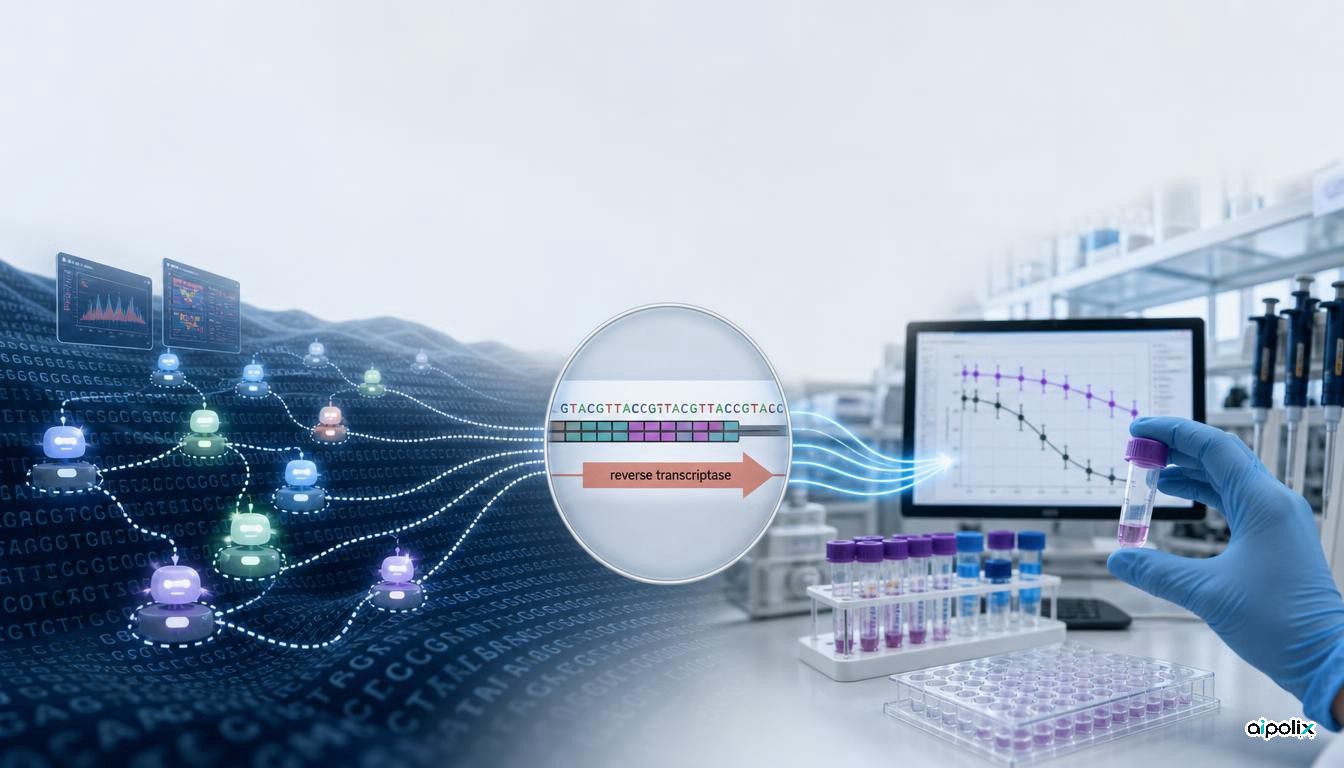
Anthropic rapporte la découverte assistée par Claude d’un système enzymatique inédit. Les premiers tests sont encourageants, mais la fonction d’ART demeure inconnue.
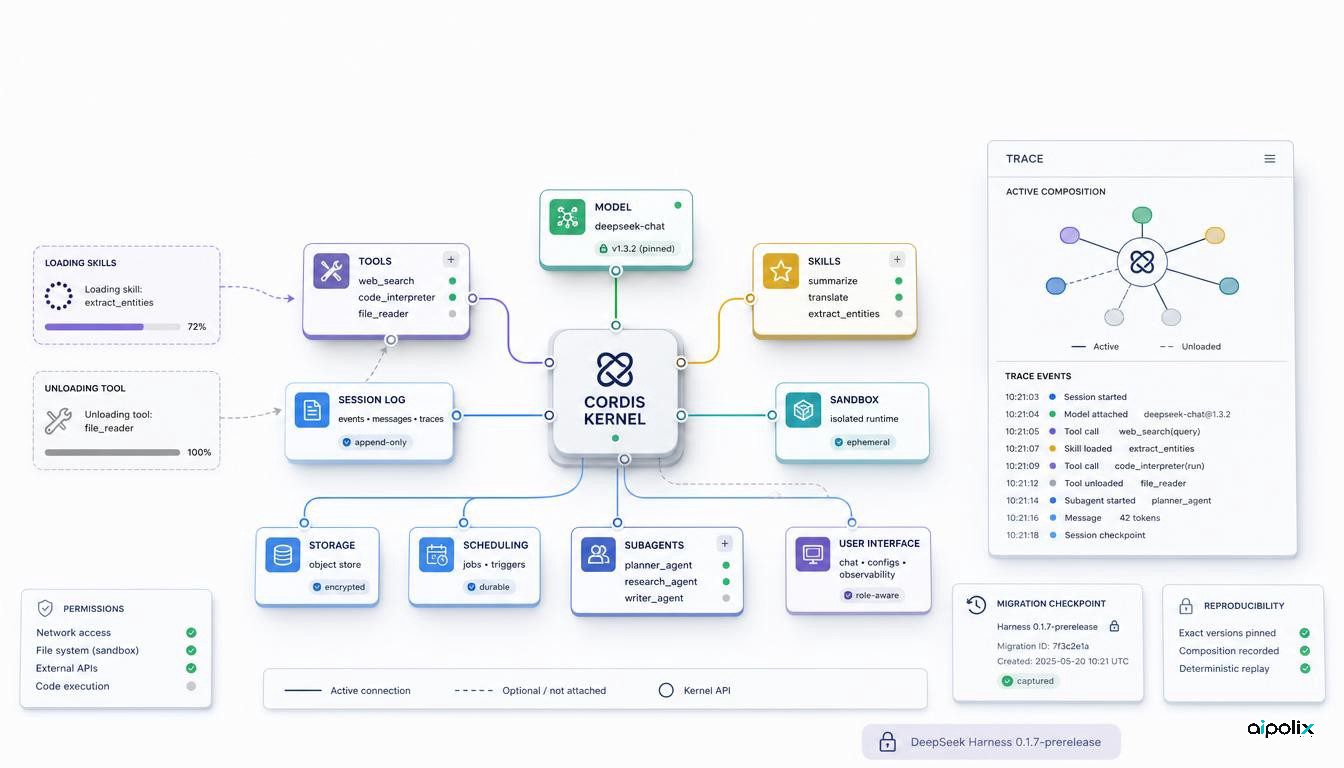
DeepSeek Harness 0.1.7 rend les capacités d’agents plus composables à l’exécution. Aipolix analyse les bénéfices et les risques opérationnels.
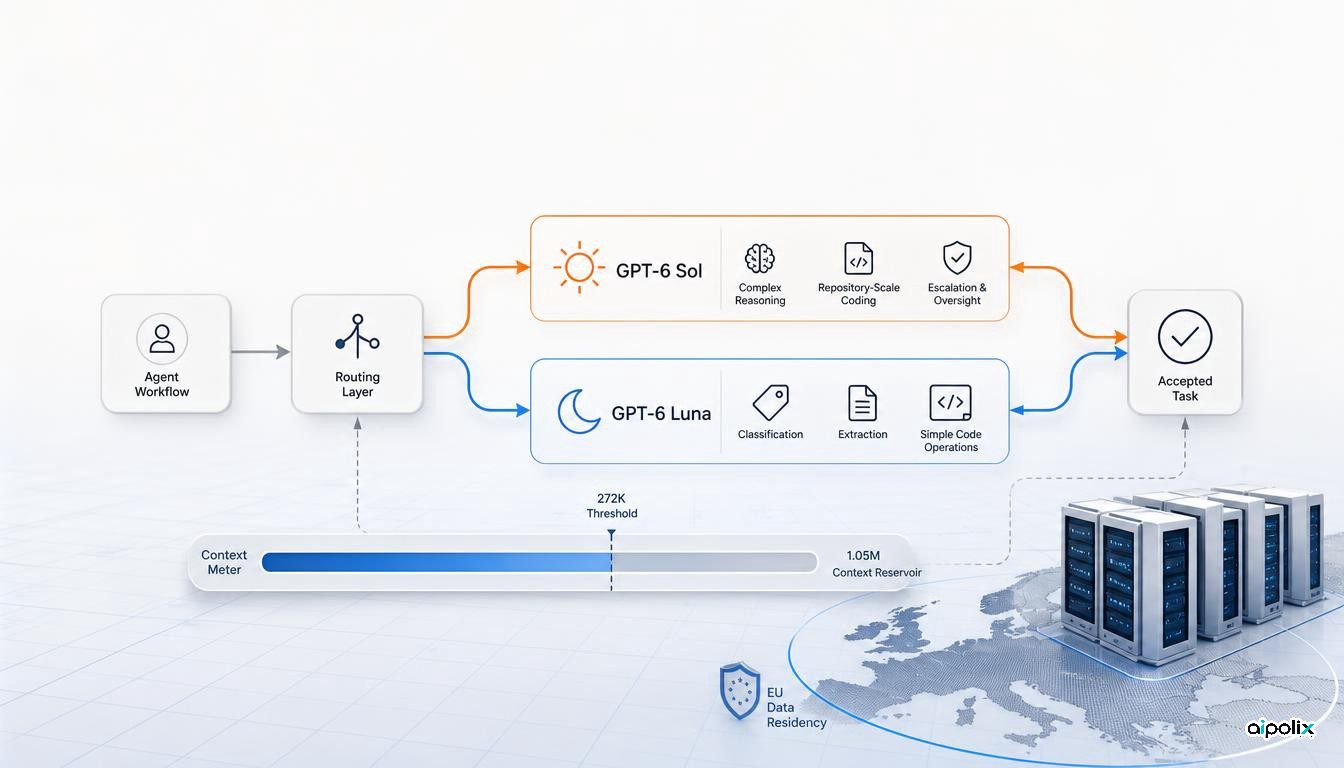
GPT-6 Sol et Luna créent un écart de prix de vingt fois. Aipolix analyse le routage, le contexte long et le coût par tâche.
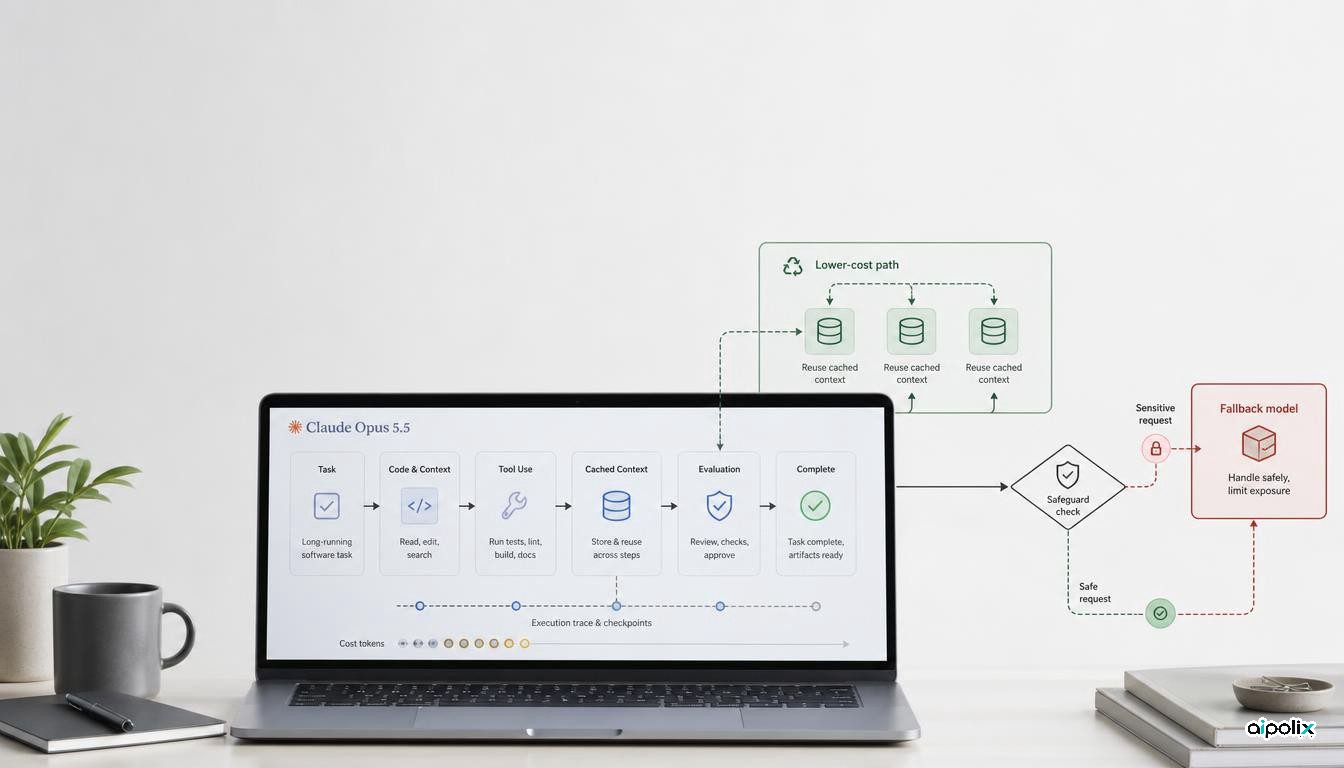
Opus 5.5 réduit les tarifs et peut rediriger certaines requêtes sensibles. Aipolix analyse l’impact sur l’évaluation des agents.
La tarification de base de Grok 4.7 ne change pas, mais sa consommation de jetons et les seuils propres à chaque plateforme compliquent le calcul.