
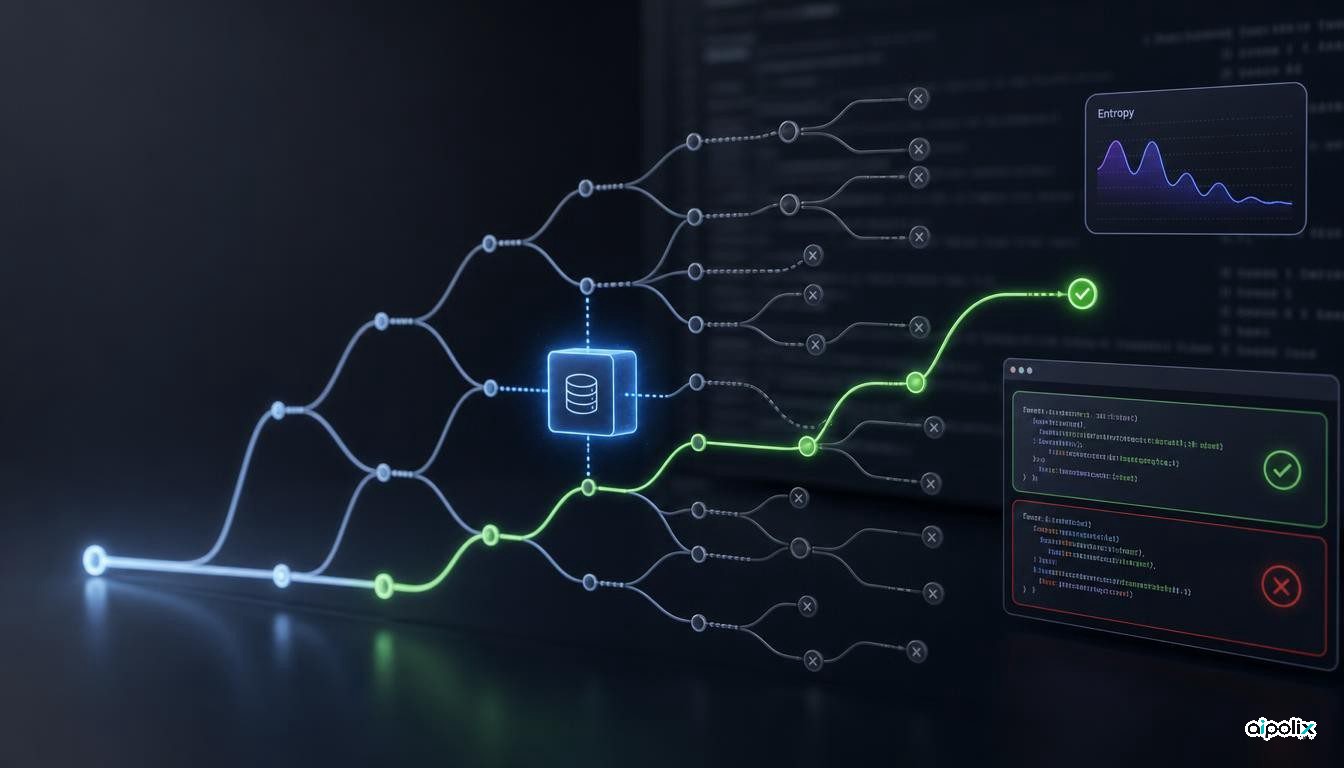
FLEET propose une nouvelle méthode de décodage à l'inférence qui s'attaque à une faiblesse simple mais coûteuse de l'échantillonnage répété des modèles de langage : chaque nouvelle complétion ignore normalement ce que les précédentes ont déjà essayé. Les auteurs soutiennent que les approches de type pass@k gaspillent ainsi une partie du budget de calcul sur des réponses sémantiquement proches ou sur des branches déjà infructueuses. FLEET ajoute une mémoire au processus de génération et transforme l'échantillonnage répété en recherche structurée autour des points de décision les plus incertains.
Dans le principal résultat du papier, FLEET fait passer le Pass@32 de LiveCodeBench de 59,9 % à 66,2 % dans la configuration évaluée et atteint, selon les auteurs, la précision de la baseline d'échantillonnage répété avec environ trois fois moins d'échantillons. L'intérêt vient du fait que le gain vise l'efficacité à l'inférence plutôt que l'augmentation de la taille du modèle ou du volume d'entraînement.
Le problème n'est pas de manquer de diversité partout
Le temperature sampling injecte de l'aléa à chaque token. Cela peut aider le modèle à sortir d'une mauvaise branche pourtant très probable, mais cela ajoute aussi du bruit dans les parties d'une solution où le modèle était déjà stable.
FLEET cherche à distinguer ces deux cas. La méthode observe l'entropie et la varentropie des états internes du modèle pour repérer les points qui ressemblent à de véritables bifurcations. Une structure VectorDSU regroupe les états cachés similaires afin de mémoriser les actions déjà explorées et la qualité des trajectoires correspondantes.
Les récompenses obtenues après des trajectoires complètes alimentent ensuite une recherche inspirée de pUCT. Au lieu d'augmenter globalement la température, FLEET pénalise certaines actions déjà testées lorsqu'elles semblent moins utiles et oriente les générations suivantes vers d'autres branches. Dans la configuration évaluée, le décodage reste glouton et déterministe une fois ces pénalités appliquées.
La répétition d'inférence change donc de nature : les nouvelles tentatives ne sont plus des tirages indépendants dans la même distribution, mais utilisent les résultats des tentatives précédentes.
Le résultat sur le code est significatif, mais étroit
L'étude évalue FLEET sur GSM8K et sur un sous-ensemble filtré de LiveCodeBench avec Llama 3.2 3B et 32 trajectoires par problème. Avec une vérification par vérité terrain, le Pass@32 de LiveCodeBench passe de 59,9 % à 66,2 %, soit 147 problèmes résolus sur 222 contre 133 pour la baseline. Le gain est beaucoup plus faible sur GSM8K, où la baseline est déjà proche de la saturation.
Les auteurs testent aussi un Outcome Reward Model comme substitut plus réaliste à une vérification parfaite. C'est un point important pour le déploiement : dans un système réel, la correction objective d'une réponse n'est souvent pas immédiatement disponible. Les résultats montrent que la qualité de la recherche et la sélection finale dépendent alors en partie de la qualité du signal de récompense.
C'est une limite centrale. Un meilleur moteur de recherche peut produire de meilleurs candidats tout en choisissant finalement le mauvais si l'évaluateur est mal calibré.
Le meilleur terrain est l'inférence auto-hébergée
Le dépôt officiel fournit le paquet fleet-search et des exemples avec Transformers, nnsight et Ray. FLEET n'est toutefois pas un remplacement transparent d'une API hébergée classique.
L'implémentation nécessite un accès white-box aux états cachés du modèle. La méthode est donc immédiatement plus pertinente pour les équipes qui servent des modèles open-weight ou contrôlent leur propre pile d'inférence que pour les développeurs limités à une API fermée.
Pour les agents de code, l'environnement le plus favorable est celui où un vérificateur déterministe et peu coûteux existe déjà : tests, compilation, analyse statique ou autre score objectif. Une complétion qui échoue n'est alors plus seulement jetée ; sa trajectoire peut guider la tentative suivante loin de la même branche défaillante.
Cela suggère une autre lecture du test-time scaling : la ressource importante n'est pas uniquement le nombre d'échantillons, mais la capacité des échantillons suivants à exploiter l'information produite par les échecs précédents.
Le chiffre de 3× ne doit pas encore être généralisé
FLEET est un preprint arXiv, pas une validation de production évaluée par les pairs. Les expériences restent étroites : un seul modèle 3B, deux familles de benchmarks et 222 tâches LiveCodeBench relativement faciles. Le dépôt indique également explicitement la nécessité d'accéder aux états cachés.
Le chiffre de 3× doit donc être lu comme un résultat d'efficacité d'échantillonnage dans la configuration testée, et non comme une promesse générale de diviser par trois la latence ou le coût d'infrastructure.
La prochaine étape probante serait une réplication sur plusieurs familles de modèles, des tâches de code plus difficiles, des mesures wall-clock sur de vraies piles de serving et des vérificateurs imparfaits. Si le gain se maintient, FLEET pourrait signaler un changement pratique dans le test-time scaling : remplacer davantage de tentatives indépendantes par une recherche qui se souvient des branches déjà perdues.