
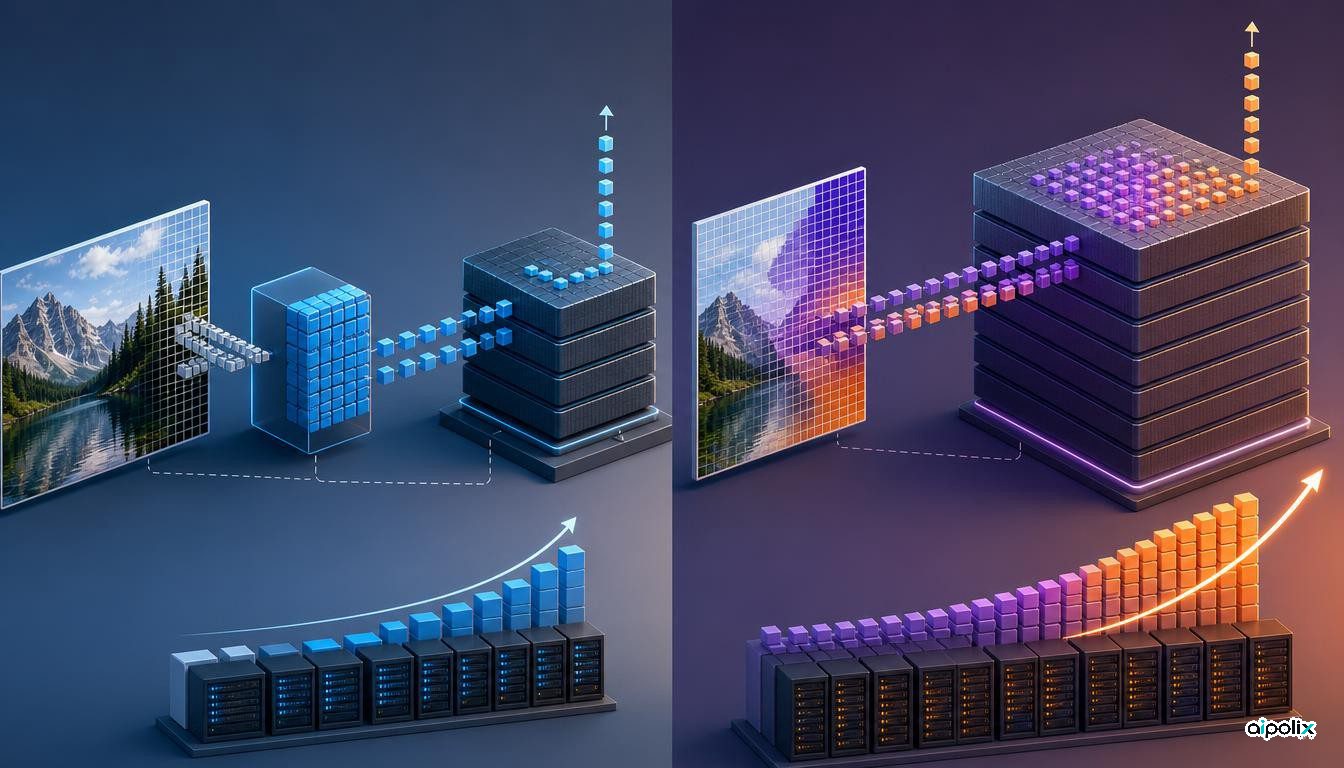
Investigadores da Tencent Hunyuan publicaram uma pré-publicação que analisa uma questão prática de arquitetura para IA multimodal: a partir de que escala poderá um modelo aprender visão diretamente dos píxeis sem depender de um codificador visual pré-treinado e separado? O estudo compara modelos de linguagem multimodais com codificador com sistemas sem codificador. Segundo os autores, a abordagem sem codificador é menos eficiente em termos de computação no objetivo multimodal às escalas efetivamente testadas, mas melhora mais depressa à medida que aumenta a computação de treino. Leis de escala ajustadas projetam uma possível aproximação por volta de 10^22 FLOPs.
Essa projeção é simultaneamente o resultado mais relevante e a principal limitação do trabalho. Os investigadores não observaram diretamente o ponto de cruzamento. A estimativa prolonga uma tendência ajustada para além do intervalo medido, pelo que deve ser tratada como uma hipótese sobre o comportamento em maior escala e não como um limiar demonstrado. O artigo é também uma pré-publicação e as conclusões dependem das famílias de modelos, dos dados, das opções de otimização e das avaliações usadas na experiência.
Uma nova forma de colocar a questão da arquitetura
Muitos modelos de linguagem multimodais recorrem a um codificador visual pré-treinado para transformar imagens em representações que o modelo de linguagem consegue processar. Esta organização fornece uma base visual já estruturada e pode tornar o treino mais eficiente, porque o modelo de linguagem não precisa de aprender toda a cadeia de representação visual diretamente a partir de píxeis.
Os sistemas sem codificador retiram esse componente especializado. O descodificador tem de aprender representações visuais úteis ao mesmo tempo que aprende linguagem e raciocínio multimodal. Nas experiências lideradas pela Tencent Hunyuan, as fronteiras de perda face à computação no objetivo textual são descritas como semelhantes entre as duas abordagens. No objetivo multimodal, os modelos sem codificador ficam atrás nas escalas menores testadas, embora as curvas ajustadas indiquem uma melhoria mais rápida.
A decisão de engenharia passa, assim, a ser diferente. A questão deixa de ser apenas saber se a aprendizagem multimodal sem codificador funciona e passa a incluir a escala e o orçamento de treino em que a simplicidade de uma arquitetura unificada poderá compensar o custo adicional.
O descodificador desenvolve comportamento visual especializado
Os autores analisam ainda como o descodificador sem codificador muda internamente. Relatam que as interações bidirecionais entre tokens visuais se tornam mais úteis à medida que cresce a computação, que o processamento visual se desloca para camadas mais iniciais e que o encaminhamento de especialistas para tokens visuais se torna mais concentrado.
Estas observações são compatíveis com a interpretação de que o descodificador desenvolve gradualmente computação especializada para visão. Para quem desenha sistemas multimodais e modelos de mistura de especialistas, a consequência é relevante: retirar o codificador visual não significa necessariamente eliminar a especialização visual. Essa especialização pode deslocar-se para o interior do modelo partilhado, alterando a distribuição de capacidade, encaminhamento e computação.
Por isso, uma arquitetura unificada não deve ser interpretada como ausência de processamento especializado. O possível benefício está numa arquitetura externa mais simples e em representações aprendidas de forma mais conjunta.
Porque 10^22 FLOPs não é um limiar comprovado
O cruzamento projetado perto de 10^22 FLOPs está fora do intervalo medido. Nas escalas realmente testadas, os modelos sem codificador continuam menos eficientes em computação no objetivo multimodal e apresentam resultados inferiores nas avaliações a jusante. Ajustes de leis de escala também podem mudar com a mistura de dados, a receita de treino, a família de modelos ou as tarefas de avaliação.
Para equipas que hoje precisam de decidir uma arquitetura ou um orçamento de treino, a evidência medida continua a favorecer codificadores visuais pré-treinados quando a eficiência computacional é prioritária. A projeção é mais útil para orientar experiências futuras do que para justificar uma migração imediata.
A interpretação da Aipolix é que este trabalho transforma o desenho multimodal sem codificador numa questão de alocação de computação. Se experiências maiores observarem o cruzamento previsto, descodificadores multimodais unificados poderão tornar-se mais atrativos em escalas de treino de fronteira. Se o ponto mudar muito com outras receitas, os codificadores especializados poderão manter a vantagem durante mais tempo.
O que importa observar a seguir
A confirmação mais forte seria um treino controlado de maior escala que ultrapassasse de facto o ponto previsto, mantendo dados, otimização e avaliações comparáveis. A repetição do resultado noutras famílias de modelos ajudaria também a perceber se o comportamento é geral ou específico desta configuração experimental.
Até existir essa evidência, o artigo oferece um sinal arquitetural útil, mas não uma regra estabelecida. Sugere que a dependência atual de codificadores visuais pode refletir parcialmente a economia da computação disponível, ao mesmo tempo que mostra que os sistemas sem codificador ainda não eliminaram a desvantagem de eficiência observada.
Fontes
https://arxiv.org/abs/2609.35457
https://huggingface.co/papers/2609.35457