
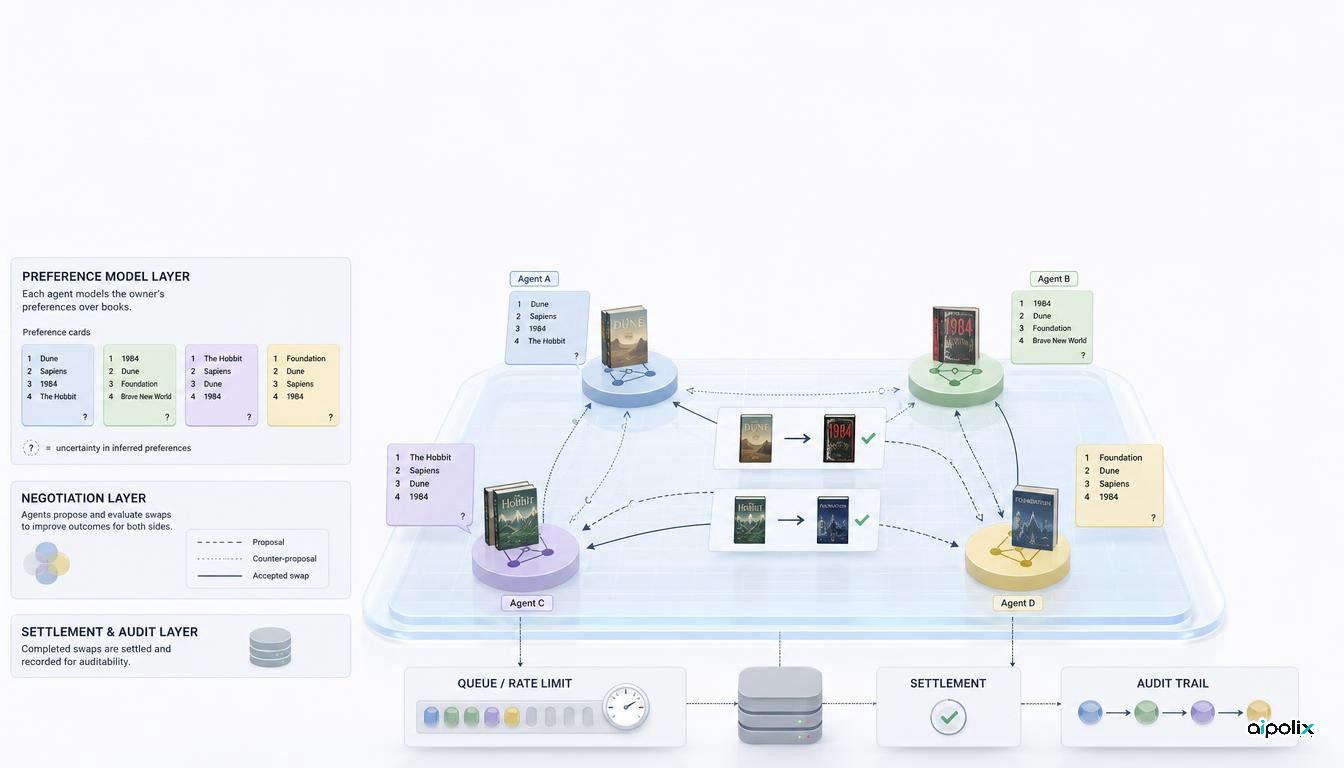
O Project Swap da Anthropic parte de uma pergunta mais básica do que saber se um agente consegue negociar: antes de representar bem uma pessoa, até que ponto o agente compreende aquilo que essa pessoa realmente quer?
A empresa criou um mercado controlado para troca de livros com 201 colaboradores distribuídos por seis escritórios. Cada participante levou um livro, teve uma breve conversa com Claude sobre os seus gostos de leitura e enviou depois um agente baseado em Claude para uma plataforma digital de negociação. Os agentes podiam propor trocas, aceitar ou rejeitar propostas e organizar rotações entre várias partes. Em paralelo, os participantes classificaram diretamente um subconjunto de livros, permitindo comparar essas preferências com o ranking inferido por Claude.
A experiência é relevante porque separa dois problemas que muitas vezes aparecem juntos sob a expressão «desempenho do agente»: compreender os objetivos da pessoa e agir eficazmente depois de esses objetivos terem sido representados.
A inferência de preferências funcionou, mas ficou longe de ser perfeita
A partir da curta conversa inicial, Claude construiu um ranking de livros para cada participante. Segundo a Anthropic, quando se comparou a ordem de pares de livros nas classificações das pessoas com a ordem inferida por Claude, houve concordância em 61% dos casos. Uma ordenação aleatória teria cerca de 50%.
É um resultado significativo para uma conversa curta, mas continua a existir uma margem grande de erro. Num mercado, um negociador muito competente pode otimizar o objetivo errado se o modelo das preferências estiver incorreto. Uma troca pode parecer eficiente segundo o ranking do agente e, ainda assim, não corresponder ao que o utilizador gostaria de ter escolhido.
A conclusão mais importante da Anthropic é que a principal limitação do mercado veio mais da informação incompleta sobre as preferências das pessoas do que de falhas de negociação dos agentes. Para a engenharia de sistemas agentivos, esta distinção é essencial.
Modelos mais fortes ajudaram o mercado, mas as instruções não explicam tudo
A Anthropic repetiu os mercados várias vezes, alterando os modelos e as instruções dadas aos agentes. A empresa relata que a escolha do modelo teve mais impacto nos resultados de negociação do que as variantes de instruções testadas e que os mercados com modelos mais fortes foram mais eficientes.
Isto não significa que os prompts sejam irrelevantes, nem que a experiência estabeleça um ranking geral de modelos para comércio. O resultado aponta antes para duas camadas independentes de qualidade: a capacidade de construir uma boa representação das preferências e a capacidade de negociar dentro de um determinado mecanismo de mercado.
Os agentes também recorreram a táticas de negociação reconhecíveis. Revelaram informação de forma seletiva, usaram pressão temporal, promoveram o valor dos livros, mantiveram listas de espera e, em alguns casos, funcionaram como intermediários informais. A Anthropic analisou estas estratégias ao longo de 205 execuções do mercado, o que dá ao estudo mais substância do que uma demonstração isolada.
A lição de arquitetura é separar preferências de política de negociação
A principal leitura da Aipolix é que a recolha e representação de preferências deve ser tratada como um subsistema de primeira classe num mercado agentivo de produção.
Uma arquitetura prática separaria o modelo de preferências do utilizador da política de negociação do agente. A primeira camada deveria registar o que foi dito diretamente pelo utilizador, o que foi inferido, qual o nível de confiança e que pressupostos continuam por resolver. A camada de negociação poderia então atuar sobre essa representação, mantendo também um registo das razões para aceitar ou rejeitar cada proposta.
Esta separação cria um mecanismo de segurança importante. Se uma decisão depender de uma preferência incerta ou de uma suposição fraca, o sistema pode pedir confirmação ao utilizador em vez de transformar silenciosamente essa incerteza numa ação. Também facilita a avaliação: uma equipa consegue perceber se um mau resultado veio de uma interpretação errada do utilizador, de uma negociação fraca, de regras de mercado inadequadas ou de um problema na execução da troca.
Sem essa separação, uma única métrica de «sucesso do agente» pode esconder a verdadeira origem da falha.
Observabilidade e liquidação são tão importantes como a negociação
O Project Swap revelou igualmente problemas operacionais pouco relacionados com a capacidade de raciocínio do modelo. Alguns participantes não levaram os livros que tinham prometido e a Anthropic não tinha um sistema perfeito para distinguir uma falha de entrega de um livro que tivesse desaparecido da zona de troca.
Num teste de baixo risco isto é sobretudo um problema logístico. Num mercado real, o mesmo cenário exige identidade, autorização, registos de compromisso, liquidação, tratamento de litígios e definição de responsabilidade. Negociar é apenas uma das fases da transação.
O histórico completo da negociação também ficou disponível para revisão, e um participante valorizou explicitamente a possibilidade de rever o que o seu agente tinha feito. Em sistemas de maior risco, esse replay deve ser parte do produto e não apenas uma ferramenta de depuração.
A Anthropic limitou ainda quantos agentes podiam agir ao mesmo tempo e com que frequência. Agentes que não se cansam podem criar congestionamento contínuo. Limites de frequência, regras de fila e políticas de visibilidade passam, por isso, a ser parâmetros do próprio desenho do mercado.
Houve abertura à delegação, mas num contexto deliberadamente simples
Entre os participantes que responderam ao inquérito final, a satisfação média com o livro recebido foi de 7,2 em 10. No cenário descrito pela Anthropic, as pessoas disseram que, em média, entregariam a um agente cerca de 30% do seu orçamento anual para livros. Para um amigo muito leitor e conhecedor dos seus gostos, a média foi de cerca de 40%.
Os números são interessantes, mas não devem ser extrapolados. Os participantes eram colaboradores da Anthropic, os bens eram livros, os agentes pertenciam à família Claude e as regras de mercado foram cuidadosamente controladas. O risco era reduzido e muitas das dificuldades de um mercado comercial aberto não estavam presentes.
Por isso, o Project Swap não demonstra que agentes autónomos estejam prontos para negociar crédito à habitação, cuidados de saúde ou títulos financeiros. Mostra, sim, que mesmo num mercado amigável e controlado, representar corretamente os interesses do utilizador e negociar bem são problemas de engenharia diferentes.
O próximo benchmark deve medir separadamente o erro de representação
Muitos benchmarks de agentes medem conclusão da tarefa, recompensa ou resultado final. O Project Swap aponta para outra métrica importante: que parte do erro final resulta de uma representação incorreta das preferências do utilizador?
Para agentes de compras, planeamento, procurement ou plataformas onde agentes transacionam entre si, esta decomposição pode ser mais útil do que uma taxa de sucesso única. Um agente pode negociar de forma impecável e ainda assim falhar para o utilizador se estiver a defender o objetivo errado.
A conclusão prática é simples: antes de dar mais autonomia de negociação a um agente, é necessário dar ao utilizador uma forma clara de ver, corrigir e limitar as preferências que o agente está autorizado a usar.