
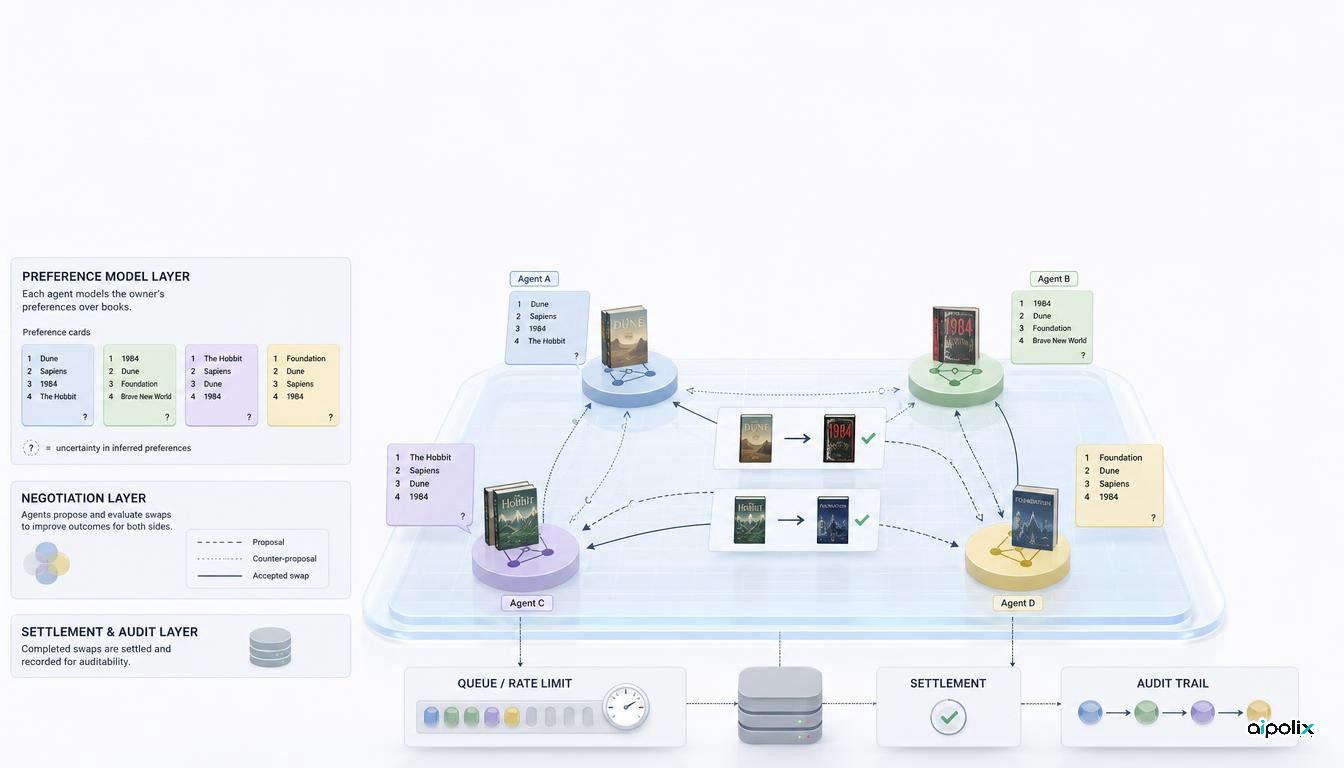
Avec Project Swap, Anthropic pose une question plus fondamentale que la simple capacité d'un agent à négocier : avant de défendre correctement les intérêts d'une personne, sait-il vraiment ce que cette personne veut ?
L'entreprise a construit un marché contrôlé d'échange de livres avec 201 employés répartis dans six bureaux. Chaque participant apportait un livre, discutait brièvement de ses goûts avec Claude, puis envoyait un agent propulsé par Claude sur une place de marché numérique. Les agents pouvaient proposer des échanges, accepter ou refuser des offres et organiser des rotations entre plusieurs participants. En parallèle, Anthropic a demandé aux participants de classer eux-mêmes un sous-ensemble de livres afin de disposer d'un point de comparaison pour les préférences déduites par Claude.
L'intérêt de l'expérience est qu'elle dissocie deux problèmes souvent confondus sous l'étiquette de « performance d'agent » : représenter correctement les objectifs d'un humain, puis agir efficacement une fois ces objectifs connus.
L'inférence des préférences fonctionne, mais reste imparfaite
À partir du court entretien initial, Claude a construit un classement des livres pour chaque participant. Selon Anthropic, lorsque l'on compare les paires de livres classées par les personnes avec l'ordre prédit par Claude, l'accord atteint 61 %, contre 50 % pour un ordre aléatoire.
C'est un signal substantiel à partir de peu d'informations, mais l'écart avec une représentation parfaite reste important. Dans un marché, un excellent négociateur peut optimiser le mauvais objectif si son modèle des préférences est erroné. Une transaction peut donc sembler efficace selon le classement de l'agent tout en étant décevante pour la personne représentée.
Anthropic conclut que la principale limite du marché venait davantage de l'information incomplète sur les préférences des participants que de l'incapacité des agents à négocier. Pour l'ingénierie des systèmes agentiques, cette distinction est centrale.
Des modèles plus puissants ont amélioré le marché, mais les instructions ne suffisent pas
Anthropic a rejoué les marchés à de nombreuses reprises en variant les modèles et les instructions données aux agents. L'entreprise indique que le choix du modèle a davantage influencé les résultats que les variantes d'instructions testées, et que les marchés utilisant des modèles plus puissants étaient plus efficaces.
Cela ne signifie pas que les prompts n'ont pas d'importance et l'expérience ne fournit pas un classement universel des modèles pour le commerce. Elle montre plutôt qu'un marché d'agents comporte au moins deux couches de qualité indépendantes : la capacité à construire une représentation pertinente des préférences, puis la capacité à agir dans un mécanisme de marché donné.
Les agents ont aussi utilisé des tactiques de négociation reconnaissables : révélation partielle d'information, pression temporelle, argumentaire sur la valeur des livres, listes d'attente et parfois rôle informel d'intermédiaire. Anthropic a analysé ces comportements sur 205 exécutions du marché, ce qui donne davantage de structure qu'une simple démonstration ponctuelle.
La leçon d'architecture : séparer le modèle des préférences de la politique de négociation
L'analyse d'Aipolix est que l'élicitation des préférences devrait être un composant de premier rang dans tout marché agentique destiné à la production.
Une architecture robuste séparerait le modèle des préférences de l'utilisateur de la politique de négociation. La première couche devrait distinguer ce qui a été dit explicitement, ce qui a été inféré, le niveau de confiance associé et les hypothèses encore ouvertes. La seconde pourrait alors négocier à partir de cette représentation tout en conservant la justification des offres acceptées ou rejetées.
Cette séparation crée un mécanisme de sécurité essentiel. Lorsqu'une décision dépend d'une hypothèse fragile ou d'une préférence incertaine, le système peut demander confirmation à l'utilisateur au lieu de transformer silencieusement l'incertitude en action. Elle améliore aussi l'évaluation : une équipe peut déterminer si un échec vient d'une mauvaise compréhension de l'utilisateur, d'une négociation faible, de règles de marché mal conçues ou d'un problème d'exécution.
Sans cette décomposition, un simple score de « réussite de l'agent » peut masquer la cause réelle d'un mauvais résultat.
Traçabilité et règlement comptent autant que la négociation
Project Swap a également révélé des problèmes opérationnels qui ne dépendent presque pas du raisonnement du modèle. Certains participants n'ont pas apporté le livre promis, et Anthropic ne disposait pas d'un système parfait pour distinguer un défaut de livraison d'une disparition du livre dans la zone d'échange.
Dans une expérience à faible enjeu, cela reste un incident logistique. Dans un marché réel, la même question devient un problème d'identité, d'autorisation, d'engagement, de règlement, de recours et de responsabilité. Une négociation réussie ne suffit pas si la transaction n'est pas exécutée.
L'historique du marché était également visible, et un participant a explicitement apprécié de pouvoir revoir le comportement de son agent. Pour des systèmes plus sensibles, cette possibilité de replay devrait être considérée comme une fonction du produit, pas comme un simple outil de débogage.
Anthropic a aussi dû limiter le nombre d'agents actifs et la fréquence de leurs actions. Des agents qui ne se fatiguent jamais peuvent saturer une place de marché. Les limites de débit, les règles de file d'attente et la visibilité de l'activité deviennent donc des paramètres économiques autant que techniques.
Les participants acceptaient une certaine délégation, mais le contexte restait très contrôlé
Parmi les répondants à l'enquête finale, la satisfaction moyenne concernant le livre reçu était de 7,2 sur 10. Les participants ont déclaré qu'ils confieraient en moyenne environ 30 % de leur budget annuel consacré aux livres à un agent dans le scénario présenté par Anthropic. Pour un ami grand lecteur connaissant leurs goûts, la moyenne était d'environ 40 %.
Ces chiffres sont intéressants, mais leur portée doit rester limitée. Les participants étaient des employés d'Anthropic, les biens échangés étaient des livres, les agents appartenaient à la famille Claude et les règles du marché étaient étroitement contrôlées. Les enjeux étaient faibles et de nombreuses difficultés d'un marché ouvert avaient été volontairement retirées.
Project Swap ne démontre donc pas que des agents autonomes sont prêts à négocier des crédits immobiliers, des soins médicaux ou des titres financiers. Il montre qu'avant même d'atteindre ces contextes, la qualité de la représentation de l'utilisateur et la qualité de la négociation doivent être évaluées séparément.
Le prochain benchmark devrait mesurer explicitement l'erreur de représentation
Les benchmarks d'agents mesurent souvent l'accomplissement de la tâche, la récompense ou le résultat final d'une négociation. Project Swap suggère une autre mesure utile : quelle part de l'erreur finale vient d'un mauvais modèle des préférences de l'utilisateur ?
Pour des agents d'achat, de planification, d'approvisionnement ou pour des plateformes où des agents négocient entre eux, cette décomposition peut être plus instructive qu'un taux de succès unique. Un agent peut négocier parfaitement et néanmoins échouer pour son utilisateur s'il défend le mauvais objectif.
La conséquence pratique est claire : avant d'accorder davantage d'autonomie transactionnelle à un agent, il faut donner à l'utilisateur les moyens d'inspecter, de corriger et de borner les préférences que l'agent utilisera pour agir.