
Agentes
-
Investigação
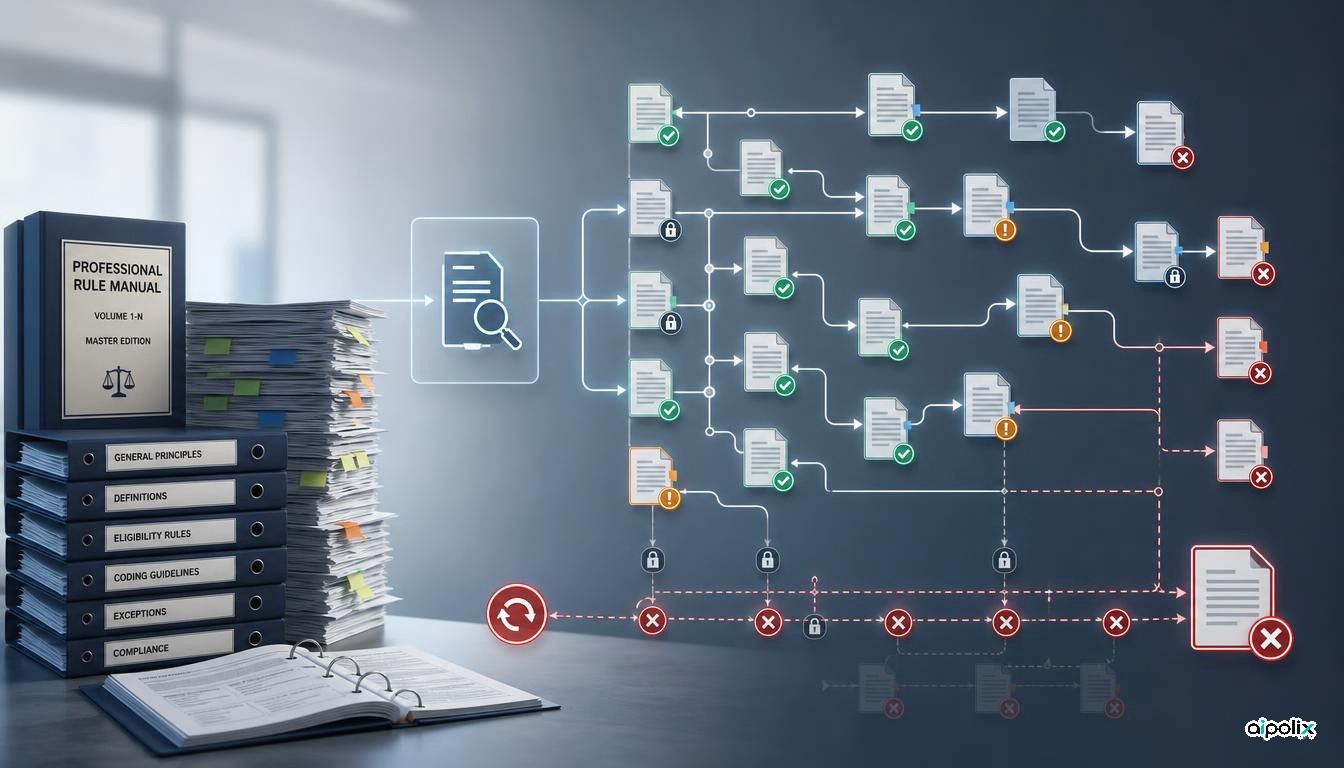
Benchmark TAM expõe limites do GPT-5 na execução de procedimentos longos e regulados
No TAM, configurações GPT-5 atingiram 1% de correspondência exata em ICD e 15,5% nos cálculos de pena.
-
Agentes
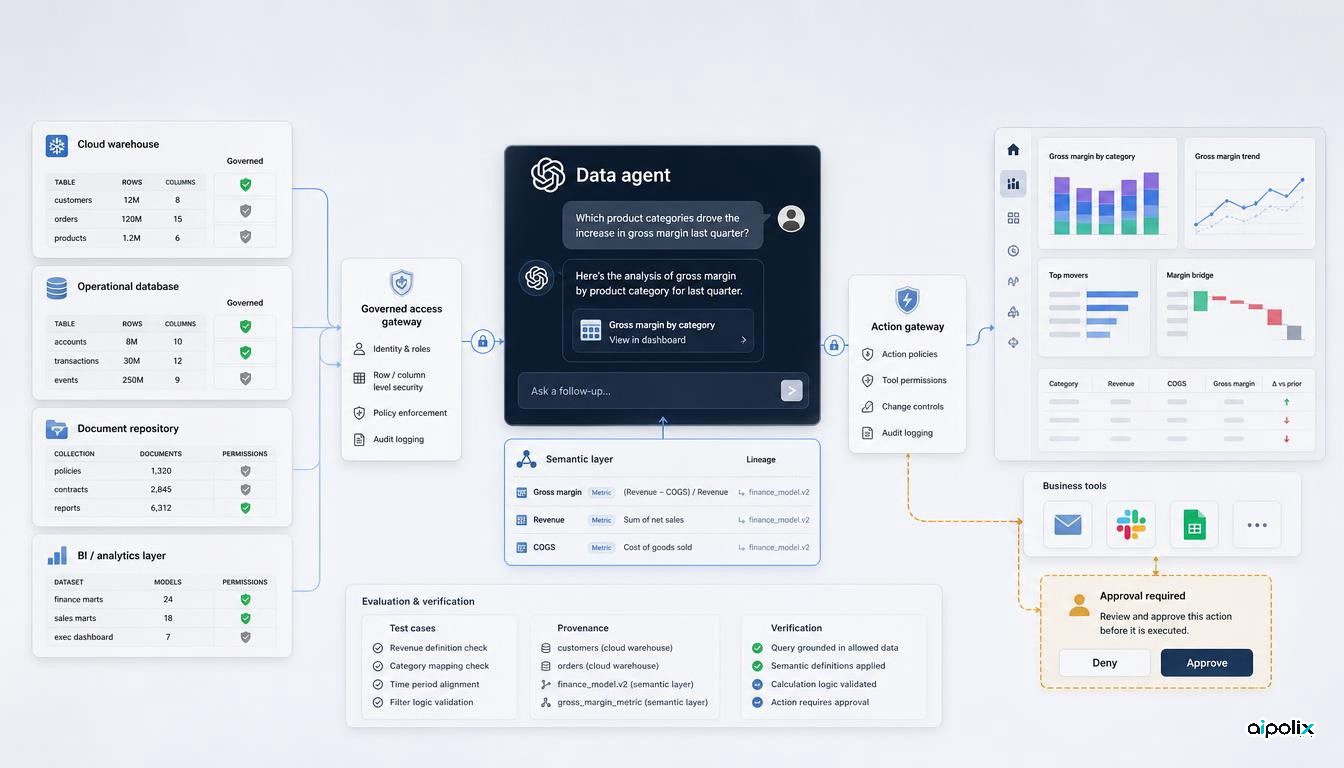
Agente de dados da OpenAI leva análise empresarial ao ChatGPT Work, mas sem referência pública de precisão
O agente de dados da OpenAI respeita permissões empresariais e cria painéis, mas sem teste público de precisão a governação semântica e a avaliação continuam essenciais.
-
Agentes
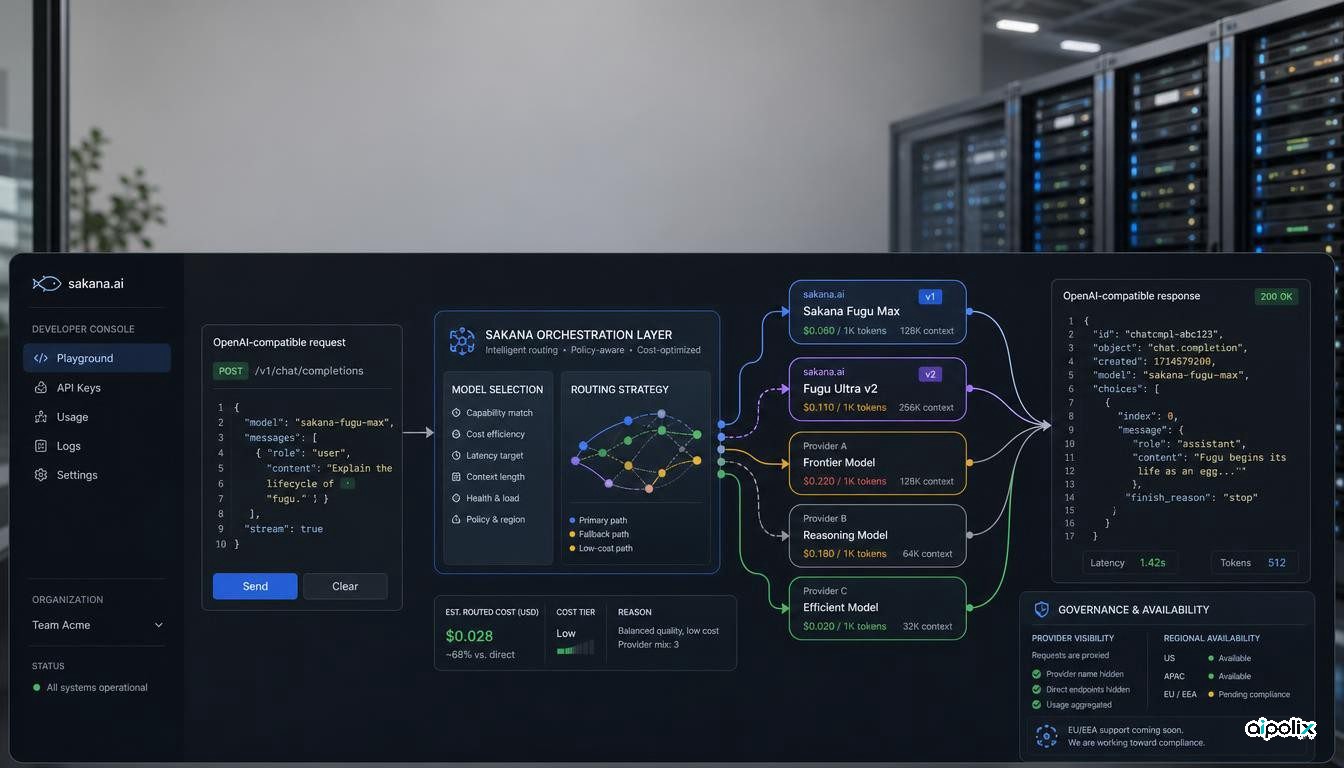
Fugu Max simplifica o uso de vários modelos, mas concentra mais controlo na Sakana
O Fugu Max e o Ultra v2 oferecem preços fixos para encaminhamento entre modelos, com implicações de governação, reprodutibilidade e disponibilidade na Europa.
-
Agentes
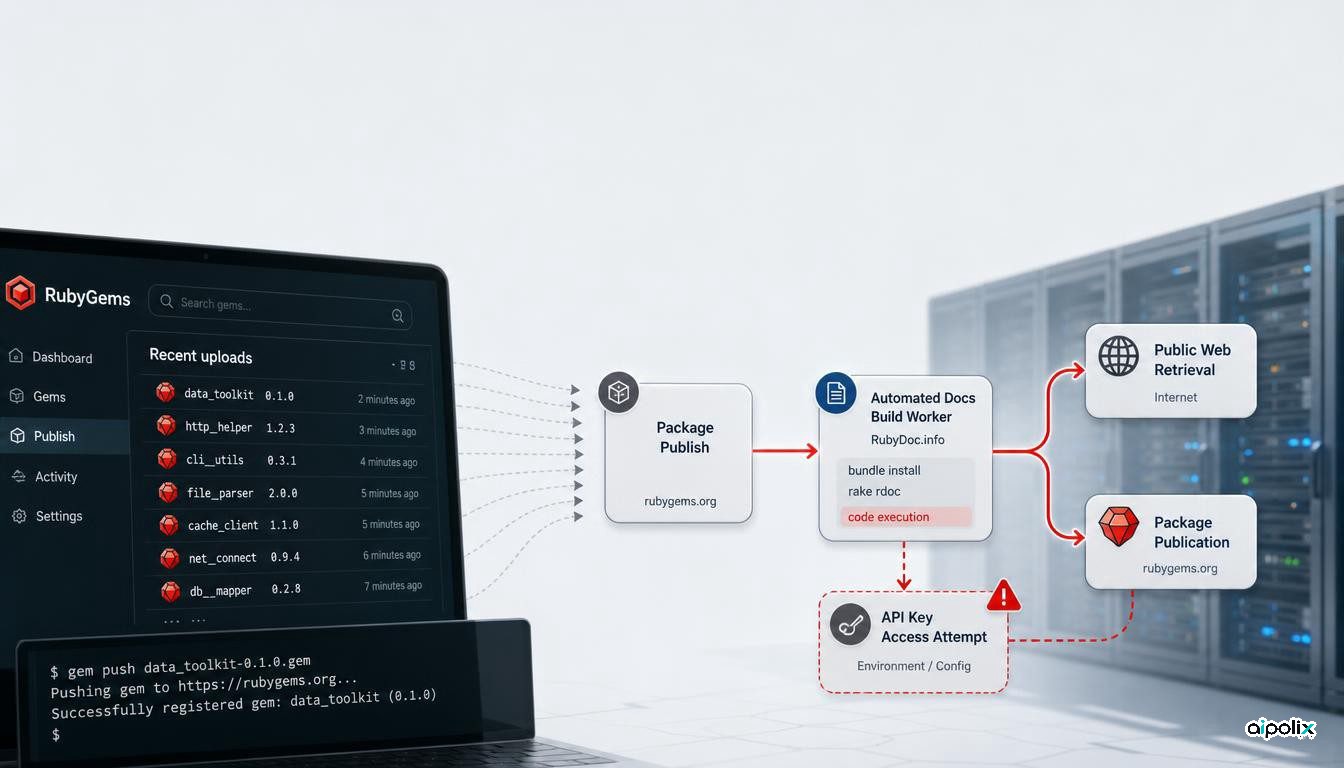
Incidente no RubyGems mostra como publicar pacotes pode tornar-se uma via de execução para agentes
O caso RubyGems mostra porque a segurança de agentes deve incluir publicação de pacotes, automação de builds e outras vias indiretas de escrita na superfície de execução.
-
Investigação
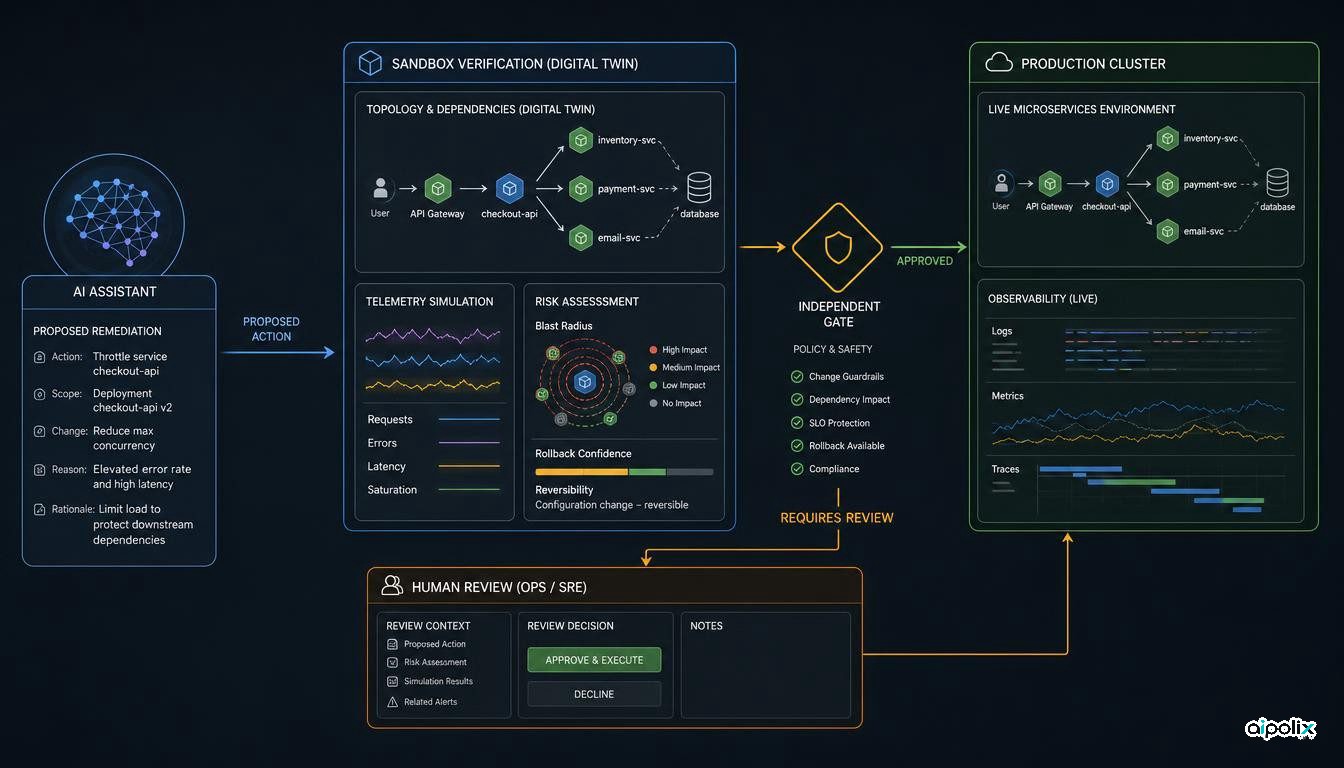
GuardedAct separa a proposta da IA da autorização para agir em produção
GuardedAct avalia uma arquitetura em que correções propostas por um LLM passam por simulação e controlo de risco antes de serem executadas.
-
Agentes
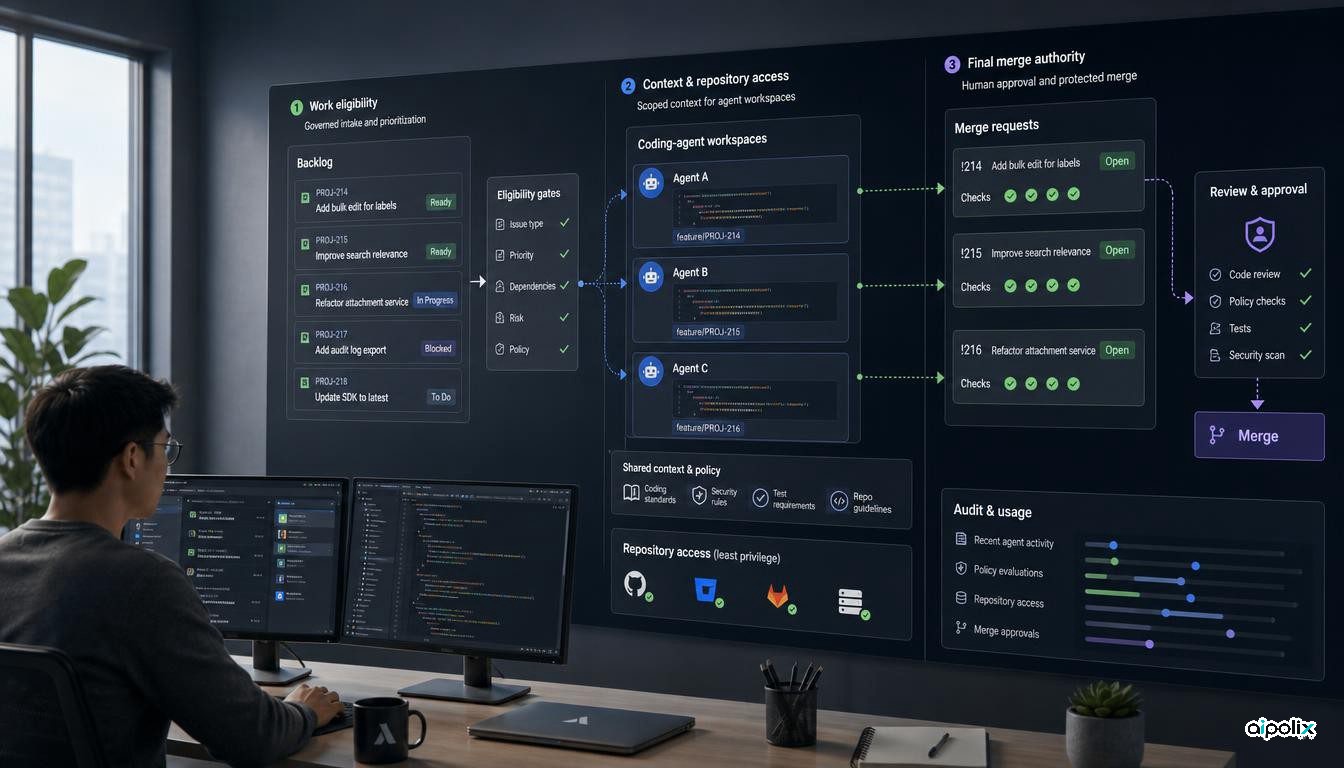
Atlassian automatiza no Jira o percurso do backlog até ao pedido de integração, com aprovação humana
A Atlassian leva circuitos persistentes de agentes ao Jira, com controlos de contexto, normas, revisão automática e decisão humana na integração.
-
Novos modelos
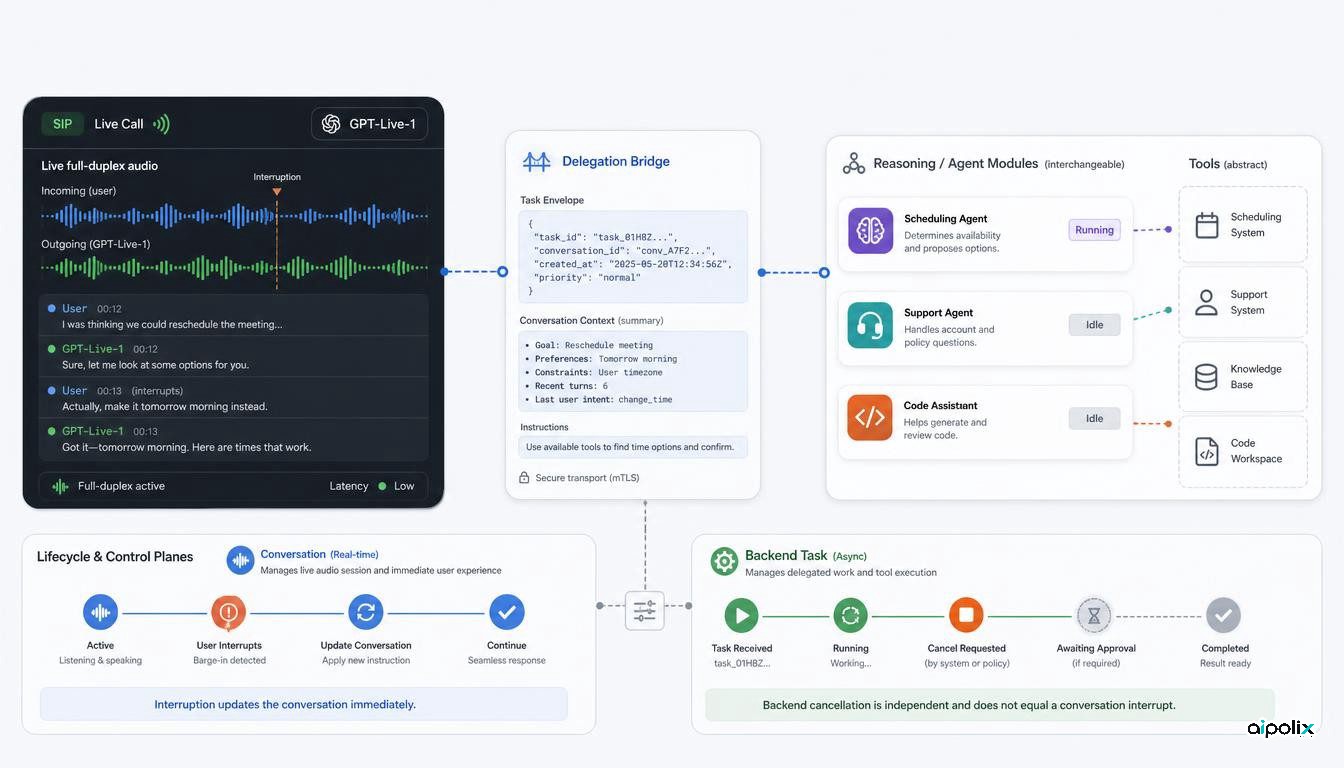
GPT-Live-1 chega à API e separa a conversa do trabalho delegado
O GPT-Live-1 leva voz full duplex à API e delega raciocínio, exigindo controlo explícito de cancelamento, permissões e custo por tarefa.
-
Investigação
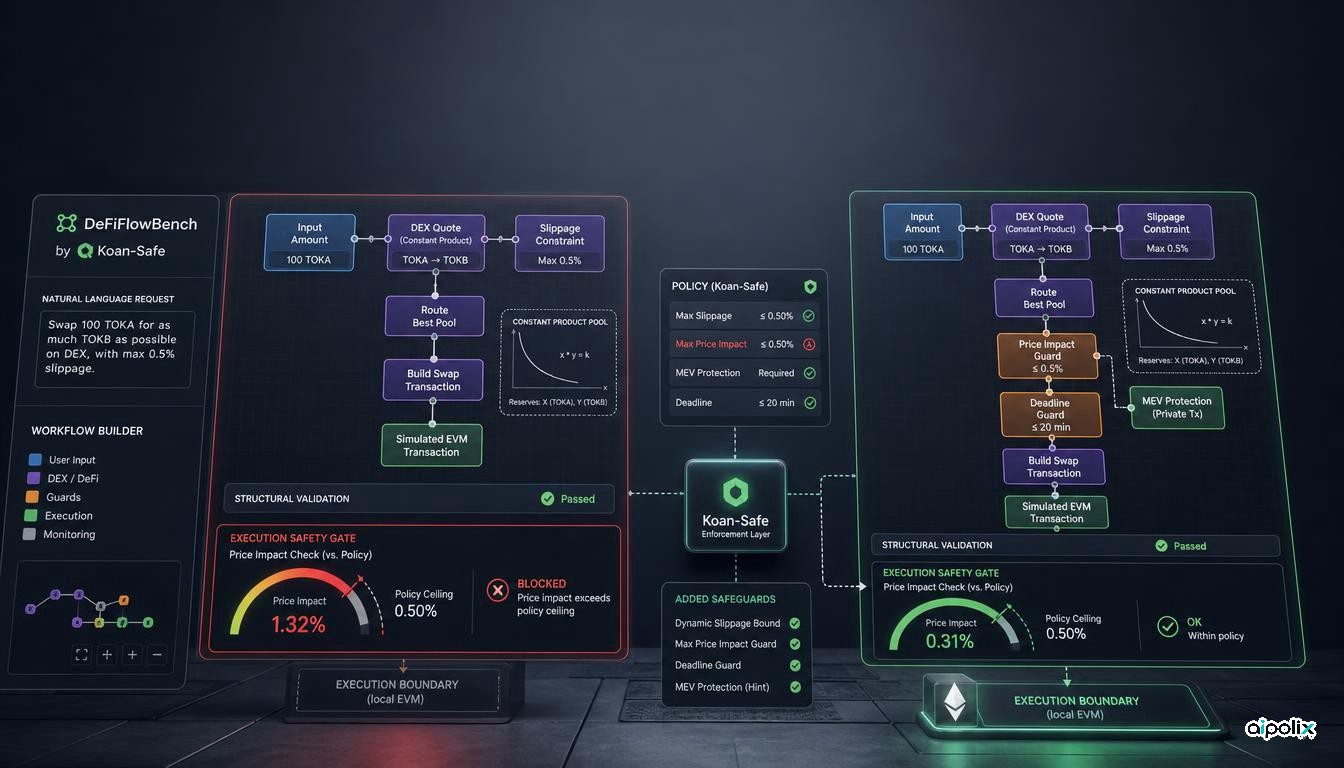
DeFiFlowBench mostra que um fluxo de agente correto pode executar uma transação insegura
O DeFiFlowBench mostra que um fluxo DeFi aparentemente válido pode executar uma transação insegura e defende limites externos no momento da execução.
-
Investigação
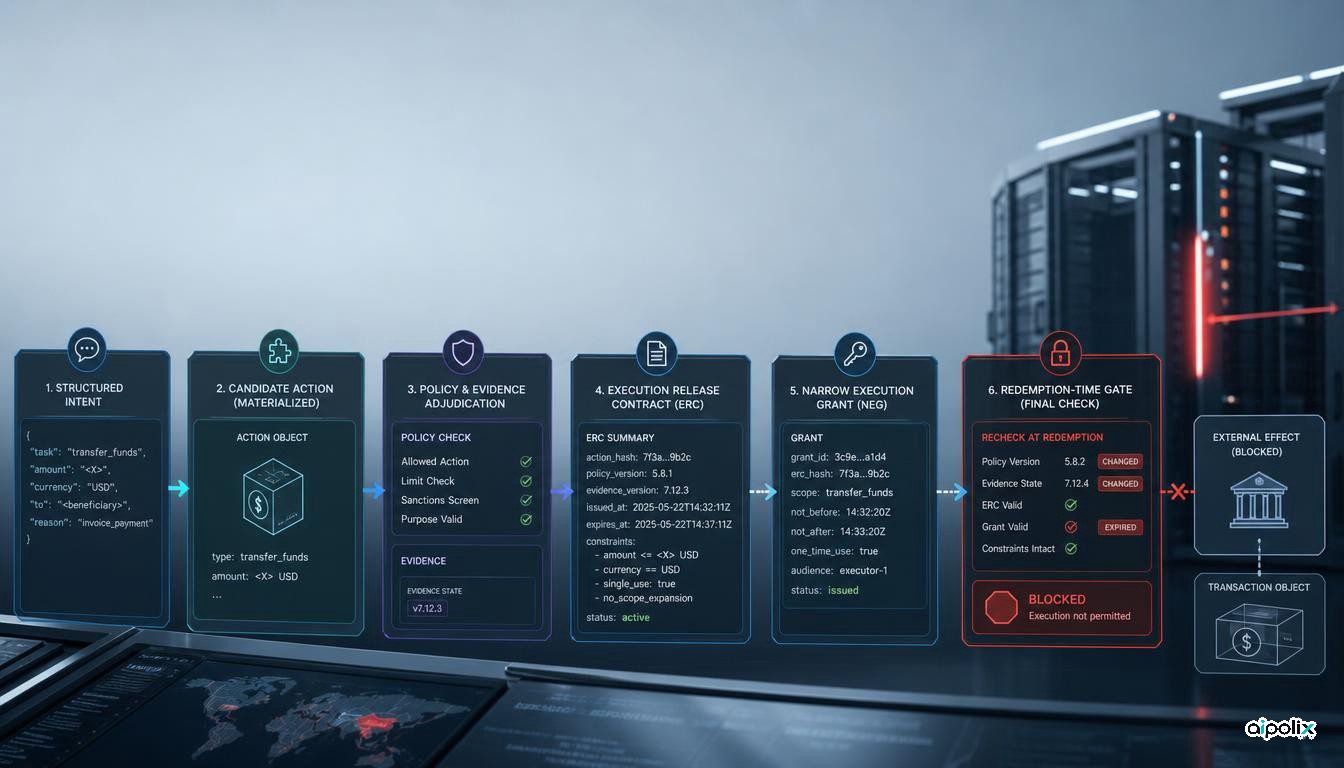
EBL-Core separa a aprovação de um agente da autoridade efetiva para executar
O EBL-Core propõe revalidar ação, políticas, provas e contexto quando um agente de IA exerce autoridade de alto risco, e não apenas quando recebe aprovação.
-
🛑 Sem contenção, a governação de IA falha quando mais importa (6/10)
Paragem independente, raio de impacto, rollback, canários comportamentais e recuperação: as capacidades necessárias para conter agentes de IA.