
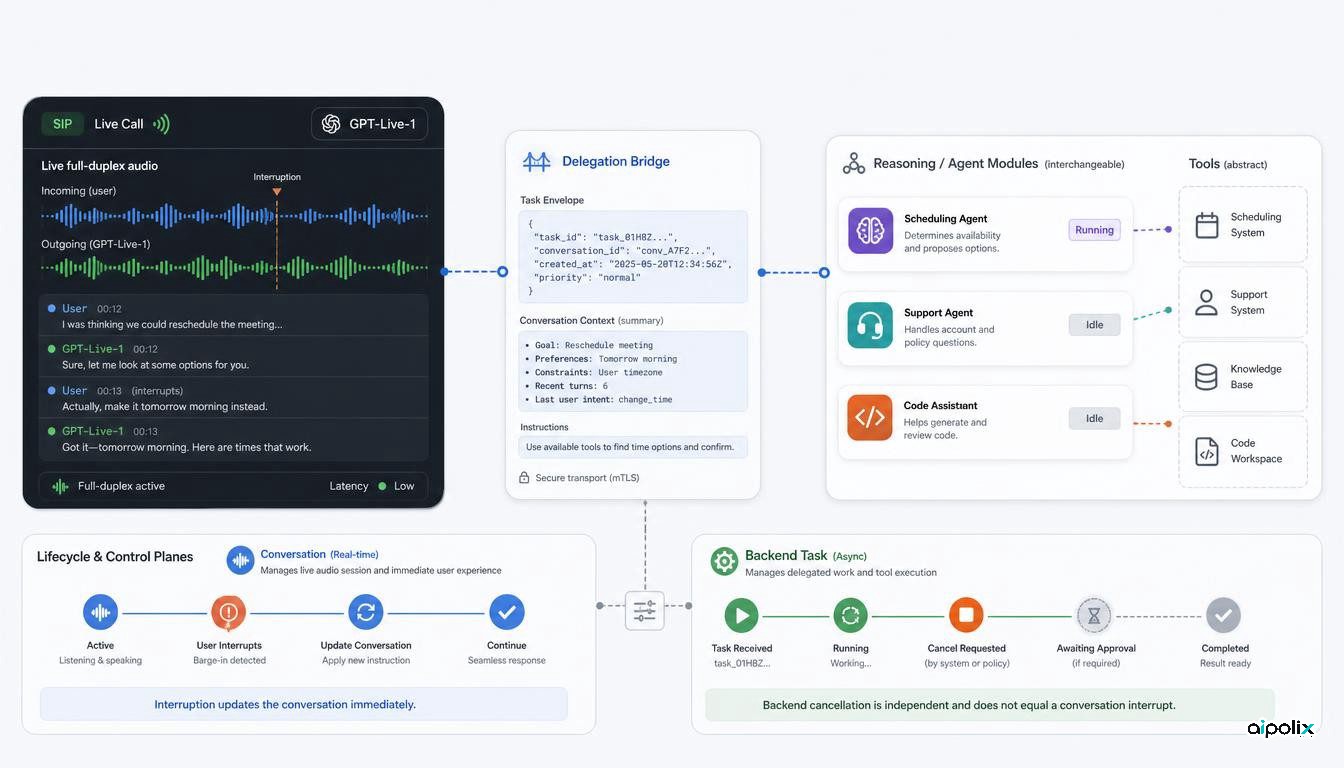
A OpenAI disponibilizou o GPT-Live-1 na API, levando para aplicações de terceiros o modelo de voz full duplex que já tinha chegado ao ChatGPT. A novidade mais relevante não é apenas a fluidez da conversa: o modelo pode tratar a interação em tempo real e entregar o raciocínio mais exigente ou a utilização de ferramentas a outro modelo ou agente.
A camada de voz custa 0,05 dólares por minuto, enquanto o modelo de retaguarda e as ferramentas são faturados separadamente. Para equipas de engenharia, passa a ser necessário coordenar de forma explícita o estado, as permissões e o ciclo de vida entre estas duas partes.
O ritmo da conversa passa a ser tratado pelo próprio modelo
As arquiteturas de voz tradicionais costumam ligar reconhecimento de fala, modelo de linguagem e síntese de voz em etapas separadas. A OpenAI afirma que o GPT-Live-1 processa em conjunto o áudio de entrada e de saída, o que lhe permite reagir diretamente a interrupções, hesitações, confirmações breves e ruído ambiente.
A versão da API inclui suporte para telefonia. A referência técnica da OpenAI mostra que uma sessão SIP recebida pode ser aceite com gpt-live-1. O serviço também fornece transcrição, texto das respostas, deteção de turnos, indicação de palavras-chave e controlo do tom, ritmo e estilo.
A OpenAI anuncia uma melhoria de 30 pontos percentuais face ao GPT-Realtime-2.1 no Full Duplex Bench e diz que o GPT-Live-1, associado ao GPT-6 Astra, ocupa o primeiro lugar no Tau3. São resultados divulgados pelo fornecedor e devem ser confirmados em cargas de trabalho próprias.
Conversar e executar trabalho podem seguir caminhos diferentes
O GPT-Live-1 não precisa de realizar sozinho todo o raciocínio nem todas as chamadas a ferramentas. Segundo a OpenAI, pode delegar essas tarefas no GPT-6 Astra, noutro modelo da empresa ou num modelo de terceiros. O exemplo oficial mostra contexto da conversa a ser enviado ao Codex e a resposta a regressar depois à sessão em direto.
Esta arquitetura permite manter uma camada de voz rápida e escolher o motor de raciocínio em função da tarefa. A contrapartida é a existência de dois ciclos de execução. O utilizador pode interromper ou mudar de intenção enquanto o trabalho delegado continua. A sessão de voz tem o seu próprio estado, enquanto o sistema em segundo plano mantém separadamente o estado da tarefa, permissões e chamadas a ferramentas.
Interromper a fala não equivale a cancelar a ação
A análise da Aipolix é que esta separação torna o cancelamento uma função que tem de ser desenhada de forma explícita. Num chatbot tradicional, parar a geração pode parecer próximo de parar todo o trabalho. Num agente de voz com delegação, silenciar a resposta e cancelar uma ação em segundo plano são operações diferentes.
Imagine um agente que começa uma reserva, altera uma definição de conta ou entrega uma modificação de código a outro agente. Se o utilizador interromper para dizer que afinal não quer prosseguir, a camada de voz pode parar imediatamente. A aplicação continua a ter de decidir se a tarefa delegada deve ser cancelada, concluída ou suspensa à espera de confirmação.
Cada delegação deve ter identidade, âmbito e estado próprios, para poder ser reconciliada com a intenção mais recente do utilizador. Os registos devem permitir ligar o pedido falado, a delegação criada, o modelo ou agente que a recebeu, as ferramentas utilizadas e o efeito externo final.
Isto é especialmente relevante em tarefas longas ou com efeitos fora da conversa. O full duplex melhora a experiência porque a conversa e o trabalho podem decorrer ao mesmo tempo. Esse paralelismo também aumenta a possibilidade de a intenção atual do utilizador divergir do que o sistema continua a executar.
O custo real também tem duas componentes
Os 0,05 dólares por minuto dizem respeito apenas à camada frontal de voz. O custo por tarefa depende também da duração da conversa, dos tokens consumidos pelo modelo delegado, das ferramentas usadas e de eventuais novas tentativas.
Esta flexibilidade permite escolher modelos diferentes conforme a dificuldade, mas torna o preço por minuto uma medida incompleta. Uma avaliação de produção deve medir o custo até à conclusão da tarefa: minutos de áudio, consumo do modelo de retaguarda, chamadas a ferramentas e frequência com que a conversa precisa de raciocínio mais caro.
A segurança acompanha a mesma divisão
A ficha de segurança do GPT-Live diz que o modelo de voz dispõe de proteções ao nível do sistema e que o trabalho delegado recebe as proteções do modelo que o executa. A OpenAI também refere que o GPT-Live, sem delegação, não tem por si só acesso amplo a ferramentas nem capacidade de executar código.
O risco depende, portanto, de toda a composição: modelo de voz, modelo de retaguarda, ferramentas disponíveis e política de autorização da aplicação.
Num agente de voz em produção, os controlos devem abranger as duas camadas. A sessão Live precisa das suas regras de conversa; as ferramentas e ações do sistema de retaguarda precisam de autorização própria; e a aplicação deve preservar a ligação entre cada delegação e a instrução do utilizador que lhe deu origem.
A chegada do GPT-Live-1 à API é uma mudança de arquitetura, além de uma atualização da experiência de voz. A proposta coloca uma conversa contínua à frente e permite escolher diferentes motores de raciocínio e ferramentas atrás dela. Para aproveitar essa flexibilidade sem perder controlo, delegação, cancelamento, permissões, observabilidade e custo têm de fazer parte do desenho desde o início.