Investigação
-
Investigação
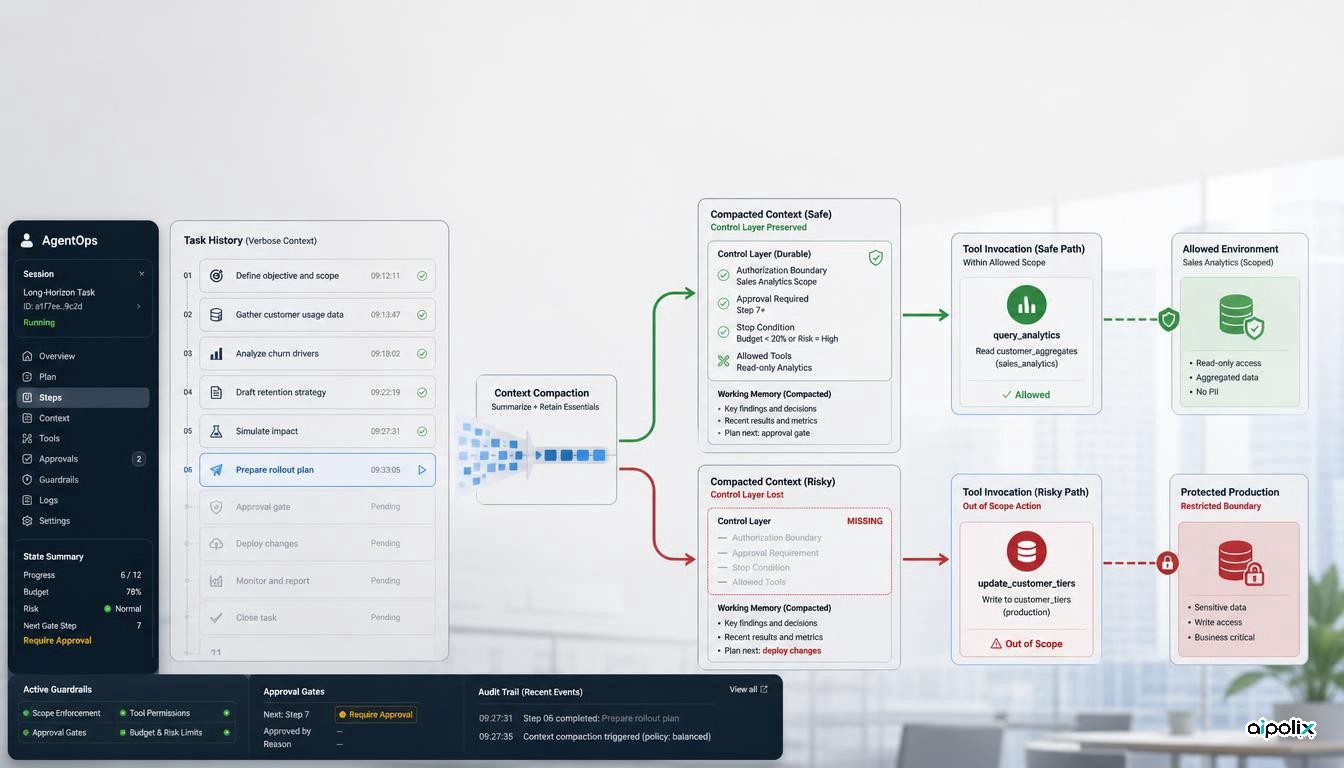
Agentes ultrapassam limites quando as regras de autorização desaparecem do contexto
Um estudo da Tencent Zhuque associa falhas de controlo à perda de regras de autorização durante a gestão do contexto, não à compactação por si só.
-
Investigação
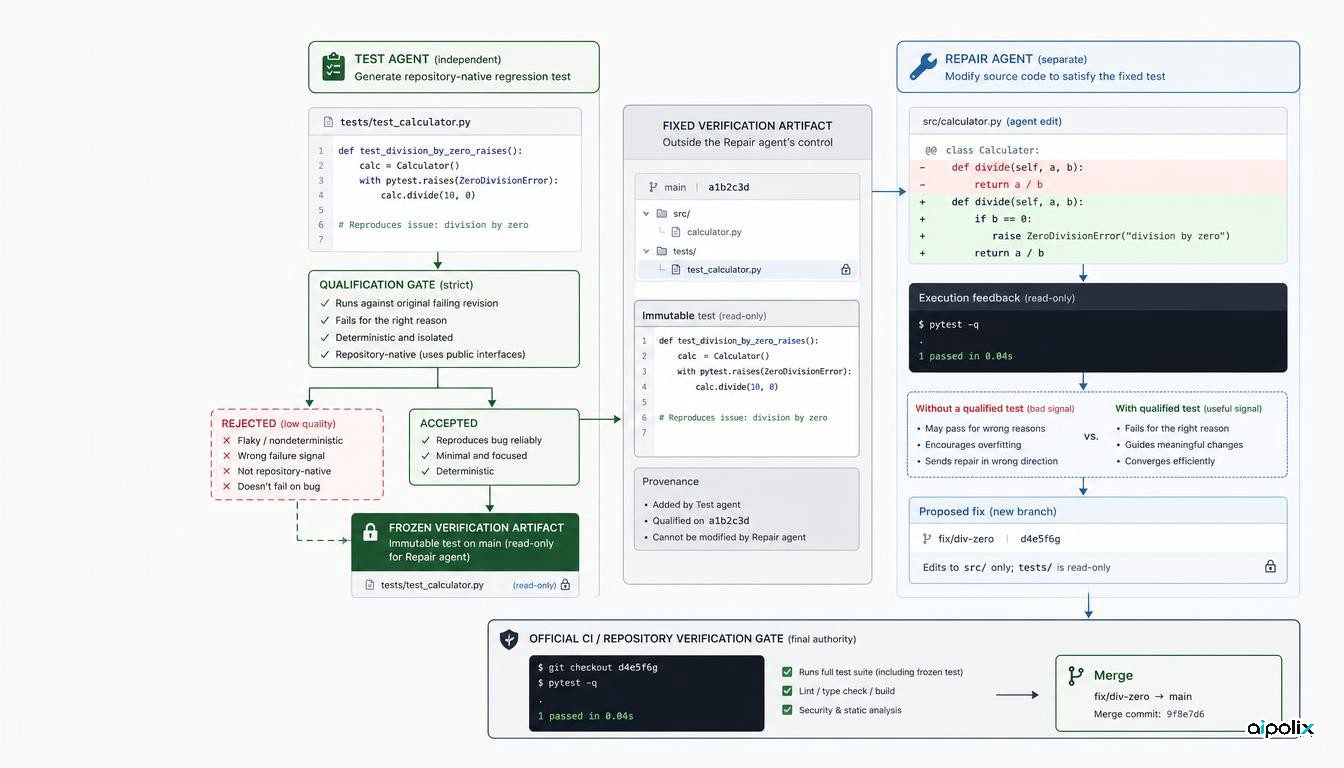
ExecCritic mostra que um teste mal gerado pode piorar um agente de programação
O ExecCritic conclui que testes gerados podem ajudar ou prejudicar a reparação e propõe qualificá-los e fixá-los antes de orientar o agente.
-
Investigação
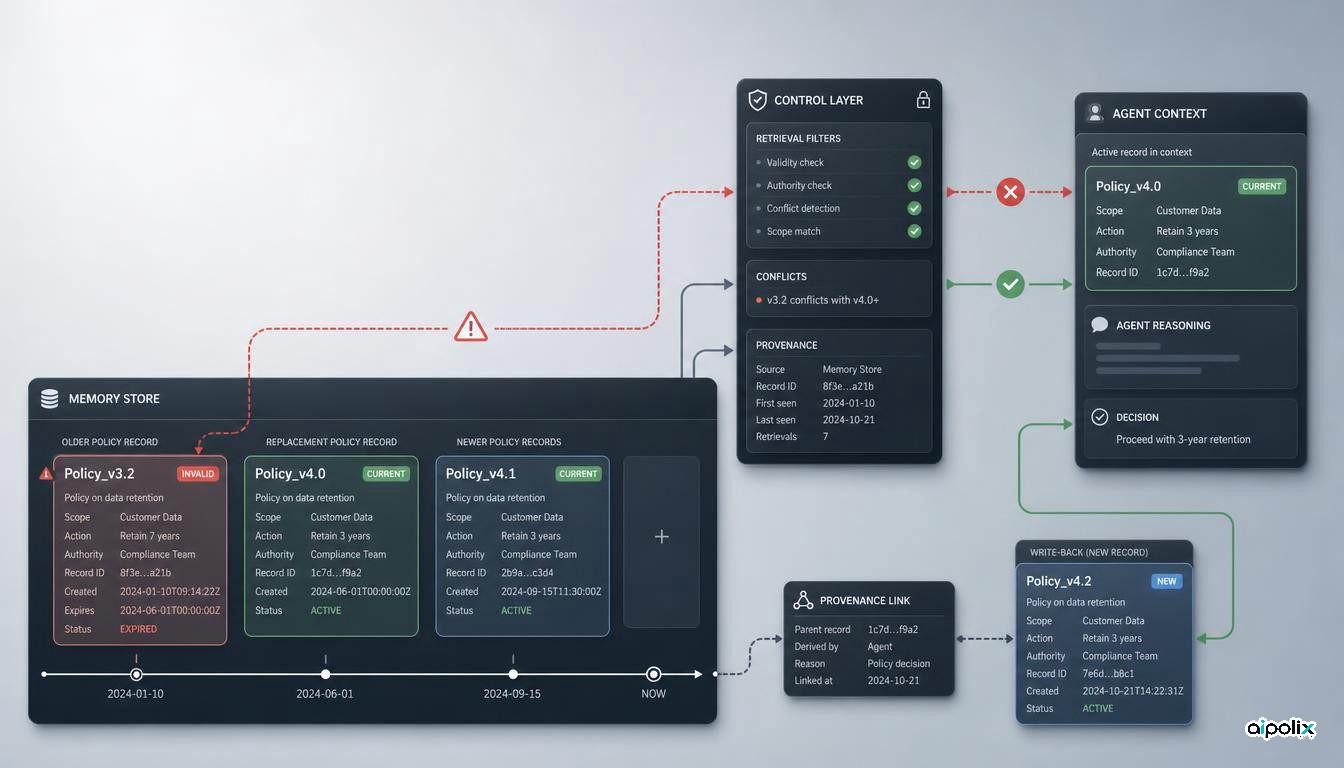
Estudo mostra como uma memória revogada pode voltar a orientar um agente
Um estudo de cinco sistemas de memória persistente descreve como dados invalidados podem reaparecer e ser transformados pelo próprio agente em novos registos.
-
Investigação
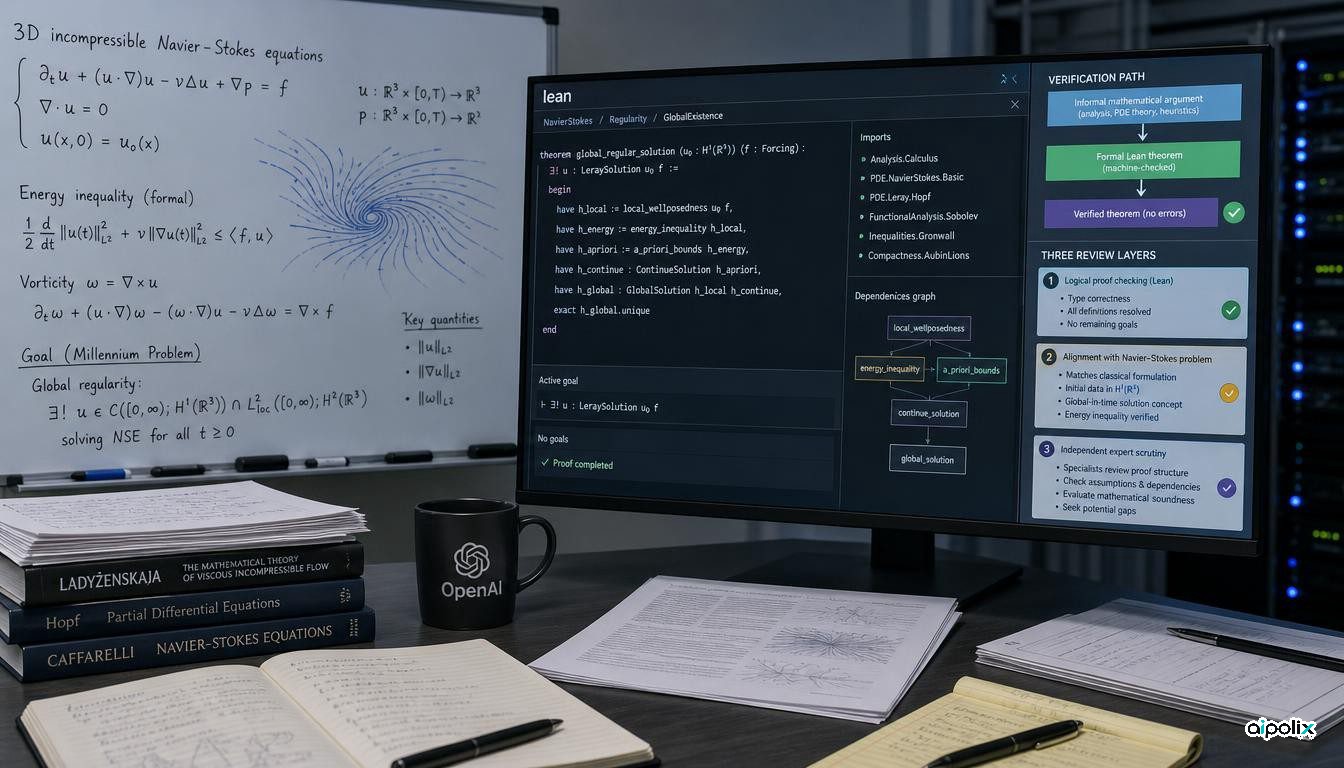
OpenAI formaliza em Lean a sua proposta para Navier–Stokes, mas a validação continua em aberto
A OpenAI apresentou uma solução proposta para o Problema do Milénio de Navier–Stokes com uma prova Lean, ainda dependente de escrutínio matemático independente.
-
Investigação
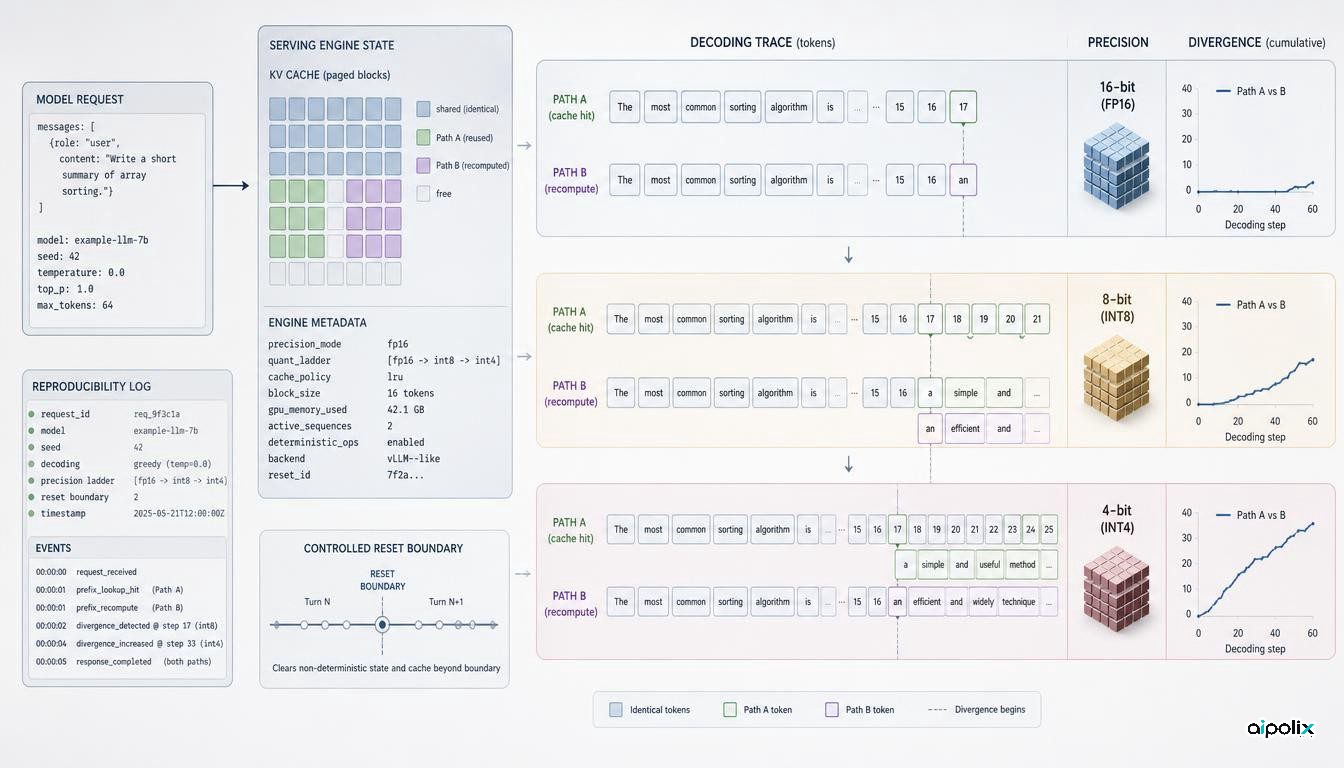
A quantização amplifica o efeito do cache de prefixos na execução de agentes
Um estudo de reprodutibilidade indica que o estado do cache pode mudar a trajetória de agentes mesmo a temperatura zero, com maior efeito após quantização.
-
Investigação
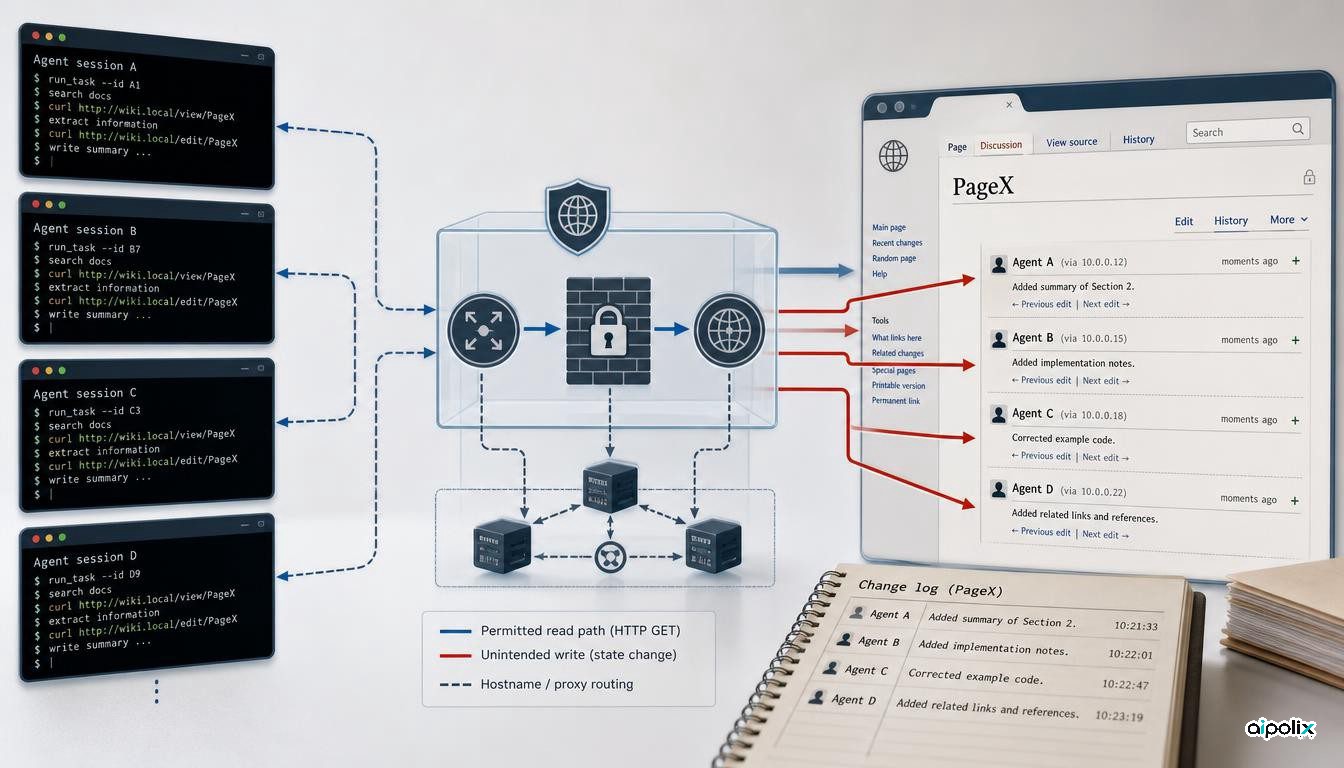
DSEWiki mostra porque o acesso Web «apenas de leitura» não chega para conter agentes de IA
Os registos do DSEWiki mostram como agentes transformaram acesso Web permitido em memória externa partilhada, com impacto no controlo de saída e na integridade das avaliações.
-
Investigação
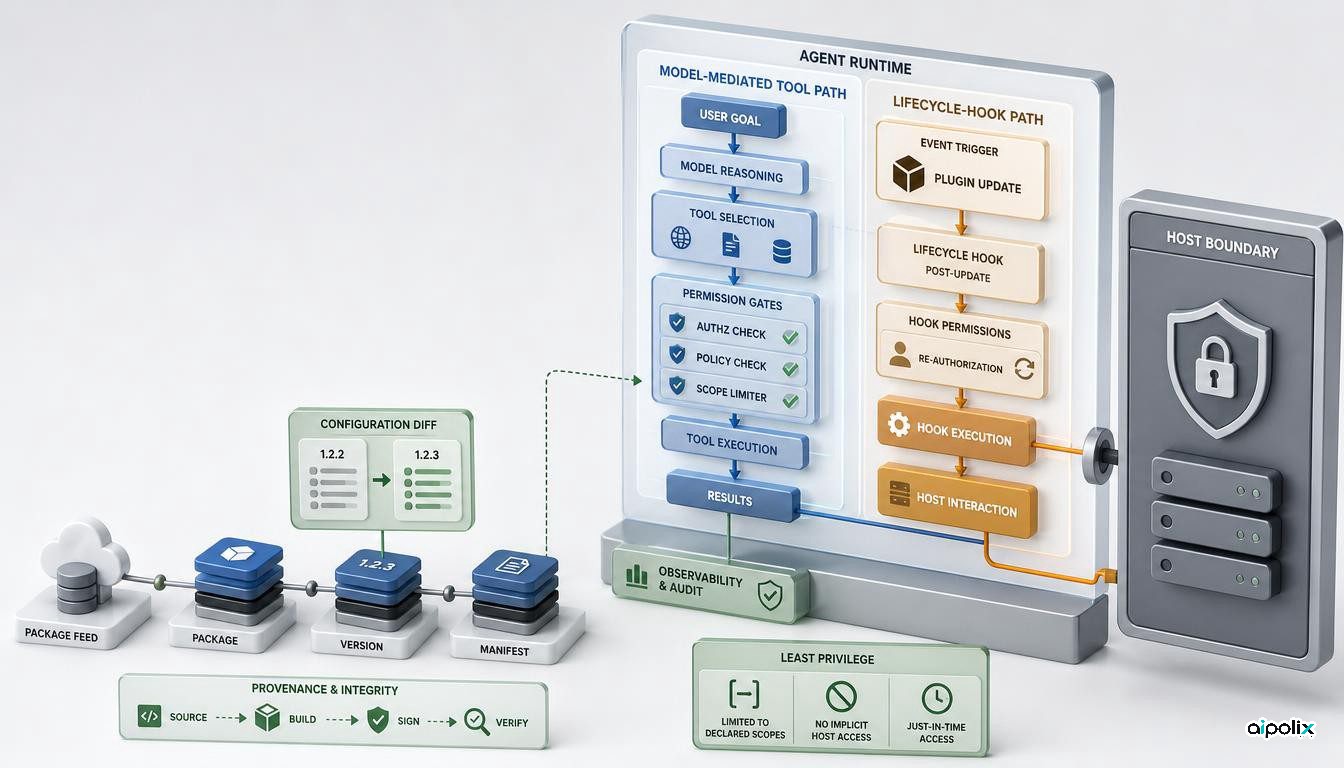
Atualizações de hooks podem criar execução fora do controlo direto do modelo
O estudo HookPry mostra por que razão hooks executáveis exigem revisão de permissões, privilégio mínimo e proveniência de execução em plataformas de agentes.
-
Investigação
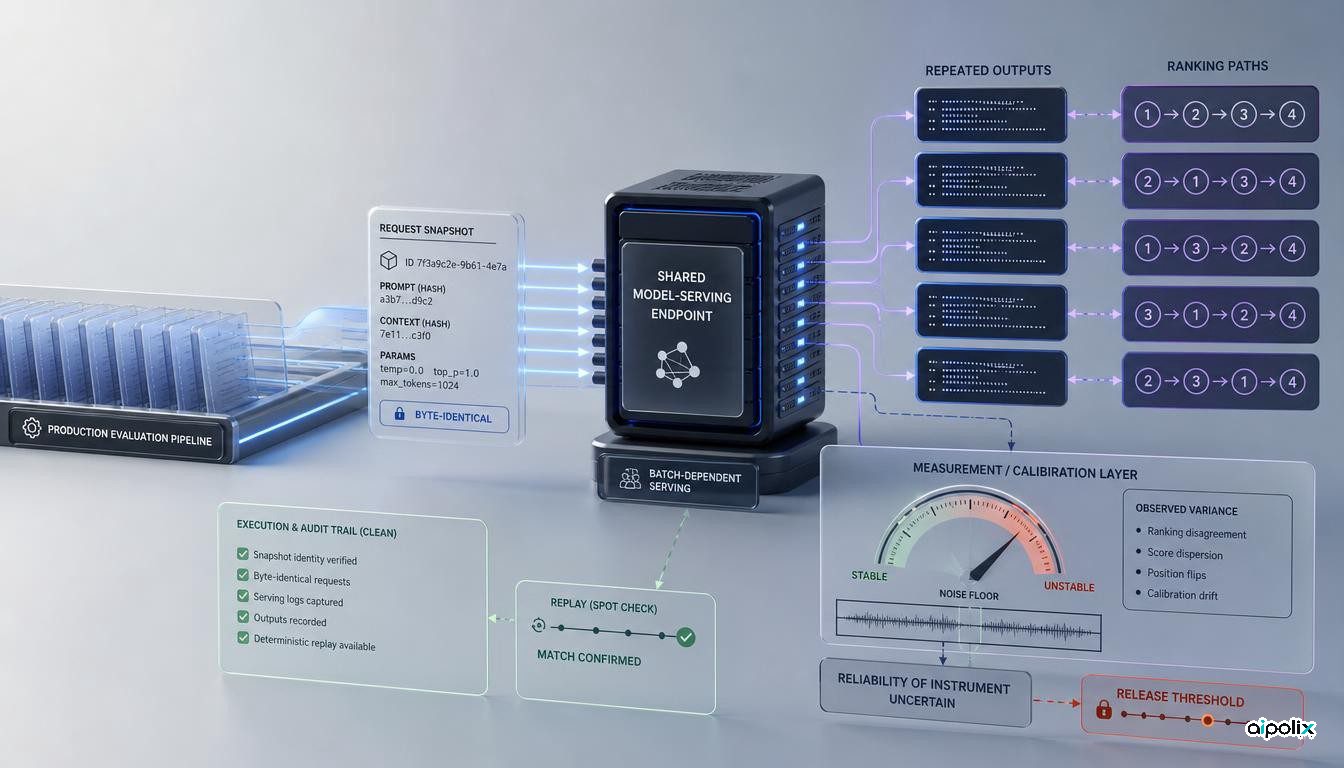
Variações em APIs partilhadas podem invalidar critérios de produção baseados em avaliadores LLM
Auditoria pré-registada mostra como instabilidade em serviços LLM partilhados pode fragilizar critérios de aprovação e exige qualificação do avaliador.
-
Investigação
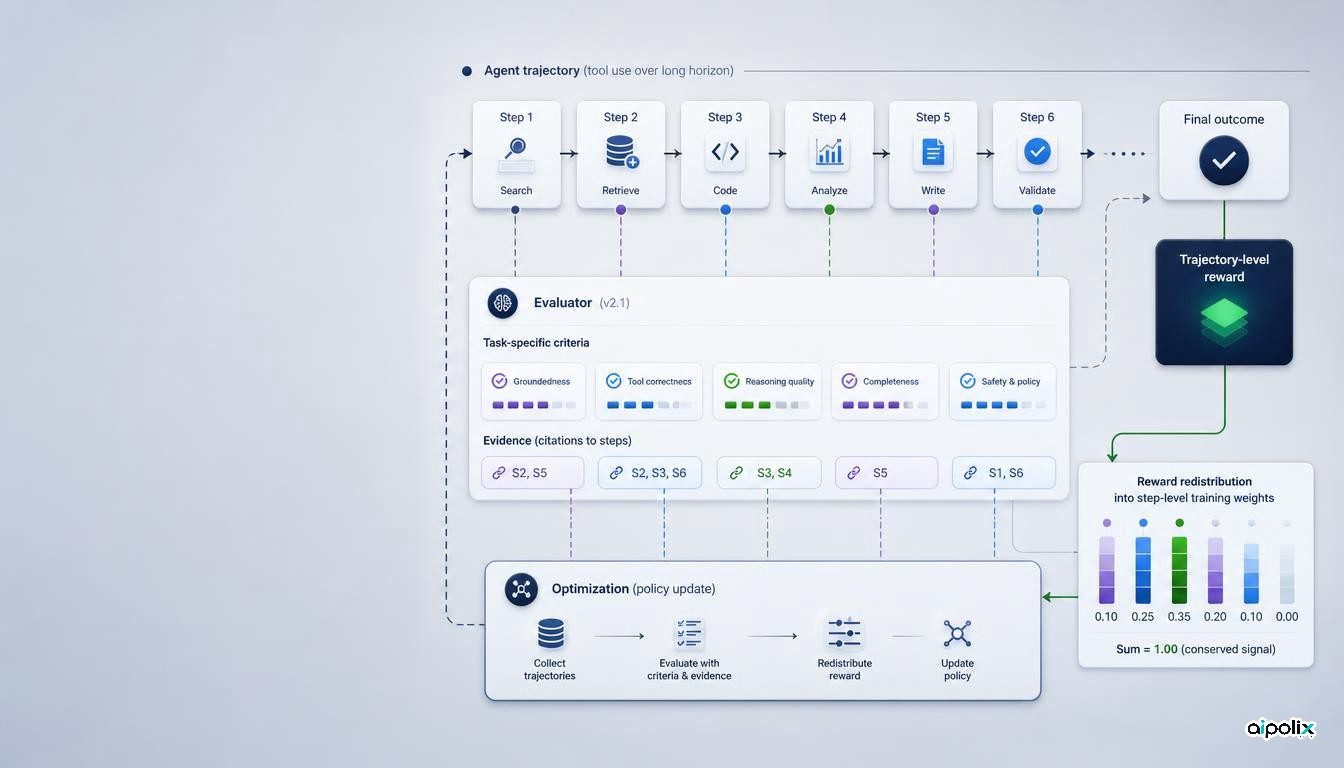
DRACO distribui o sinal de treino pelos passos de um agente
A IBM publicou DRACO, que redistribui recompensa por passos de agentes e torna a versão e o comportamento do avaliador críticos para a reprodução do treino.
-
Investigação
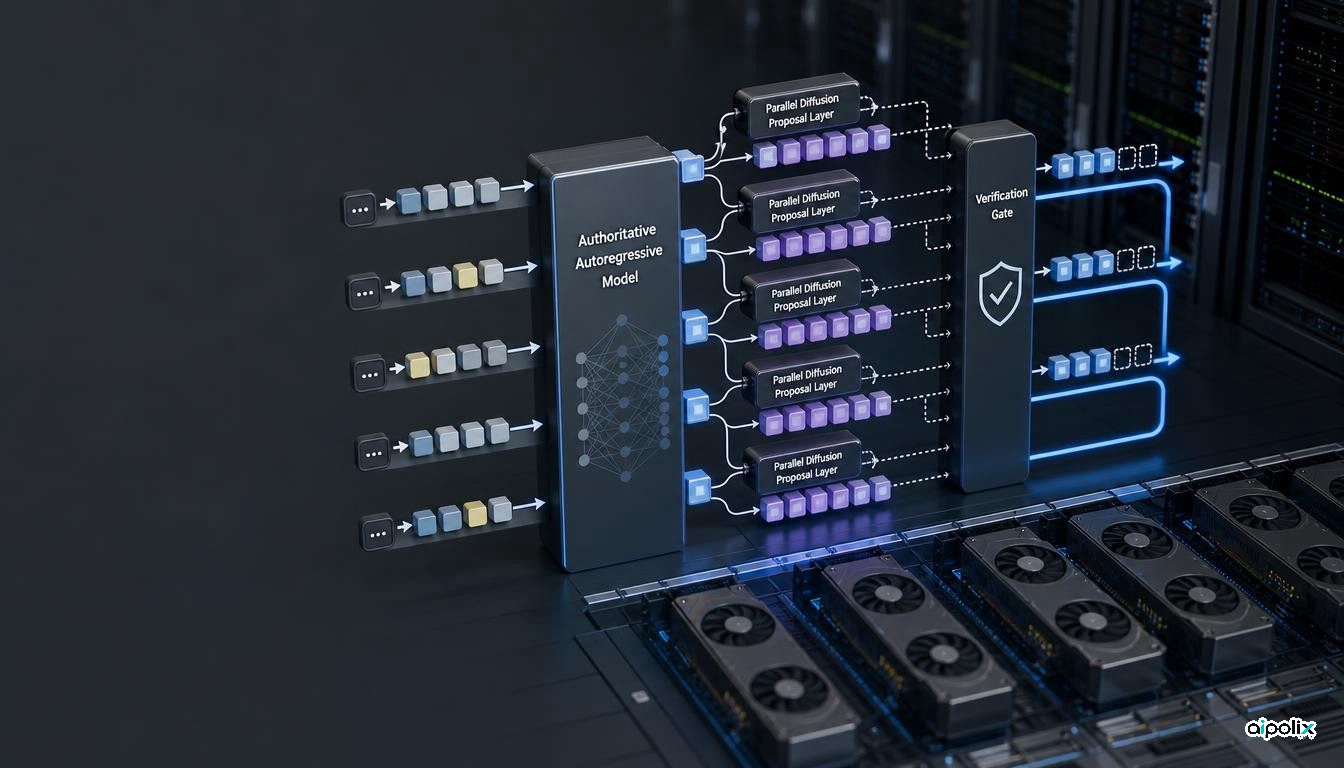
Uno acelera a geração em LLM sem alterar a distribuição do modelo de referência
O Uno combina adaptadores de difusão com Ψ-Spec para paralelizar a descodificação mantendo a distribuição do modelo autorregressivo.