Investigação
-
Investigação
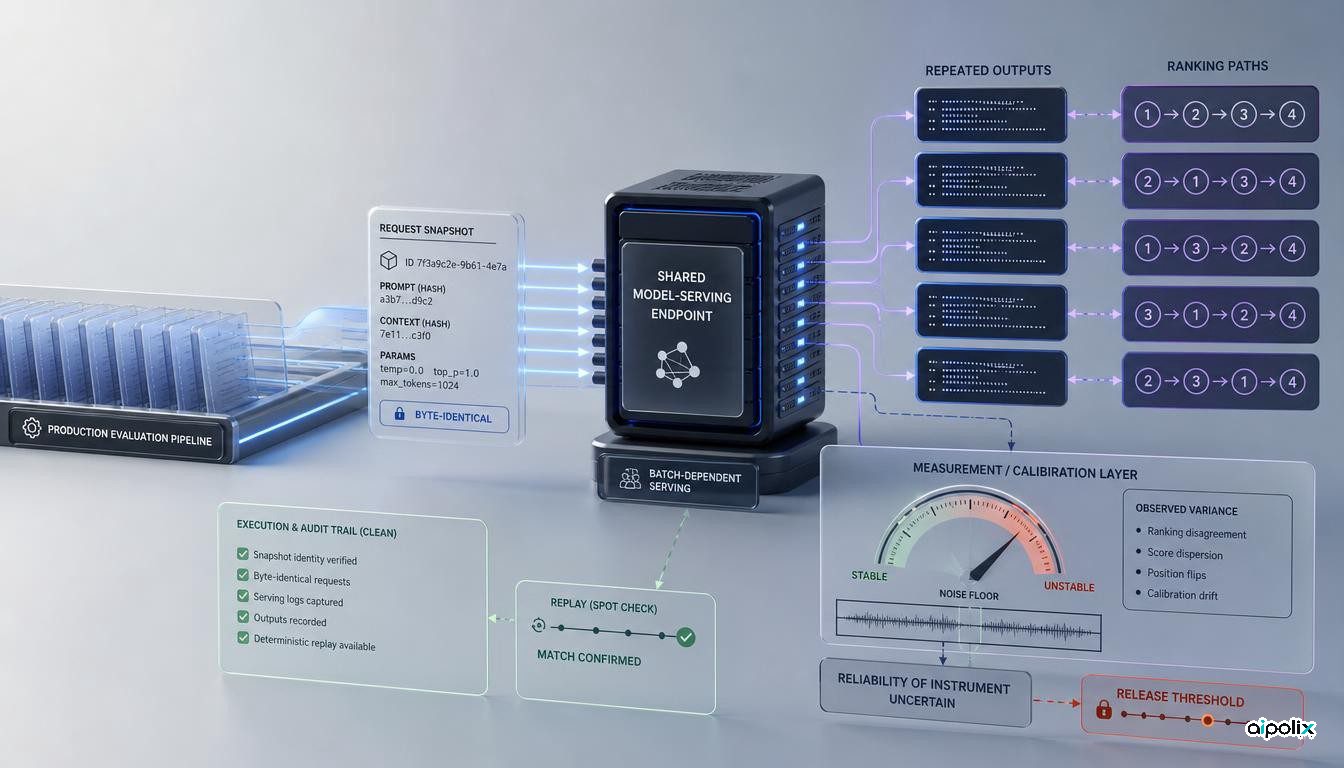
Variações em APIs partilhadas podem invalidar critérios de produção baseados em avaliadores LLM
Auditoria pré-registada mostra como instabilidade em serviços LLM partilhados pode fragilizar critérios de aprovação e exige qualificação do avaliador.
-
Investigação
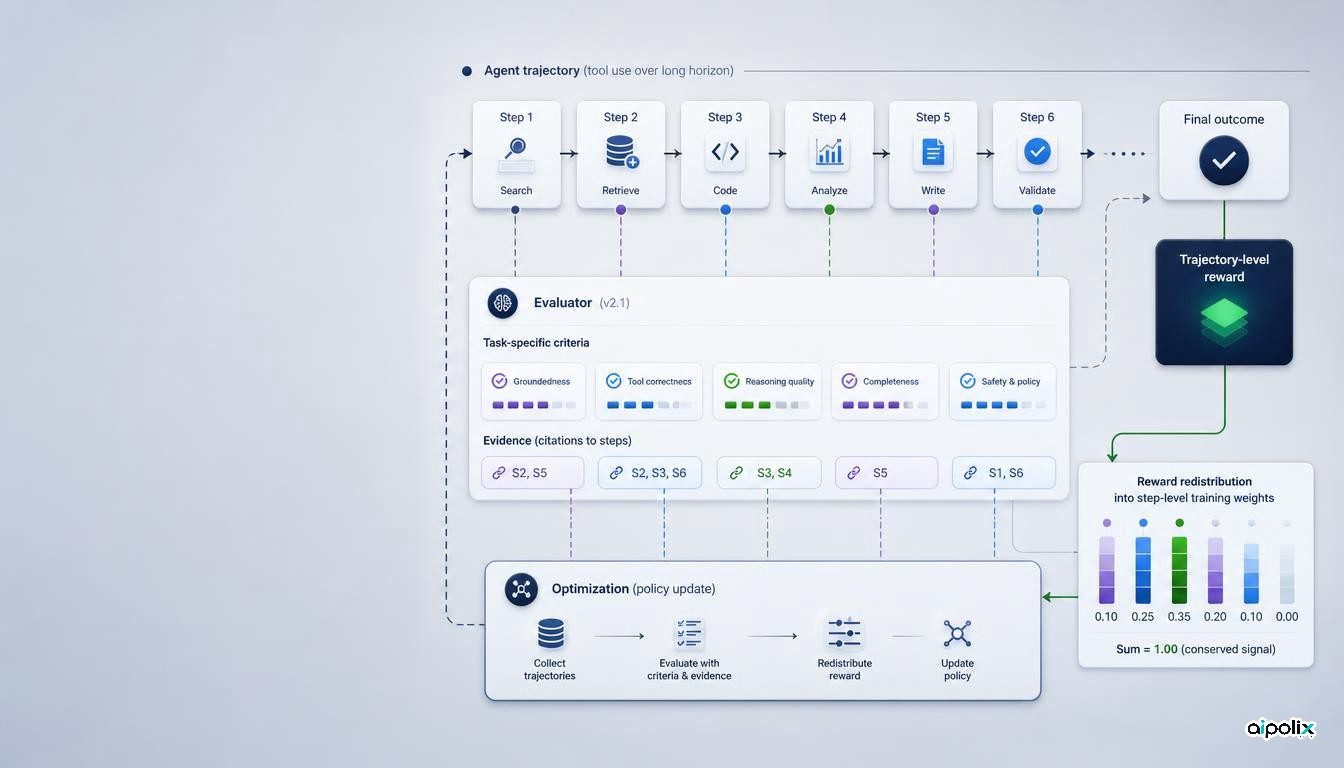
DRACO distribui o sinal de treino pelos passos de um agente
A IBM publicou DRACO, que redistribui recompensa por passos de agentes e torna a versão e o comportamento do avaliador críticos para a reprodução do treino.
-
Investigação
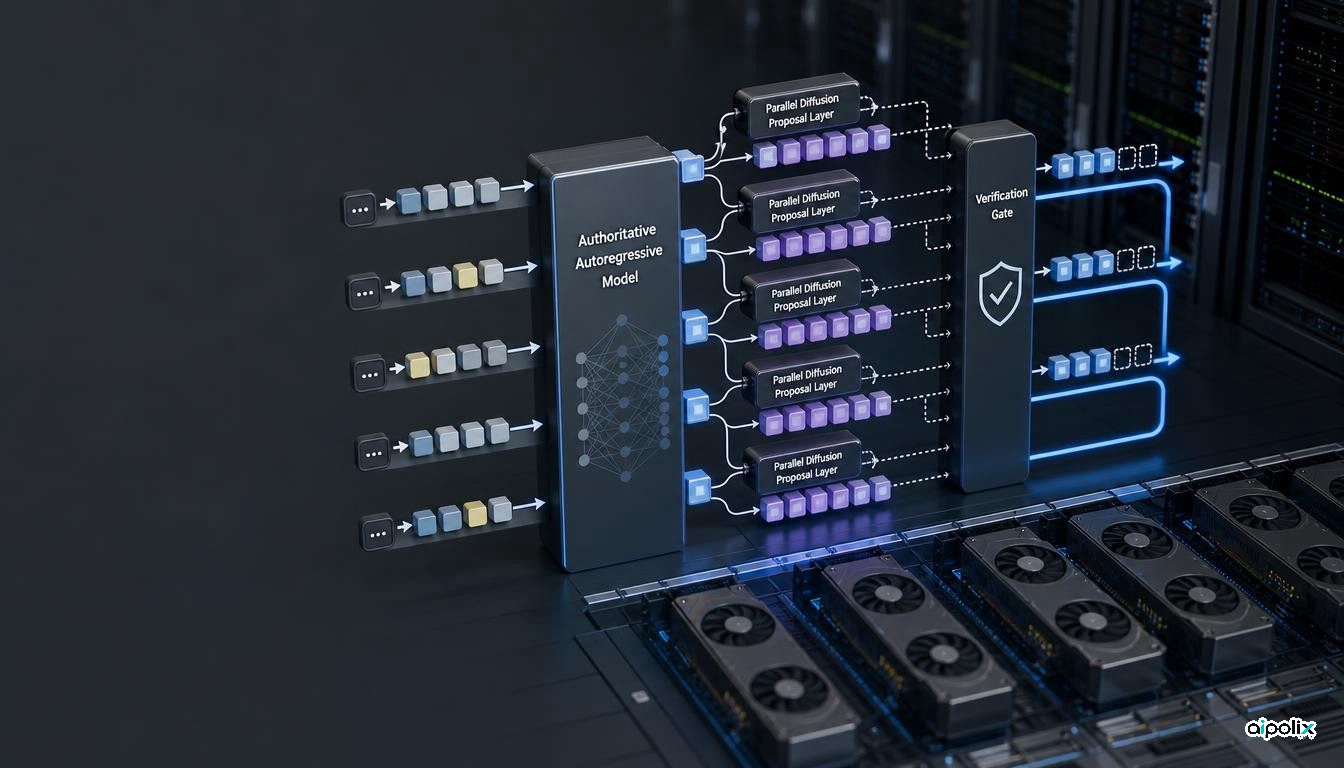
Uno acelera a geração em LLM sem alterar a distribuição do modelo de referência
O Uno combina adaptadores de difusão com Ψ-Spec para paralelizar a descodificação mantendo a distribuição do modelo autorregressivo.
-
Investigação
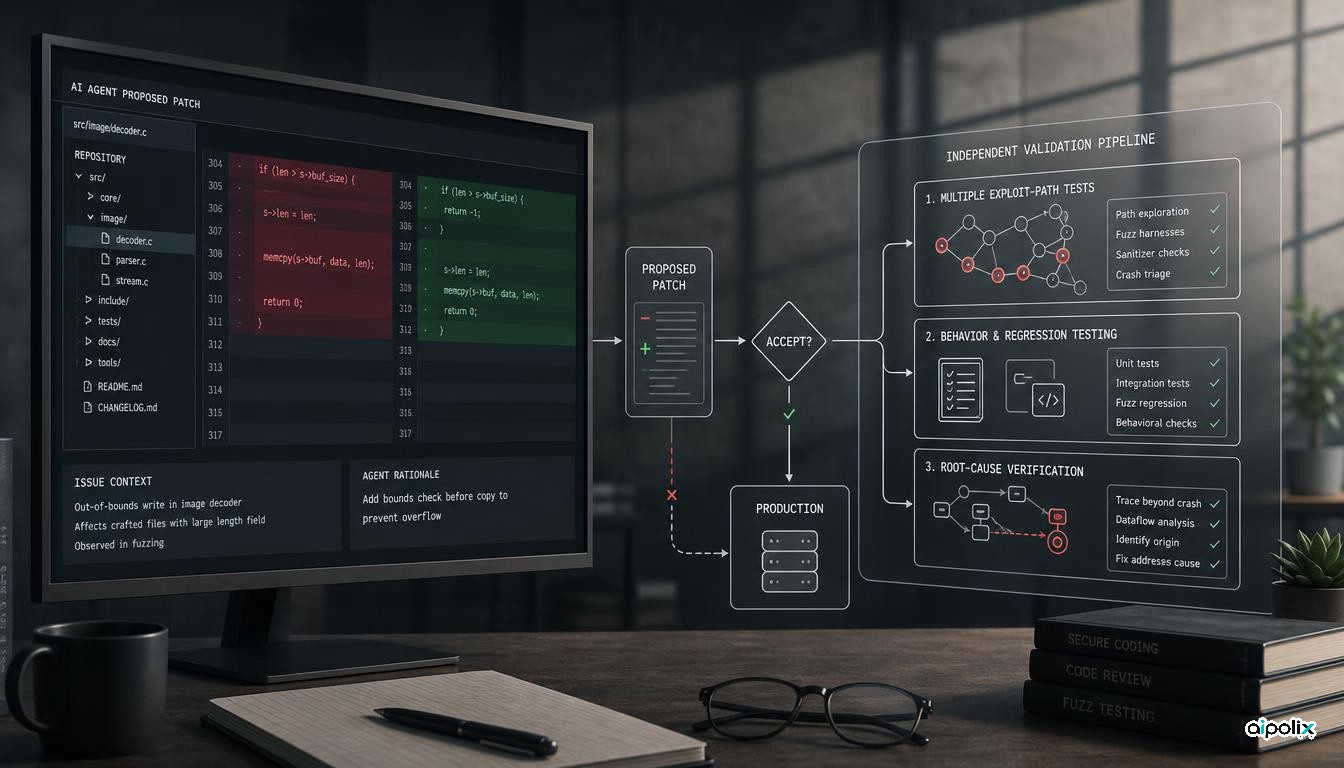
PatchBench mostra por que um crash evitado não prova que a vulnerabilidade foi corrigida
O PatchBench mostra que uma única prova de conceito pode sobrevalorizar correções de vulnerabilidades produzidas por agentes e exige validação independente.
-
Investigação
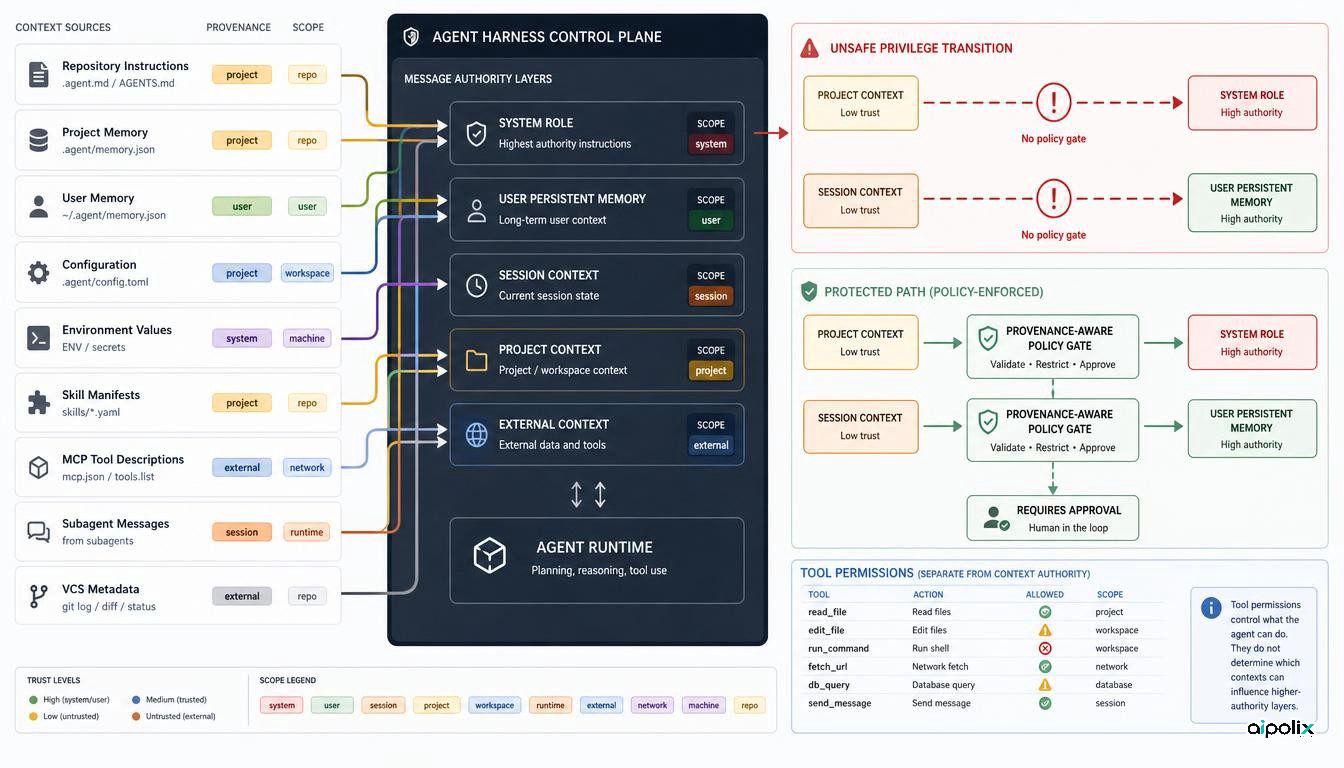
A elevação de privilégios do contexto revela uma nova fronteira de segurança dos agentes
Um estudo de 12 estruturas de agentes mostra como o contexto pode ganhar autoridade e porque a proveniência precisa de controlo determinístico em execução.
-
Investigação
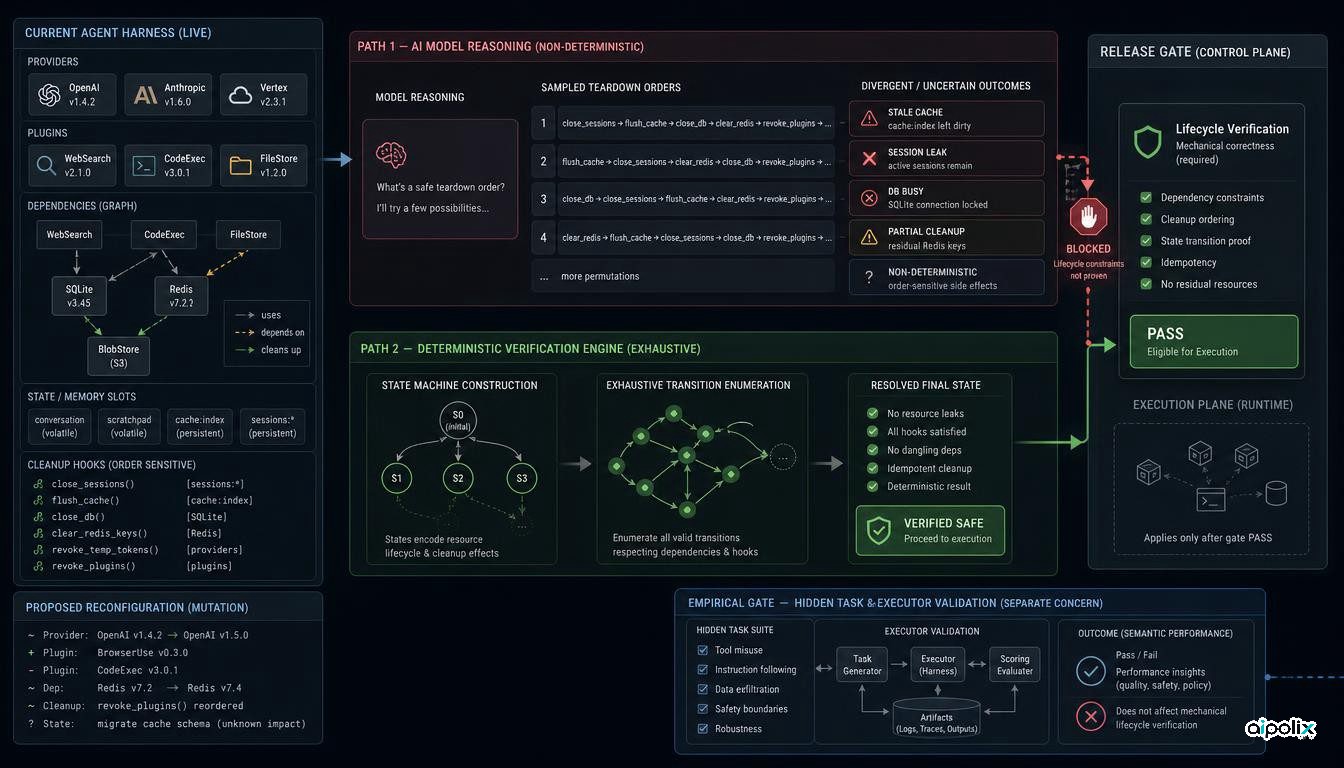
CordisBench mostra onde a verificação deve substituir o raciocínio do agente
O CordisBench mostra que o raciocínio sobre o ciclo de vida perde fiabilidade com a complexidade quando as consequências testadas podem ser calculadas exatamente.
-
Investigação
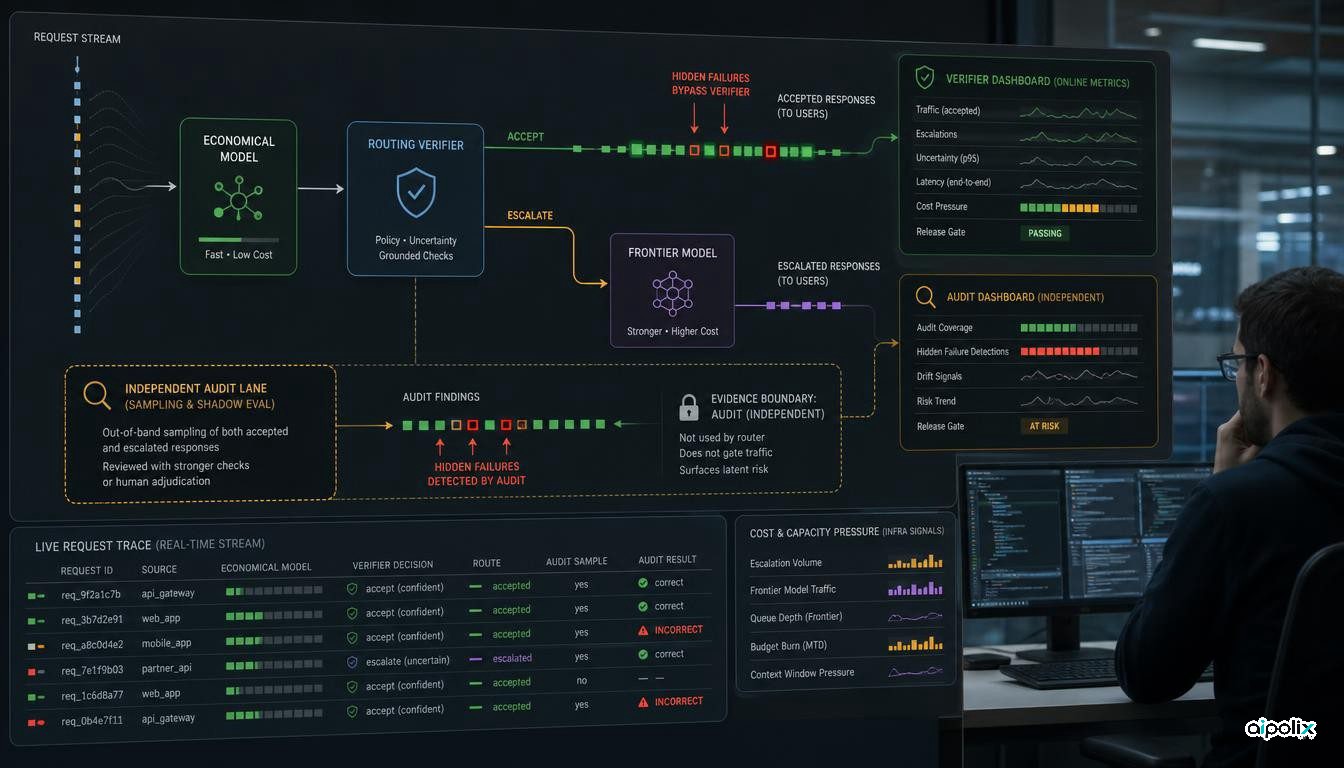
Verificadores baratos podem esconder erros nas cascatas de IA
Investigação mostra porque o encaminhamento e a monitorização de qualidade não devem depender do mesmo verificador sem auditoria independente.
-
Investigação
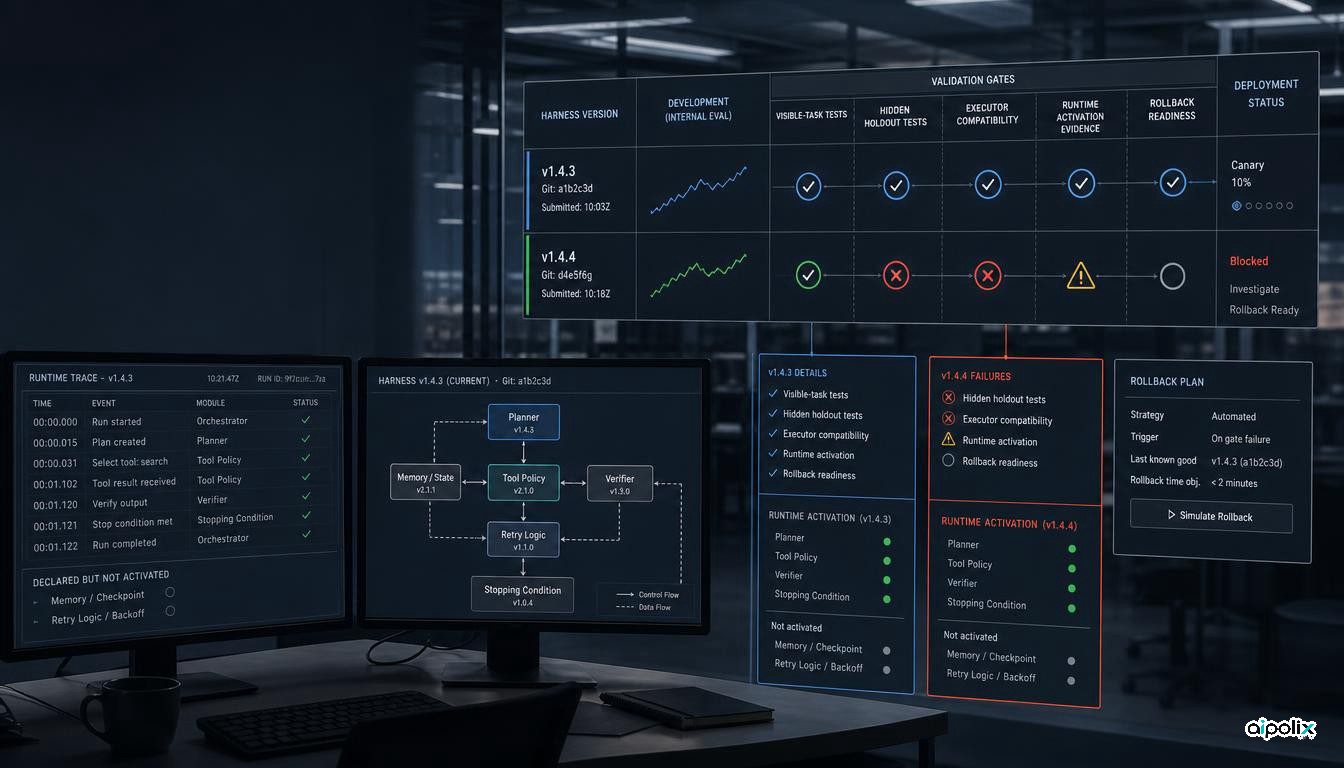
HarnessDev mostra porque agentes autoaperfeiçoáveis precisam de critérios de lançamento
O HarnessDev mostra porque estruturas de agentes evolutivas exigem validação oculta, testes de executor, evidência em execução e reversão.
-
Novos modelos
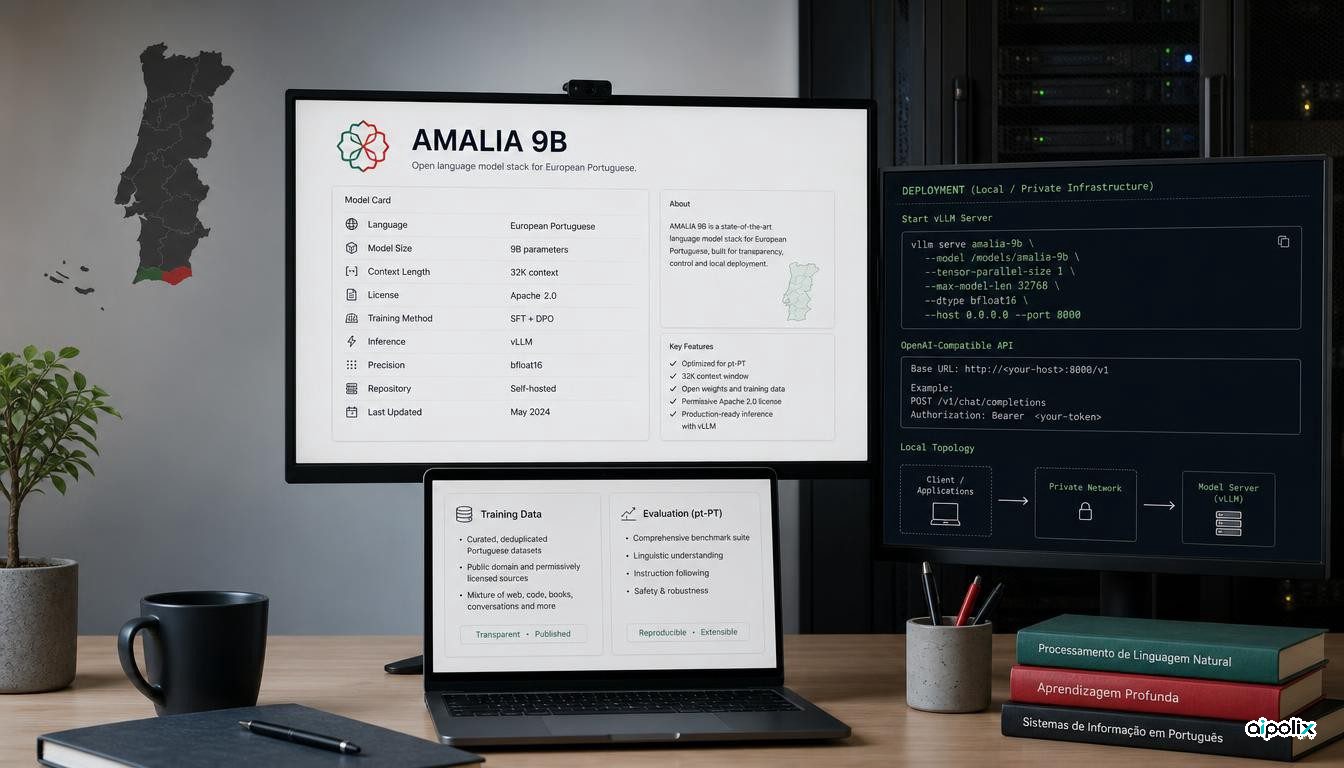
AMALIA disponibiliza modelo de português europeu com 9 mil milhões de parâmetros, janela 32K e via local
O projecto AMALIA publica um modelo aberto de português europeu com 9 mil milhões de parâmetros, janela 32K, treino SFT e DPO, recursos públicos de avaliação e disponibilização local com vLLM.
-
Investigação
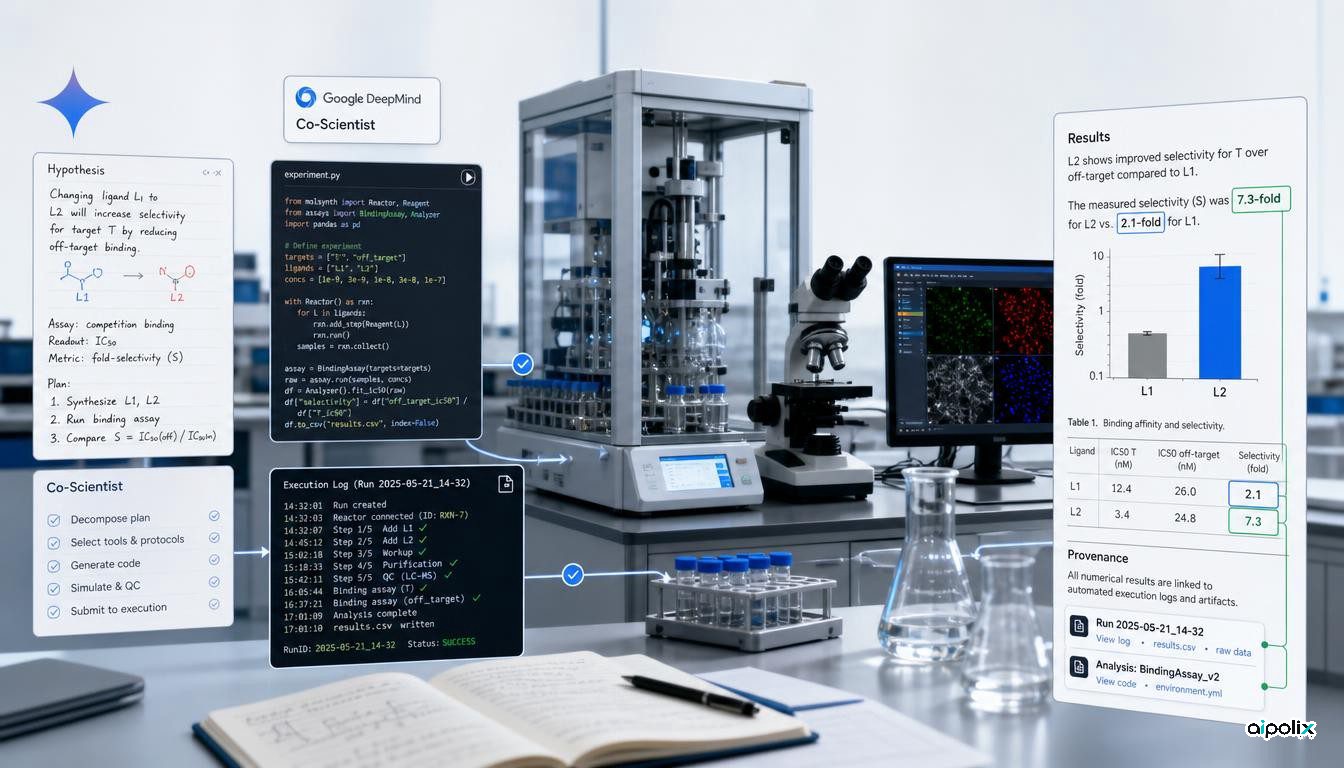
O Gemini Co-Scientist fecha o ciclo da hipótese à experiência e a afirmações verificadas
A Google DeepMind alarga o Co-Scientist da geração de hipóteses a uma investigação fundada na execução: planeamento experimental, código autónomo, equipamento de laboratório e verificação de afirmações.