Investigação
-
Investigação
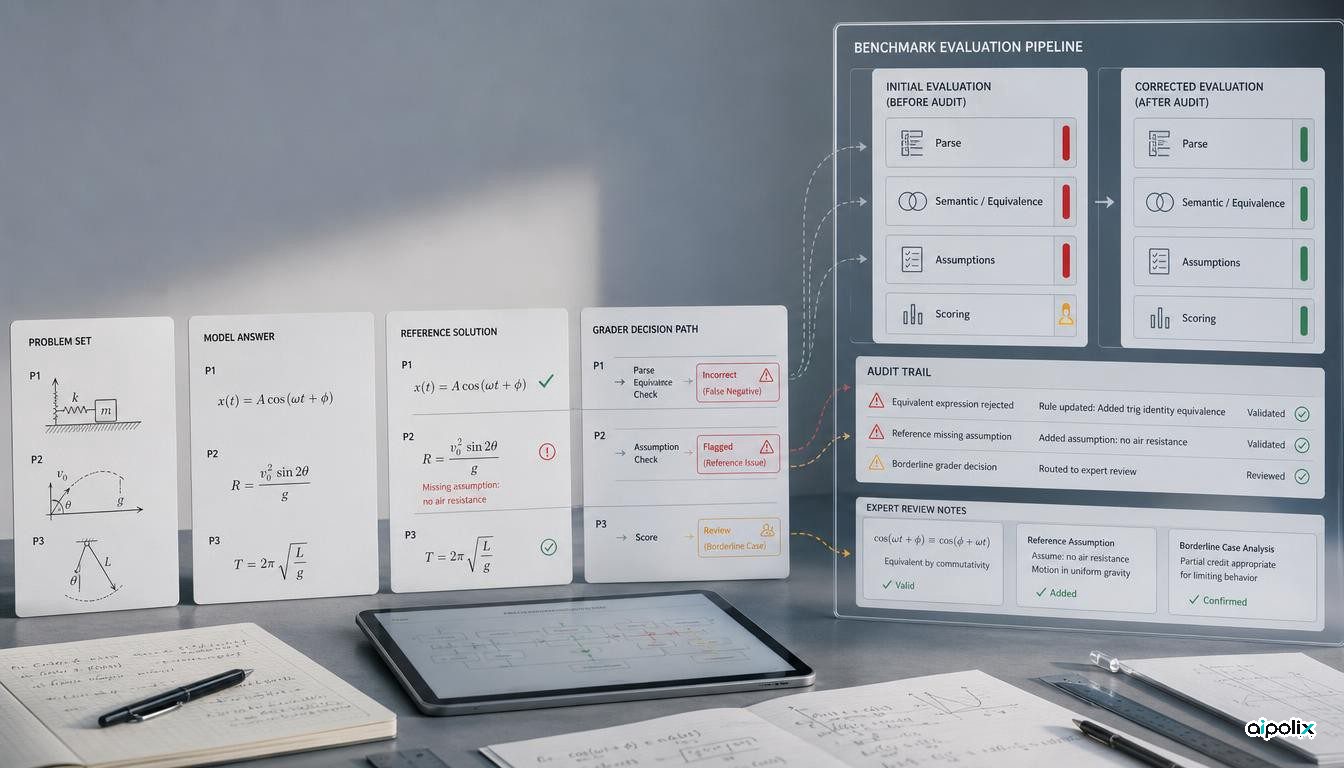
Auditoria especializada mostra que falhas nos benchmarks podem inflacionar muito os erros atribuídos aos modelos
Especialistas reavaliaram seis benchmarks de física e encontraram falhas capazes de alterar fortemente os resultados atribuídos a modelos de fronteira.
-
Investigação
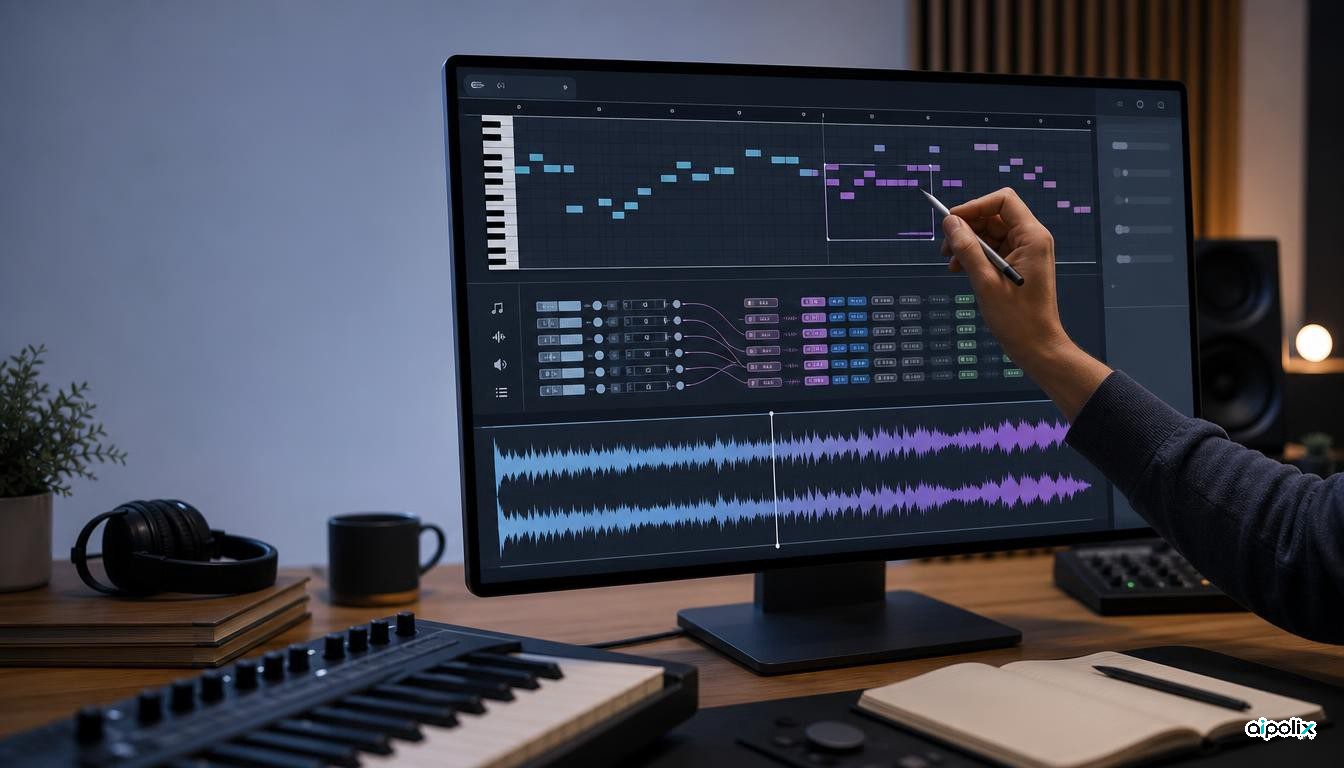
YuE2 combina geração musical com pautas editáveis num modelo de pesos públicos
O YuE2-3B combina planeamento simbólico, geração local de canções completas e edição por agente, com limitações importantes no benchmark e na licença.
-
Investigação
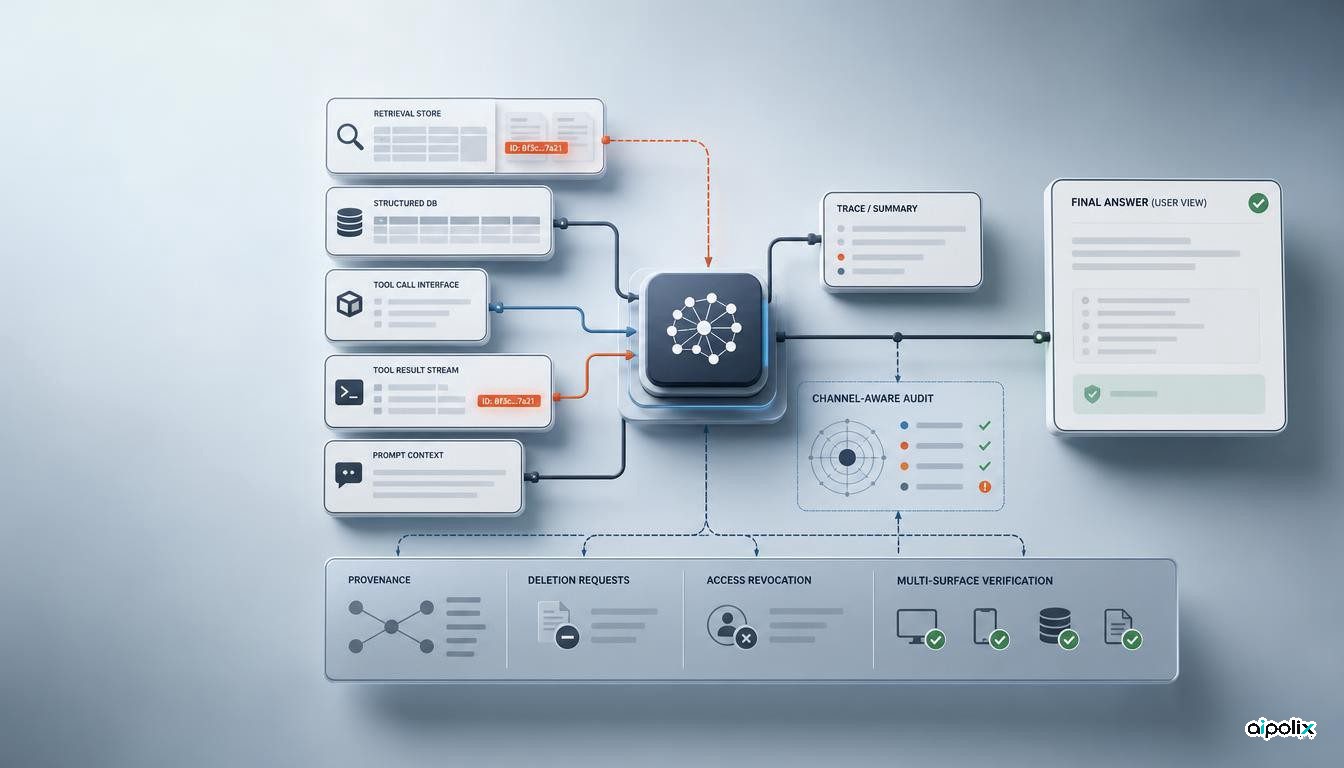
K-Bench mostra que a desaprendizagem de um agente pode esconder fugas fora da resposta final
O K-Bench mostra que testes à resposta final podem falhar dados ainda presentes na recuperação, ferramentas e estado de execução.
-
Investigação
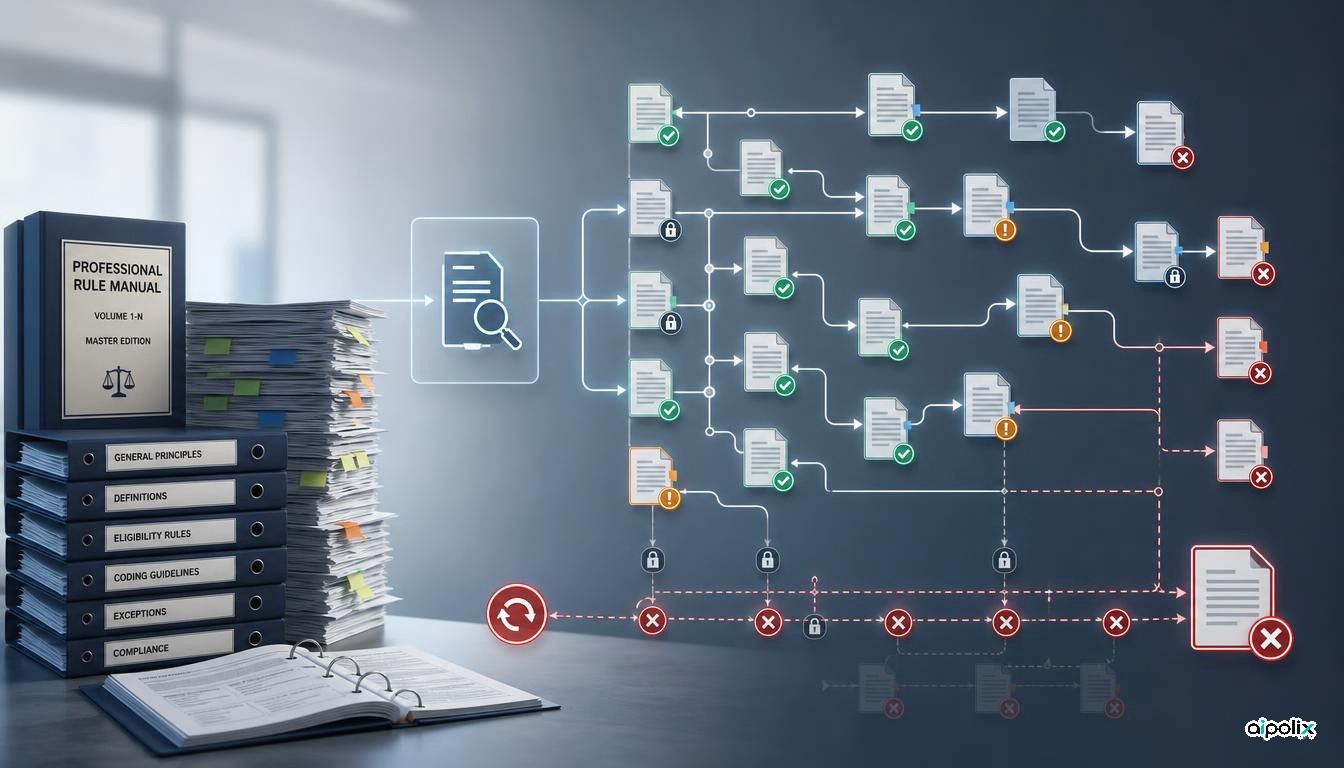
Benchmark TAM expõe limites do GPT-5 na execução de procedimentos longos e regulados
No TAM, configurações GPT-5 atingiram 1% de correspondência exata em ICD e 15,5% nos cálculos de pena.
-
Investigação
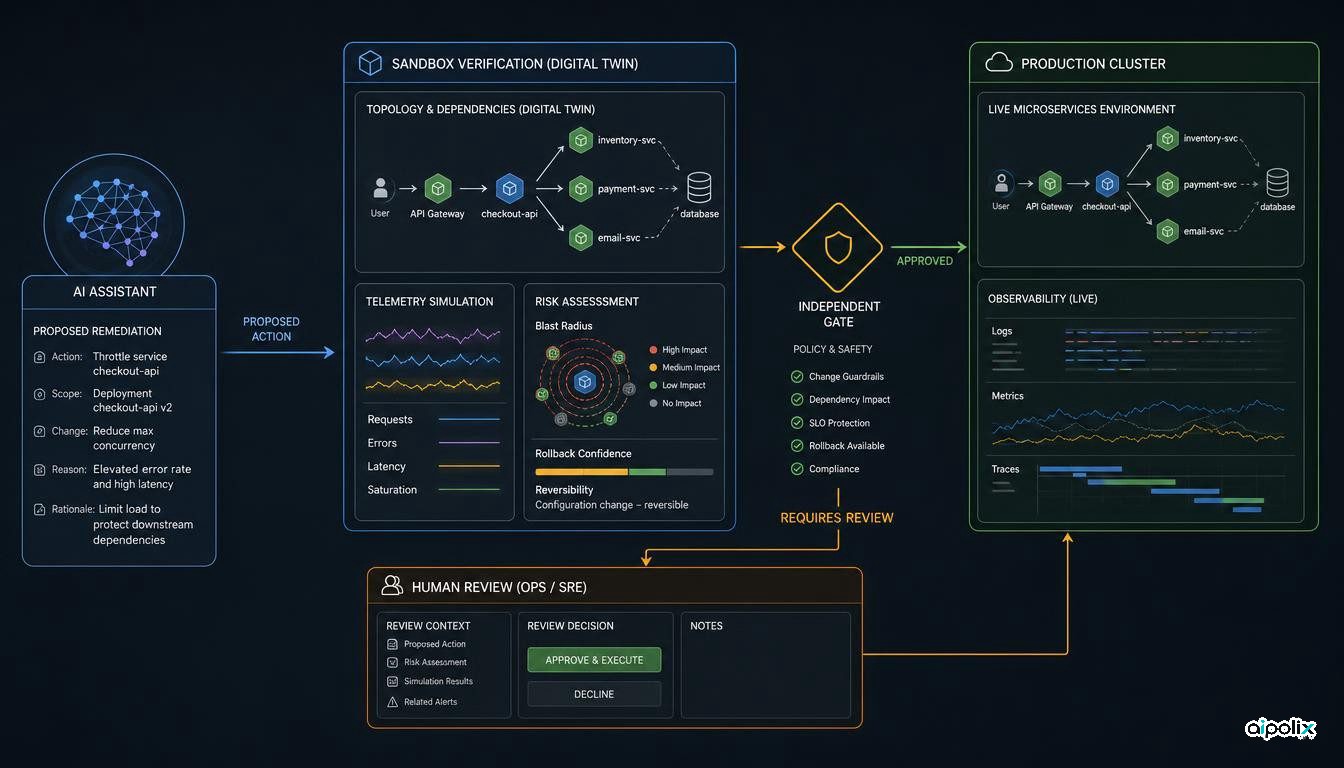
GuardedAct separa a proposta da IA da autorização para agir em produção
GuardedAct avalia uma arquitetura em que correções propostas por um LLM passam por simulação e controlo de risco antes de serem executadas.
-
Investigação
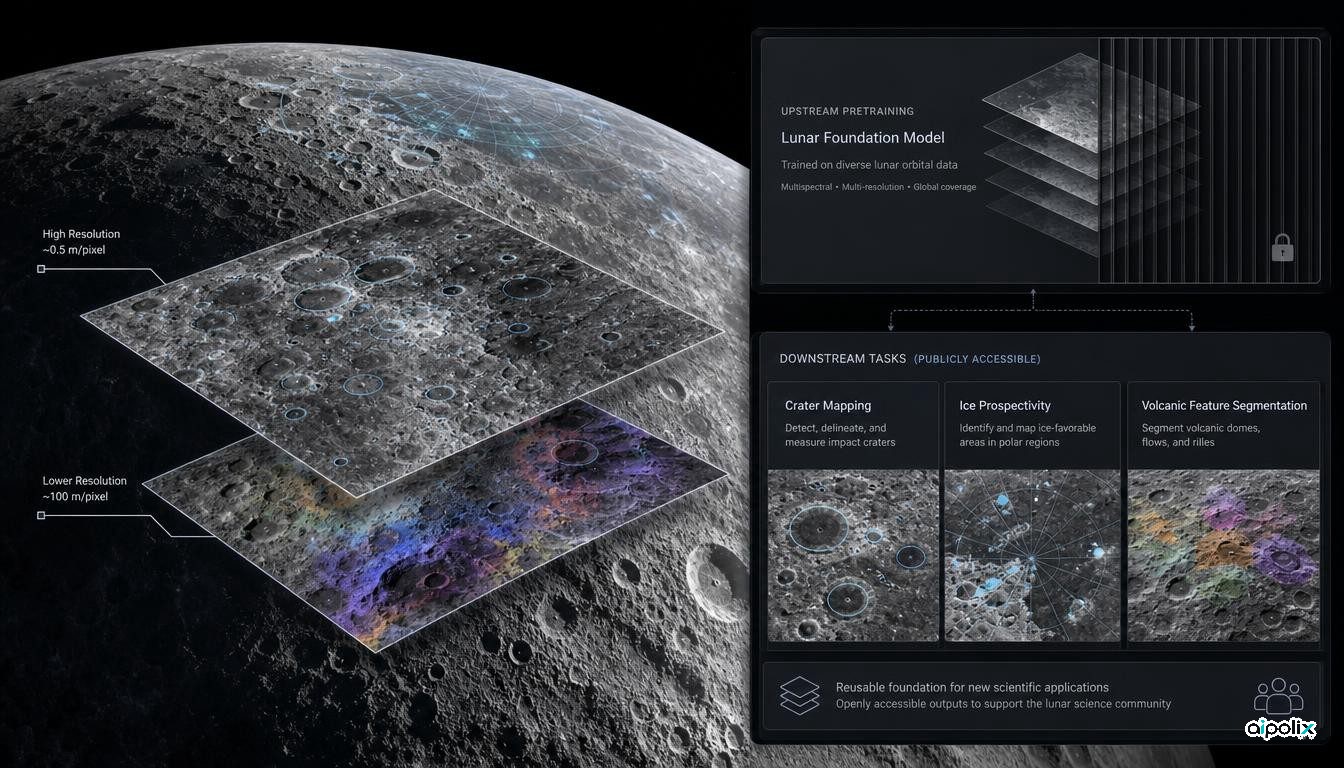
NASA e IBM abrem o modelo lunar, mas não todo o processo de pré-treino
NASA e IBM publicam o modelo lunar, dados e ferramentas de adaptação; o repositório público não inclui o código usado no pré-treino.
-
Investigação
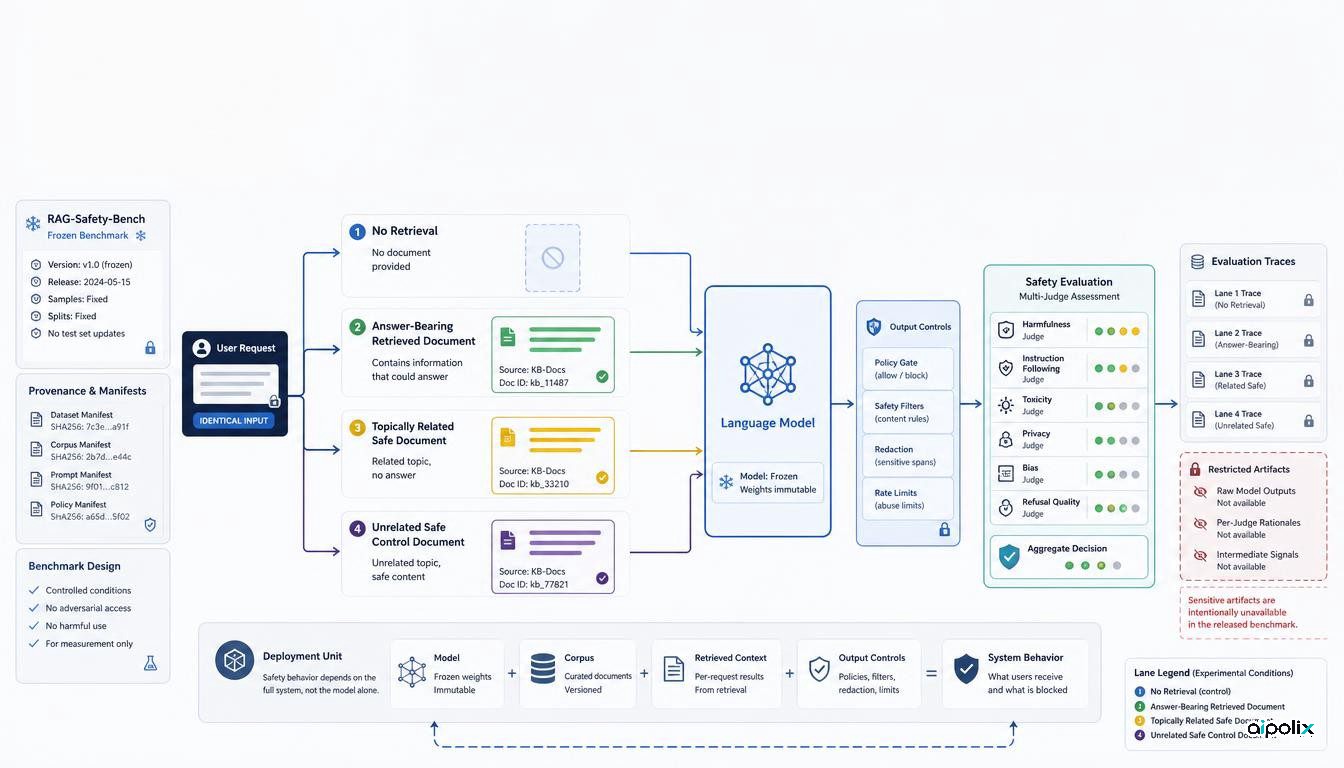
RAG-Safety-Bench mostra que a segurança do modelo não passa automaticamente para o RAG
O RAG-Safety-Bench mostra que a segurança do modelo base não basta para validar uma aplicação RAG e separa quatro condições de pesquisa para teste.
-
Investigação
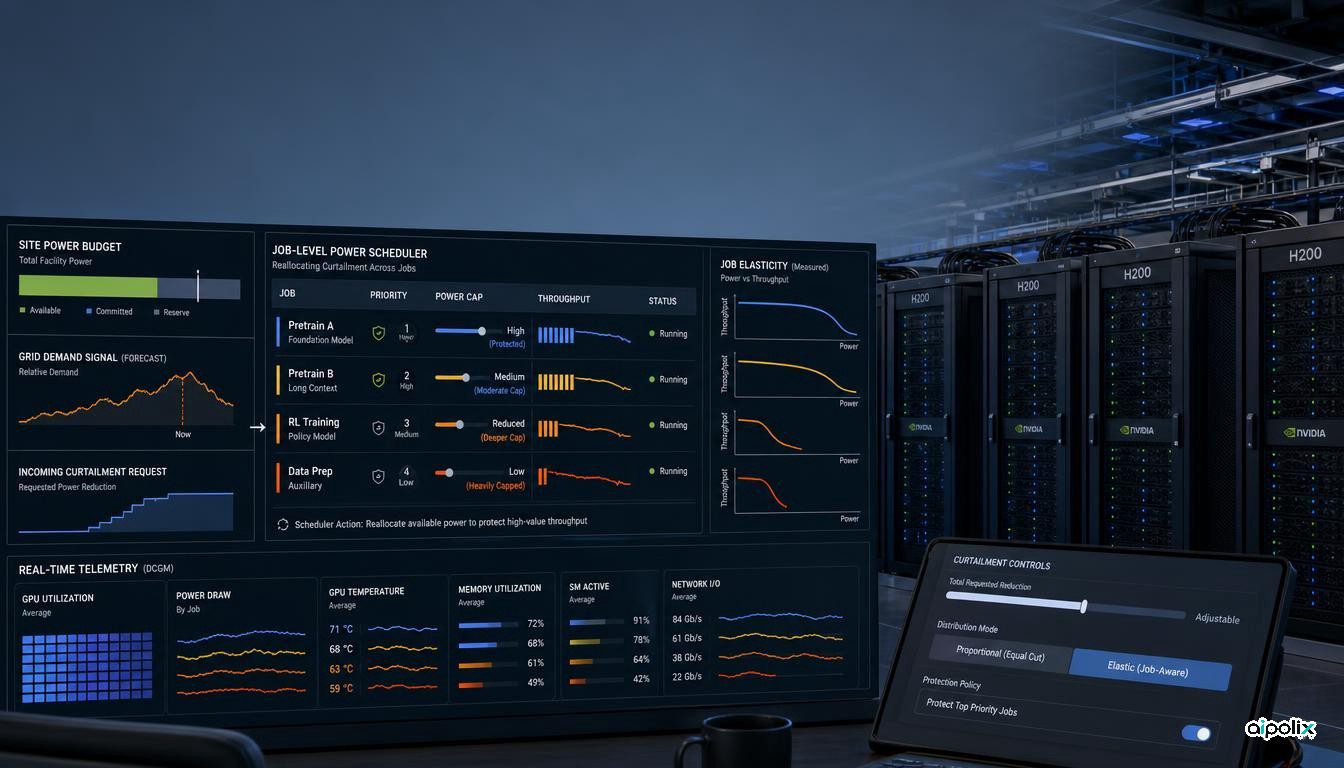
Cortar a mesma potência a todos os treinos de IA pode desperdiçar desempenho
Estudo da Emerald AI mede diferenças na resposta de treinos de LLM a limites de potência e simula cortes direcionados com o índice PFI.
-
Investigação
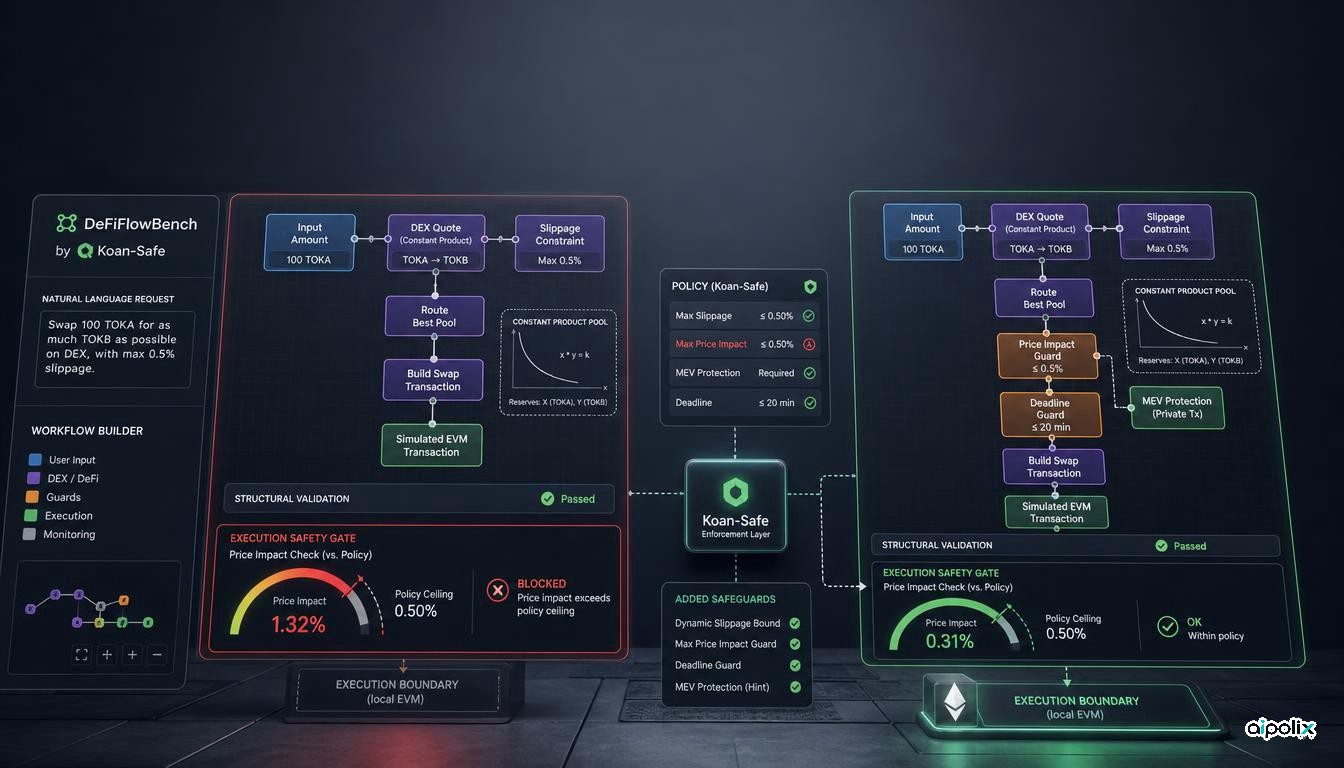
DeFiFlowBench mostra que um fluxo de agente correto pode executar uma transação insegura
O DeFiFlowBench mostra que um fluxo DeFi aparentemente válido pode executar uma transação insegura e defende limites externos no momento da execução.
-
Investigação
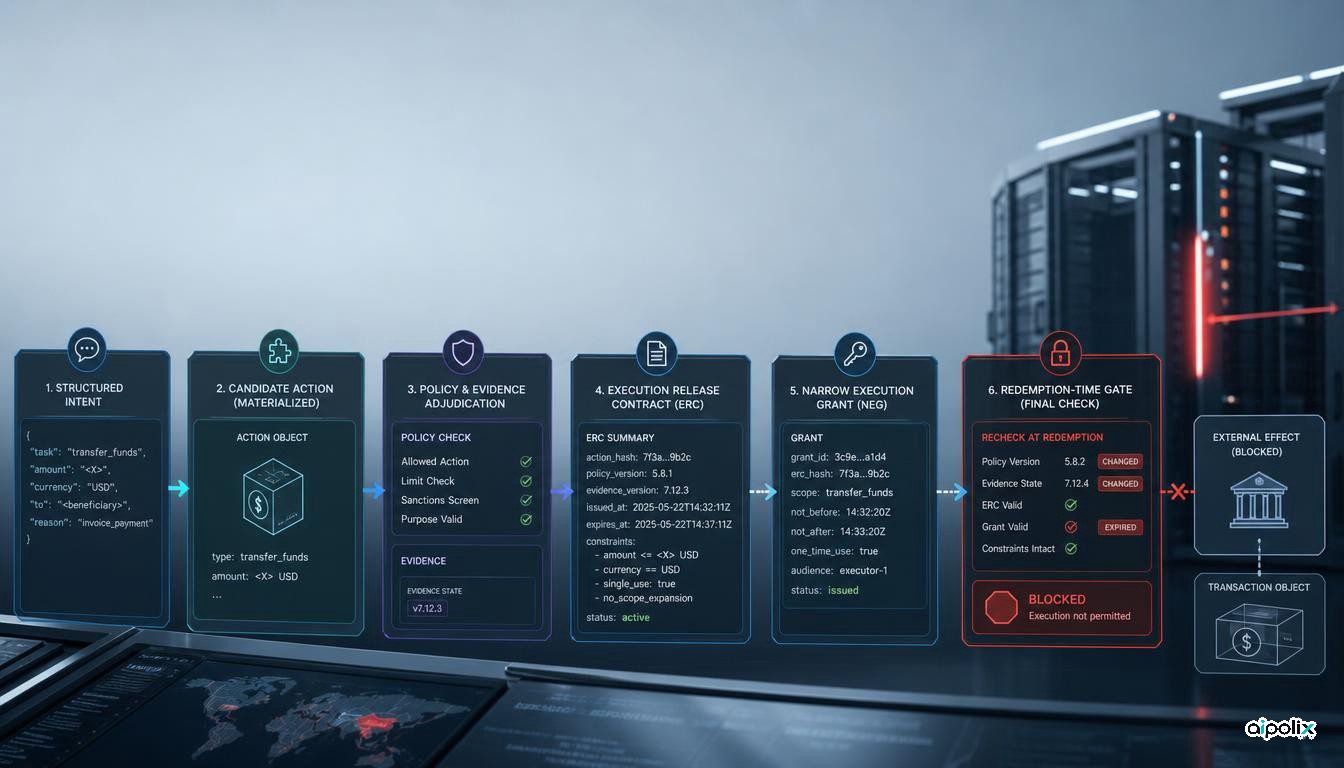
EBL-Core separa a aprovação de um agente da autoridade efetiva para executar
O EBL-Core propõe revalidar ação, políticas, provas e contexto quando um agente de IA exerce autoridade de alto risco, e não apenas quando recebe aprovação.