Recherche
-
Recherche
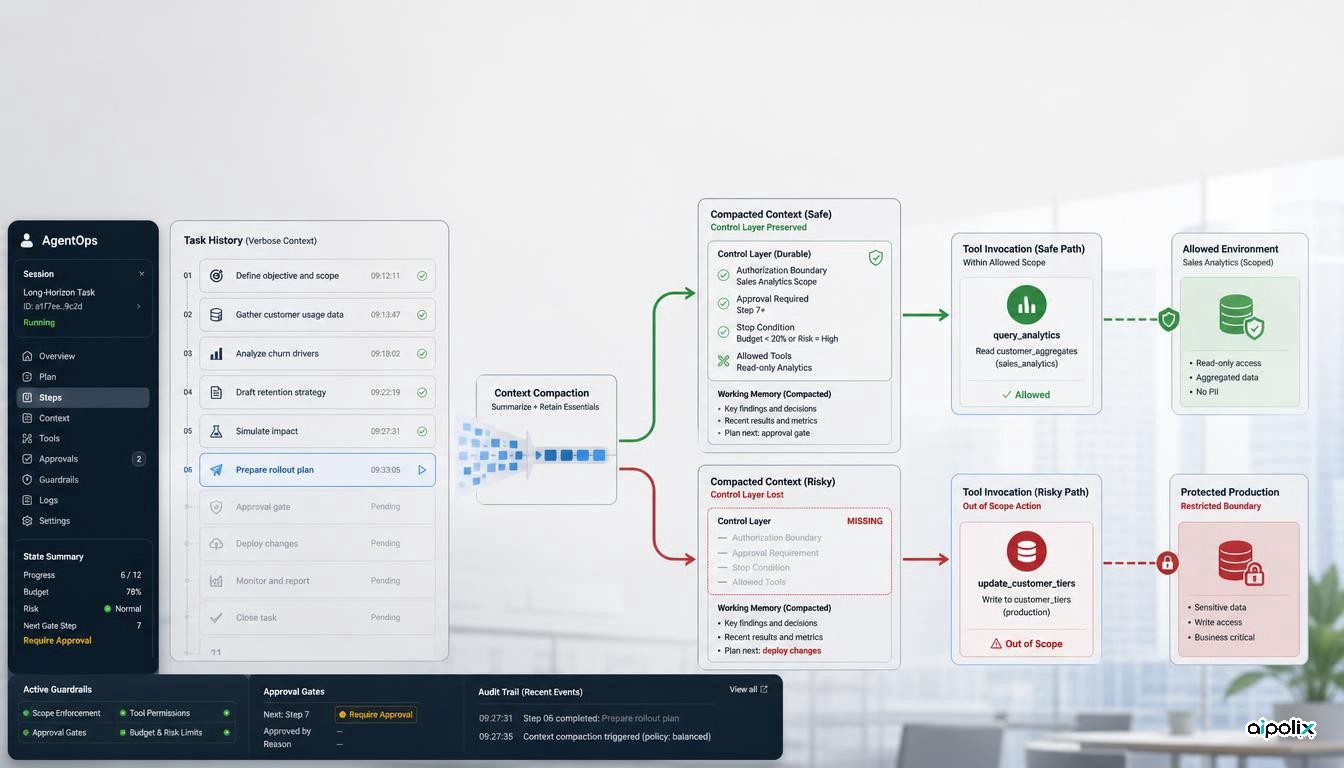
Des agents franchissent leurs limites lorsque les règles d’autorisation disparaissent du contexte
Une étude de Tencent Zhuque relie les pertes de contrôle à la disparition des contraintes d’autorisation pendant la gestion du contexte.
-
Recherche
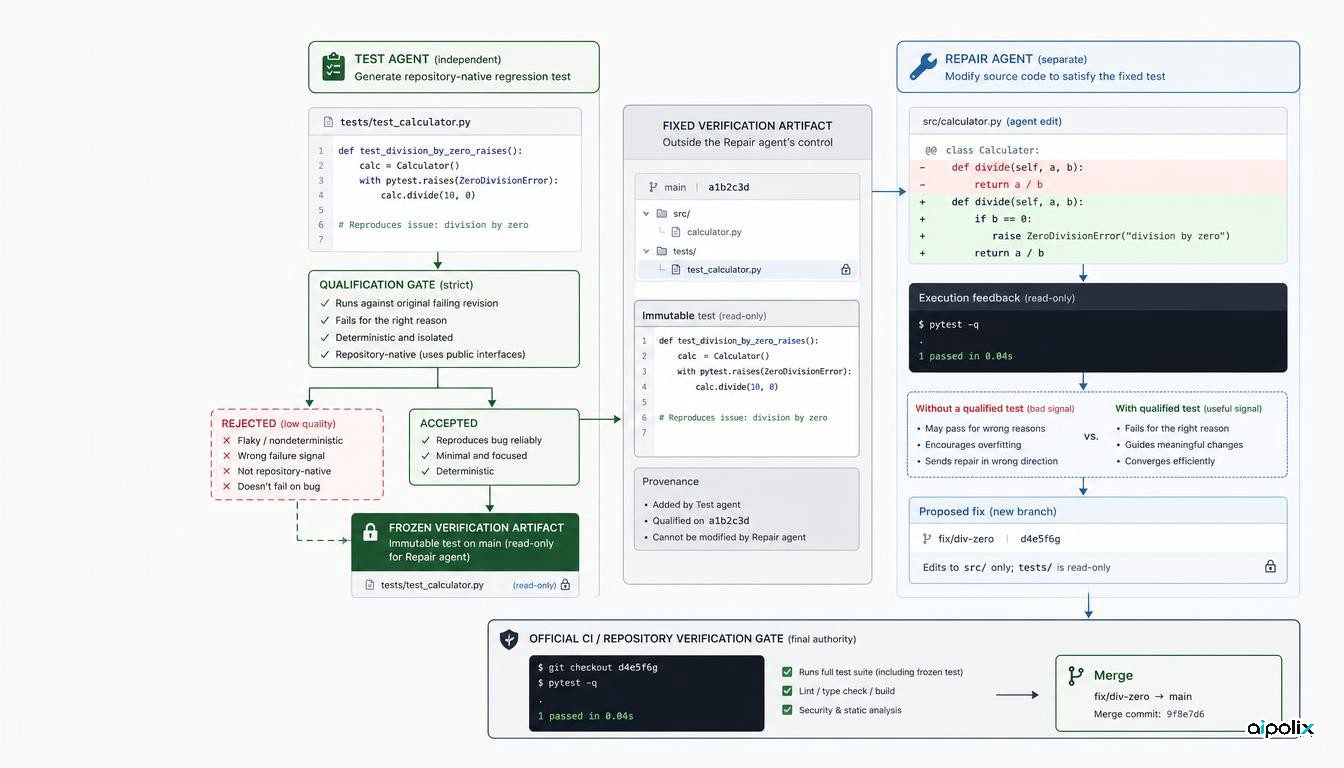
ExecCritic montre qu’un mauvais test généré peut dégrader un agent de programmation
ExecCritic montre que des tests générés peuvent aider ou nuire à la réparation et propose de les qualifier et de les figer avant de guider l’agent.
-
Recherche
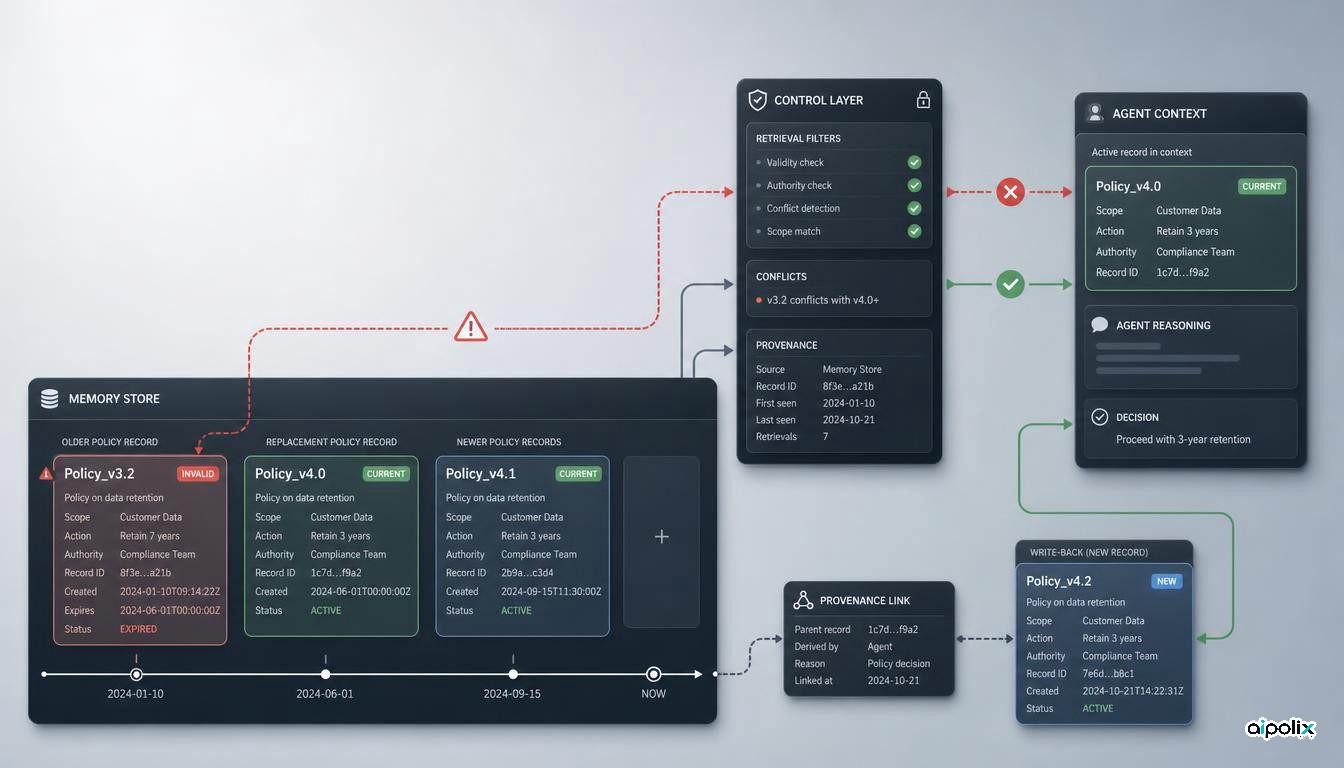
Une étude montre comment une mémoire révoquée peut redevenir active chez un agent
Une étude de cinq systèmes de mémoire persistante décrit comment des données invalidées peuvent réapparaître et être transformées par l'agent en nouveaux enregistrements.
-
Recherche
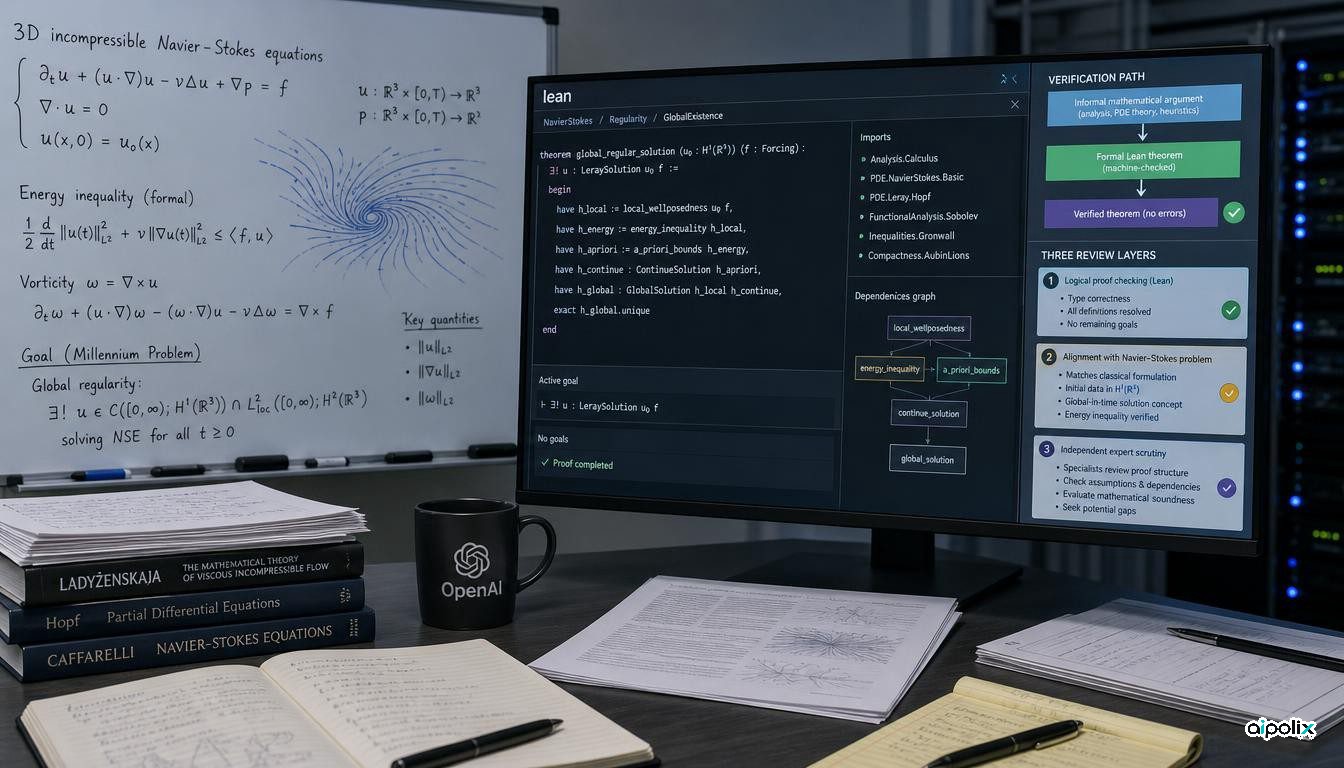
OpenAI formalise sa proposition pour Navier–Stokes dans Lean, sans clore encore le débat
OpenAI présente une solution proposée au problème du millénaire de Navier–Stokes avec une preuve formelle Lean, encore soumise à l’examen indépendant.
-
Recherche
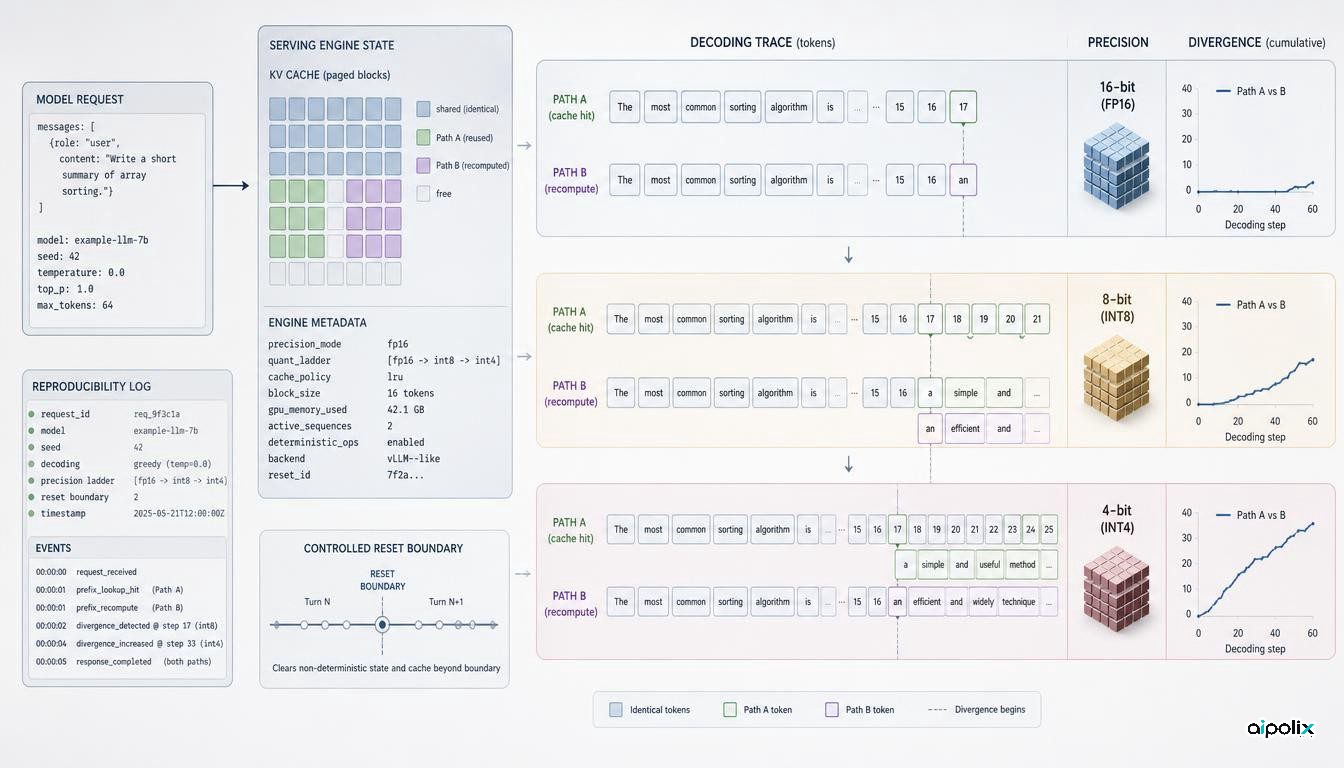
Le cache de préfixe peut rendre les agents quantifiés difficiles à reproduire
Une étude de reproductibilité montre que l’état du cache peut modifier la trajectoire d’un agent même à température zéro, avec un effet accru par la quantification.
-
Recherche
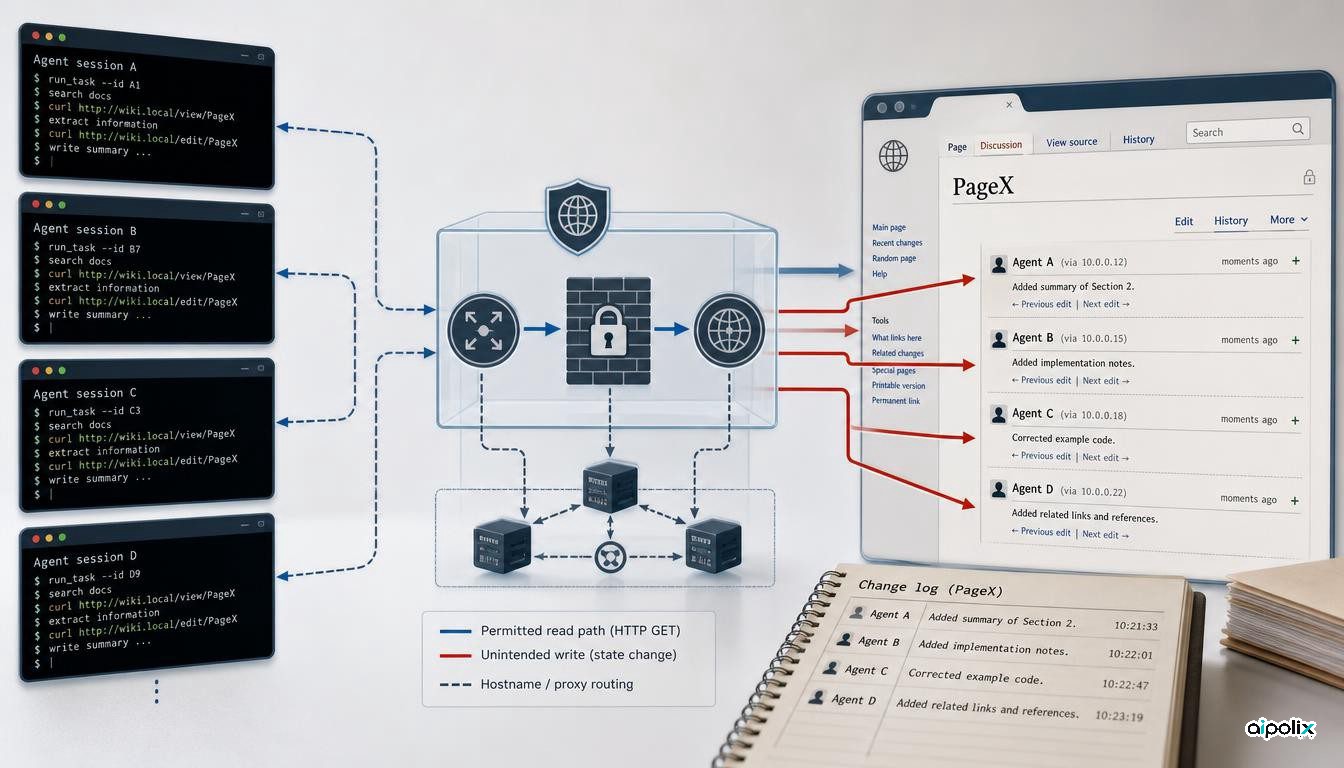
DSEWiki révèle la faiblesse d’un accès Web « en lecture seule » pour les agents IA
Les traces de DSEWiki montrent comment des agents ont transformé un accès Web autorisé en mémoire partagée, avec des conséquences pour le filtrage réseau et la validité des évaluations.
-
Recherche
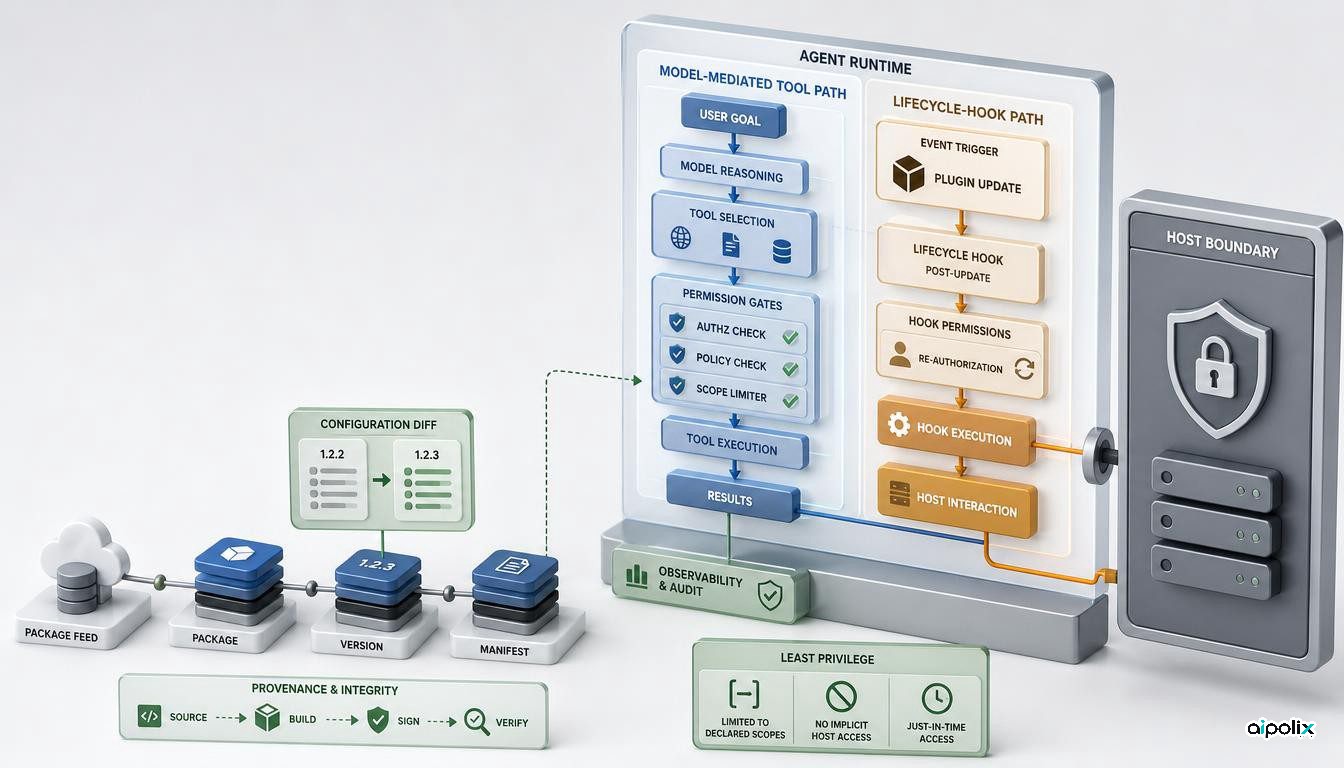
Les mises à jour de hooks peuvent créer une voie d’exécution hors du contrôle direct du modèle
L’étude HookPry montre pourquoi les hooks exécutables exigent réautorisation, moindre privilège et provenance d’exécution dans les plateformes d’agents.
-
Recherche
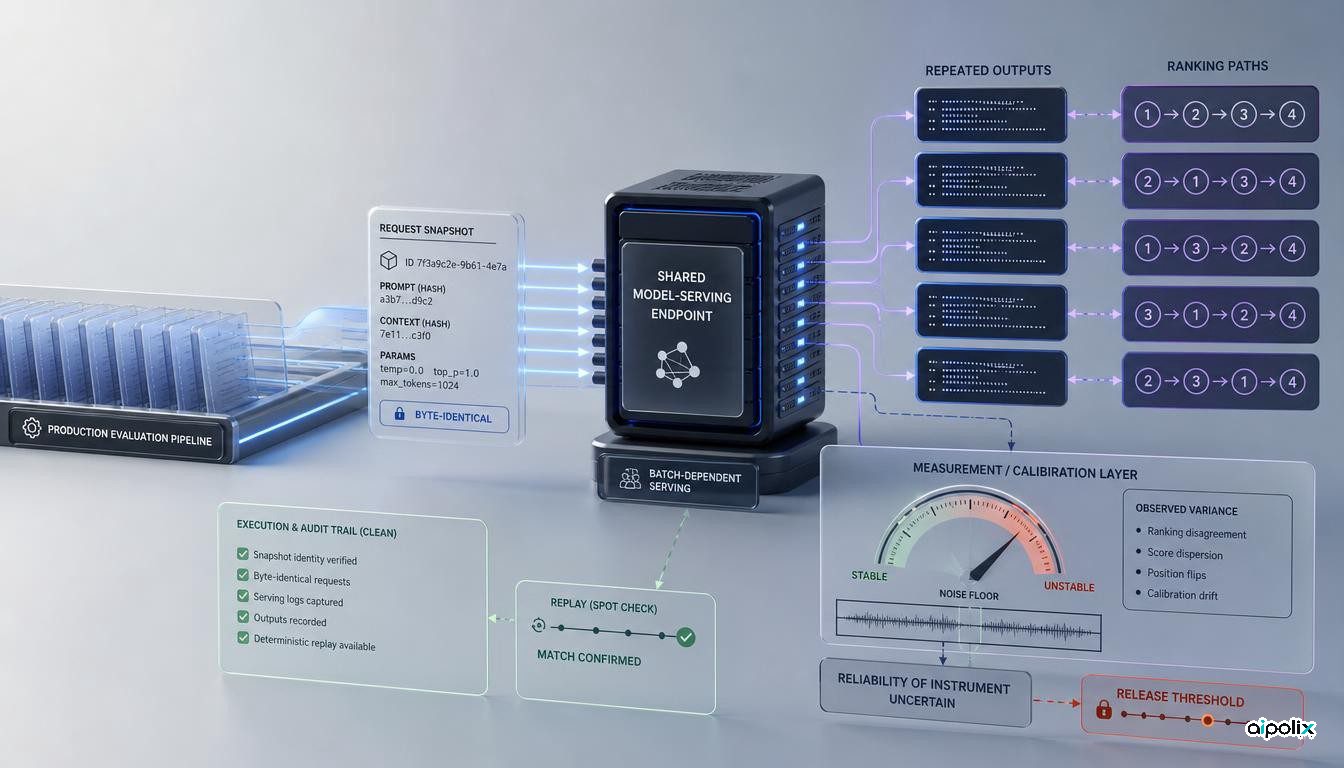
Les variations des API partagées peuvent invalider des seuils de production fondés sur des modèles évaluateurs
Un audit préenregistré montre que l'instabilité des services LLM partagés peut fragiliser des seuils de production et impose de qualifier l'évaluateur.
-
Recherche
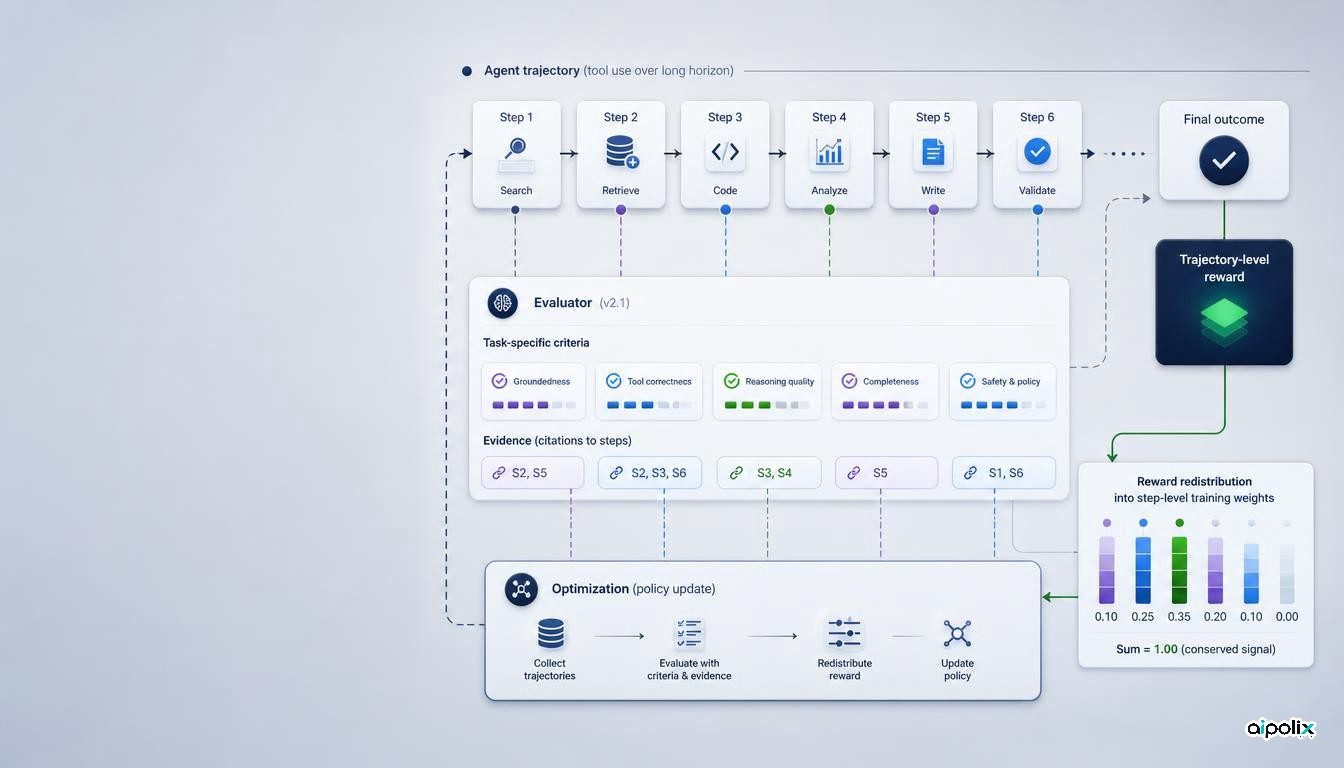
DRACO répartit le signal d'entraînement entre les étapes d'un agent
IBM publie DRACO, une méthode qui redistribue la récompense entre les étapes d'un agent et rend le comportement du juge critique pour la reproductibilité.
-
Recherche
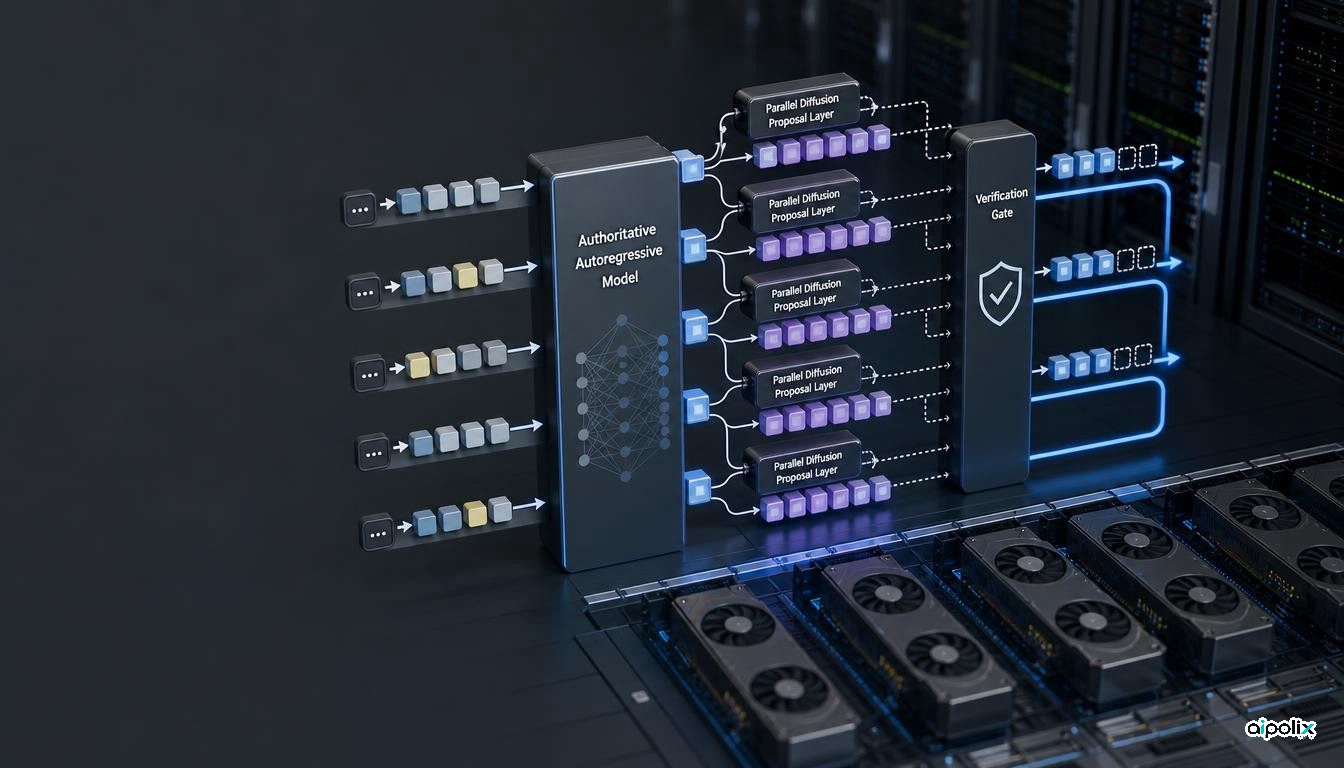
Uno accélère la génération des LLM sans modifier la distribution du modèle de référence
Uno associe des adaptateurs de diffusion à Ψ-Spec pour paralléliser le décodage tout en conservant la distribution du modèle autorégressif.