
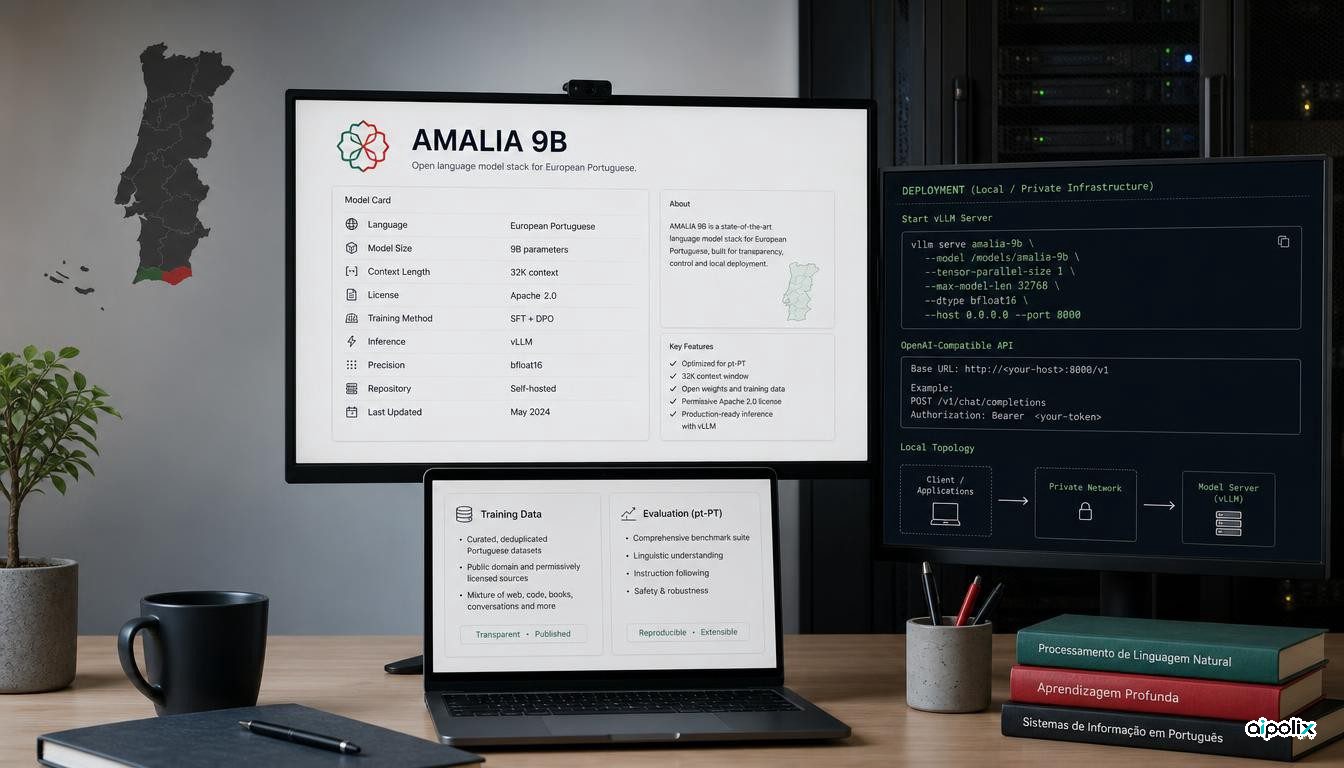
O projecto português AMALIA lançou um modelo de linguagem instalável com 9 mil milhões de parâmetros, concebido especificamente em torno do português europeu, juntamente com os respectivos conjuntos de dados de treino, recursos de avaliação e um percurso público de instalação. A versão final da AMALIA ficou publicamente disponível em 1 July 2026, e o ponto de verificação actual, o 0626 DPO, é distribuído sob Apache 2.0 através da organização do projecto no Hugging Face.
O significado técnico não se reduz a Portugal ter mais um sistema de conversa na língua nacional. A AMALIA prolonga o pré-treino do EuroLLM com mais dados de português europeu, eleva o comprimento máximo de sequência para 32,000 tokens e aplica depois afinação supervisionada e Direct Preference Optimization. O projecto publica também os conjuntos de dados de SFT e DPO e uma suíte de avaliação orientada para pt-PT, o que torna o lançamento mais inspeccionável do que um modelo exposto apenas através de uma interface alojada.
Um modelo 9B afinado para português europeu
Segundo a ficha oficial do modelo AMALIA, o projecto usa dados do Arquivo.pt, dados de pré-treino do EuroLLM, amostras de sequência longa do Stack-v2 e exemplos sintéticos de sequência longa. A fase posterior ao treino combina afinação supervisionada com afinação por preferências através de DPO.
A fase de SFT correu durante 76 hours em 64 GPU NVIDIA H100 e a fase de DPO durante mais 12 hours na mesma quantidade de GPU. O treino usou o supercomputador MareNostrum 5 no Barcelona Supercomputing Center e o sistema DEUCALION no Minho Advanced Computing Center.
Isto interessa aos programadores portugueses porque o modelo é posicionado como base reutilizável, e não apenas como demonstração pública. O projecto publica o ponto de verificação, os dados e as ferramentas de avaliação sob licenças abertas, para que as equipas os possam inspeccionar, reafinar e disponibilizar dentro da própria infra-estrutura.
A avaliação nativa em pt-PT faz parte do lançamento
O relatório técnico da AMALIA sustenta que o português europeu está sub-representado não só nos corpora de treino, mas também na avaliação. Os testes traduzidos automaticamente podem perder vocabulário, gramática e distinções culturais entre o português europeu e o brasileiro.
Para colmatar essa lacuna, o projecto publicou testes pt-PT que combinam tarefas-padrão traduzidas com novos conjuntos de dados centrados na geração em português europeu, na competência linguística e no enviesamento pt-PT versus pt-BR. Os autores relatam que a AMALIA se mantém competitiva com bases fortes nos testes traduzidos, ao mesmo tempo que melhora nas avaliações desenhadas especificamente para o português europeu.
Esses resultados devem ler-se como achados de investigação reportados pelo próprio projecto, não como prova independente de que a AMALIA é em geral superior aos modelos comerciais de ponta. O sinal de engenharia é mais estreito: a equipa criou uma superfície de avaliação explicitamente desenhada para detectar comportamento pt-PT que os testes multilingues genéricos podem ignorar.
Os programadores podem disponibilizá-lo com um ponto de acesso ao estilo da OpenAI
O início rápido no GitHub recomenda o vLLM para disponibilizar o ponto de verificação 0626 DPO. Um comando padrão de vLLM expõe o modelo localmente e torna-o acessível através de uma API de conclusões de conversa compatível com a OpenAI.
Isso facilita integrar a AMALIA em arquitecturas de aplicação já existentes. Uma equipa pode executá-lo como serviço de inferência local ou privado, manter os dados dentro da infra-estrutura que controla, e encaminhar cargas de trabalho portuguesas seleccionadas para a AMALIA sem reconstruir toda a camada de cliente.
A escala de 9B também é operacionalmente relevante. É muito mais pequena do que os modelos de ponta e já atraiu quantizações da comunidade para llama.cpp e Apple Silicon, embora essas construções derivadas sejam artefactos comunitários separados, e não o lançamento oficial.
Portugal trata o modelo como infra-estrutura soberana de IA
O anúncio da Digital.gov.pt descreve a AMALIA como o primeiro grande modelo de linguagem construído especificamente para o português europeu e o enquadramento cultural nacional. O lançamento de julho inclui também um ramo multimodal, mas o conjunto textual já é independentemente útil para programadores, porque os pesos, os conjuntos de dados e o percurso de disponibilização estão disponíveis agora.
O argumento da IA soberana não deve reduzir-se à nacionalidade do modelo. O valor mais concreto é o controlo sobre o conjunto técnico completo: pesos do modelo, divulgação dos dados de treino, recursos de avaliação e escolhas de instalação. Isso pode importar para sistemas do sector público, cargas de trabalho reguladas, produtos específicos da língua e investigação em que a dependência de uma API proprietária remota é indesejável.
A AMALIA não elimina a necessidade de verificação de segurança, avaliação de domínio ou comparação com modelos maiores. A ficha do modelo recomenda explicitamente validação de entradas e filtragem de saídas específicas de cada instalação, e o corte de conhecimento é June 2024. As equipas devem medir as suas próprias tarefas antes de assumir que a especialização nativa em pt-PT supera diferenças de raciocínio geral, uso de ferramentas ou actualidade.
Para os leitores da Aipolix, o lançamento compreende-se melhor como uma nova peça de infra-estrutura portuguesa de IA: não a pretensão de que um modelo 9B substitui os sistemas globais de ponta, mas um modelo aberto e plenamente instalável que dá ao português europeu um caminho nativo mais sólido para inferência local, adaptação e avaliação.