
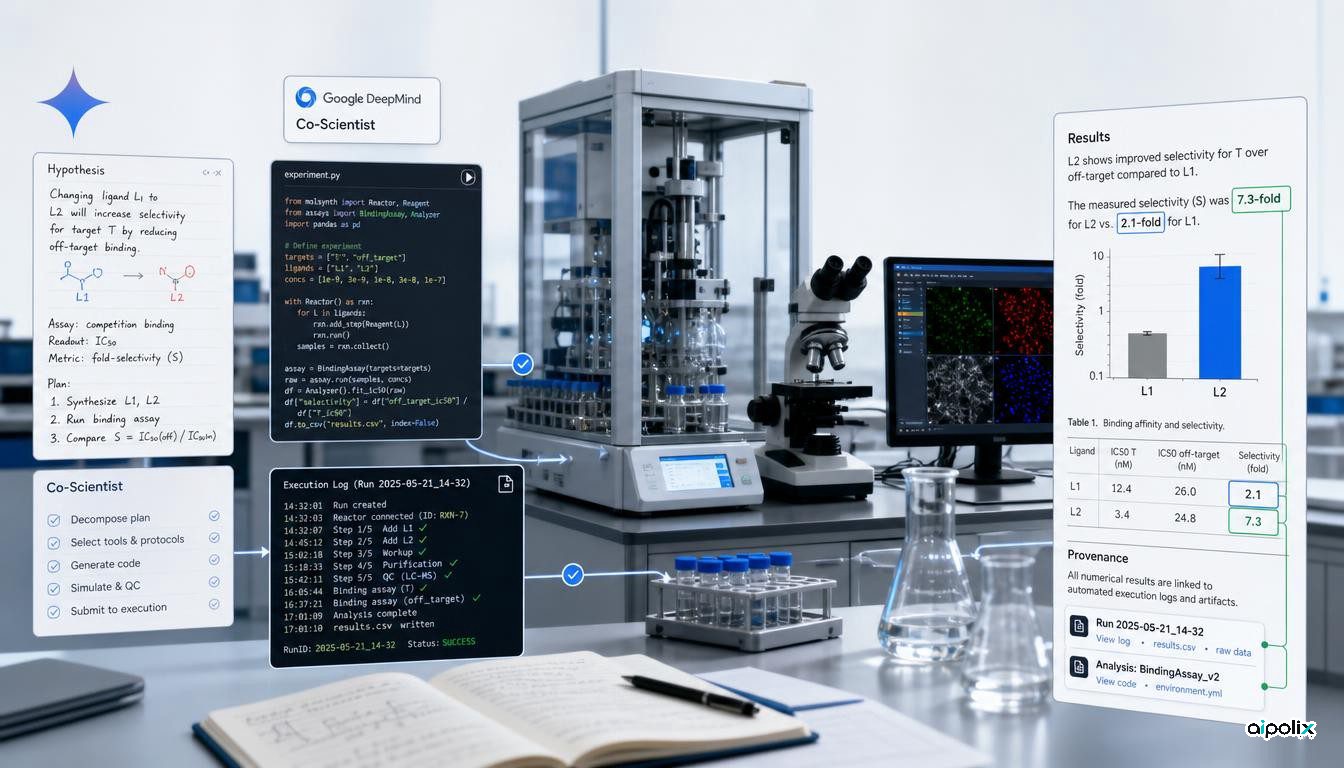
Investigadores da Google DeepMind alargaram o Co-Scientist, até agora centrado na geração e avaliação de hipóteses científicas, para um quadro de investigação fundado na execução, capaz de planear experiências, escrever e correr código, interagir com equipamento laboratorial, analisar resultados e produzir manuscritos. O trabalho novo abrange ciência dos materiais, biologia sintética e informática, com níveis diferentes de intervenção humana em cada domínio.
A mudança decisiva não é a capacidade de um sistema de IA propor mais uma ideia científica. É a ligação explícita, no ciclo de investigação, entre as afirmações geradas e aquilo que foi realmente executado. Isso torna o trabalho relevante não só para a IA ao serviço da ciência, mas também para a arquitetura de agentes, a proveniência e a verificação.
Da geração de hipóteses à investigação fundada na execução
O Co-Scientist original concentrava-se sobretudo na geração de hipóteses e no raciocínio científico. O anúncio Gemini for Science da Google, no início deste ano, posicionava o Co-Scientist como um sistema multiagente que gera, debate e avalia hipóteses.
O novo pré-print no arXiv, submetido a 27 de agosto de 2026, alarga esse ciclo à experimentação. Os autores descrevem um fluxo em três etapas: ideação, experimentação e produção do artigo. Consoante a tarefa, a etapa experimental pode produzir código, procedimentos laboratoriais legíveis por máquina ou outros artefactos executáveis, e depois usar as observações resultantes como prova para a análise posterior.
Isto não significa que o Co-Scientist seja um cientista de laboratório plenamente autónomo. A autonomia varia substancialmente entre experiências. No trabalho de materiais, pessoas ainda carregam amostras e precursores, conduzem partes do processo físico e realizam a caracterização. Na informática, em contraste, uma experiência avança de forma autónoma depois de definido o objetivo inicial de investigação.
Essa distinção é central para interpretar os resultados.
Trabalho real de laboratório, com humanos ainda no circuito
Em ciência dos materiais, o sistema foi ligado a um fluxo semiautomatizado de deposição química em fase de vapor. Propôs uma via de precursor mais segura para a síntese ascendente de MXene e ajudou a orientar refinamentos experimentais repetidos.
Os investigadores relatam a produção de um material lamelar bidimensional com semelhanças estruturais à rede Ti3C2Tx MXene. Afirmam, porém, explicitamente que são necessárias mais experiências para confirmar a estrutura atómica. O resultado é interessante, mas não constitui uma descoberta confirmada do material-alvo.
A equipa também usou o Gemini 3 Deep Think para adaptar receitas de crescimento de semicondutores às restrições de uma instalação laboratorial específica. Segundo o artigo, isso permitiu o crescimento, numa só tentativa, de monocamadas de MoS2, MoSe2 e WS2. O carregamento dos precursores continuou humano, pelo que o fluxo combinou controlo gerado por máquina com intervenção física humana, em vez de substituir por completo o operador de laboratório.
Em biologia sintética, o Co-Scientist construiu um canal de previsão baseado em imagens para colónias de E. coli modificadas em diferentes concentrações de IPTG. As previsões coincidiram com medições laboratoriais não publicadas em três das quatro dimensões morfológicas relatadas. Os autores notam ainda que a experiência se aproxima mais de uma interpolação num regime conhecido do que da previsão de um sistema biológico inteiramente novo.
O Agent_H expõe os limites da otimização de critérios automáticos
A experiência de informática é especialmente útil porque mostra tanto o que a procura autónoma pode alcançar como o ponto em que a avaliação automatizada pode enganar.
Dado um objetivo de investigação e um ambiente de desenvolvimento restrito, o Co-Scientist concebeu uma arquitetura em tempo de inferência chamada Agent_H para resposta a perguntas médicas. O sistema resultante usa várias etapas de triagem, decomposição, geração paralela de alternativas, seleção, crítica, verificação e otimização da resposta.
No HealthBench Hard e no HealthBench Professional, o artigo relata que o Agent_H superou seis linhas de base de modelos de fronteira depois de os autores corrigirem efeitos de comprimento da resposta.
Mas a avaliação cega por médicos produziu um resultado bem mais cauteloso. Três médicos certificados compararam o Agent_H com o Gemini 3.1 Pro em nove dimensões clínicas. O Agent_H mostrou uma vantagem estatisticamente significativa em apenas uma dimensão: menor potencial de dano clínico.
O desvio importa. Um sistema pode otimizar um critério automatizado sem produzir uma melhoria igualmente grande no juízo de especialistas humanos. O artigo fornece, assim, o seu próprio exemplo de por que a avaliação de agentes não se reduz ao desempenho numa tabela de classificação.
A camada de fiabilidade pode ser a ideia mais reutilizável do artigo
O contributo arquitetónico mais forte é a tentativa de ligar as afirmações do manuscrito a provas de execução.
Os agentes de investigação autónomos têm um modo de falha óbvio: um sistema recompensado por produzir resultados bem-sucedidos pode gerar afirmações plausíveis sobre experiências que não ocorreram. O Co-Scientist acrescenta módulos de fiabilidade que penalizam a fabricação e o quase-plágio, enquanto um verificador separado confronta afirmações numéricas com os registos de execução e os artefactos experimentais gerados.
Num estudo duplamente cego, 30 especialistas de domínio produziram 450 avaliações cobrindo 150 artigos gerados de forma autónoma. Os autores relatam que resultados-chave fabricados surgiram em 4% dos artigos com os módulos de fiabilidade ativos, face a 46% quando esses módulos foram removidos e 90% na linha de comparação. Dados completamente fabricados foram reportados em 0% na configuração protegida do Co-Scientist, contra 44% no sistema de comparação. O conteúdo quase plagiado caiu de 60% para 16%.
São diferenças grandes, mas continuam a ser resultados do próprio desenho de avaliação dos autores e ainda não foram reproduzidos de forma independente. O artigo é também um pré-print novo no arXiv, e não uma publicação desta extensão específica sujeita a revisão por pares independente.
Os autores identificam ainda problemas residuais. Os manuscritos gerados podem relatar seletivamente resultados favoráveis, e descrições plausíveis de métodos podem divergir do código que foi realmente executado. Por outras palavras, a verificação reduz substancialmente o problema, mas não elimina a necessidade de rastreabilidade e de revisão humana.
A segurança é tratada como parte do ciclo de investigação
O sistema acrescenta também controlos de segurança para direções de investigação potencialmente nocivas. Os autores relatam que uma arquitetura de segurança integrada rejeitou 98.7% das direções inseguras na sua avaliação.
Esse número deve ser lido como um resultado reportado pelos autores num dispositivo de teste definido, não como uma garantia geral de segurança laboratorial. O sinal arquitetónico mais importante é que a barreira de segurança é colocada antes da execução, e não apenas como moderação do manuscrito final.
Para agentes científicos que podem escrever código ou controlar equipamento, essa colocação torna-se cada vez mais importante. A fronteira de risco é a ação em si, não apenas o texto que a descreve.
Por que isto importa para além da IA ao serviço da ciência
A lição mais ampla é relevante para sistemas de agentes fora da investigação.
O Co-Scientist caminha para um padrão em que as afirmações finais de um agente não são confiáveis simplesmente porque o modelo gerou uma explicação convincente. As afirmações são confrontadas com rasto de execução, artefactos experimentais e resultados observados.
É o mesmo princípio de conceção de que os agentes de produção precisam cada vez mais em engenharia de software, operações, finanças e fluxos regulamentados: separar geração de prova, preservar a proveniência e tornar os resultados importantes rastreáveis até ações que realmente ocorreram.
O artigo não demonstra um cientista plenamente autónomo, e vários resultados de destaque permanecem preliminares ou altamente específicos da tarefa. O que demonstra é uma arquitetura de agentes mais madura, em que raciocínio científico, execução e verificação se juntam num único ciclo de retroação.
Essa mudança pode revelar-se mais importante do que qualquer experiência isolada relatada no artigo.