Recherche
-
Recherche
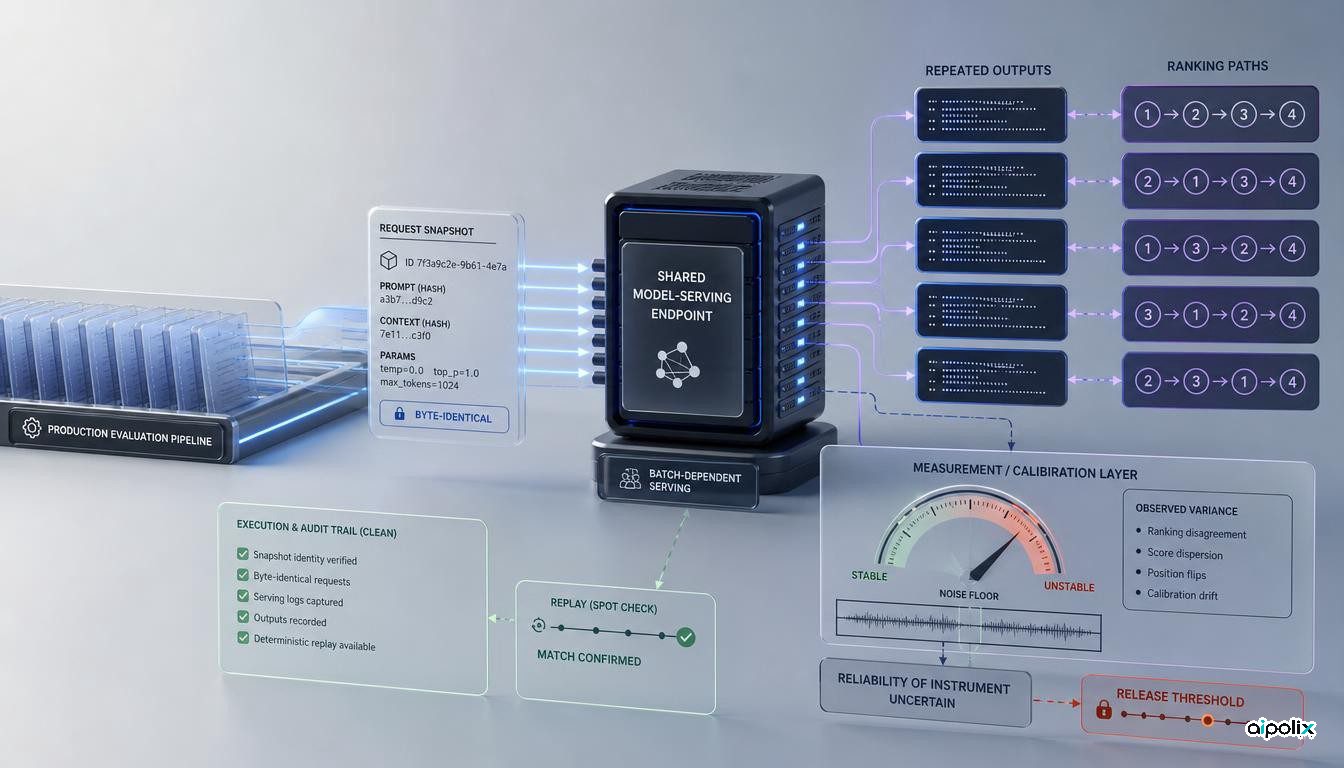
Les variations des API partagées peuvent invalider des seuils de production fondés sur des modèles évaluateurs
Un audit préenregistré montre que l'instabilité des services LLM partagés peut fragiliser des seuils de production et impose de qualifier l'évaluateur.
-
Recherche
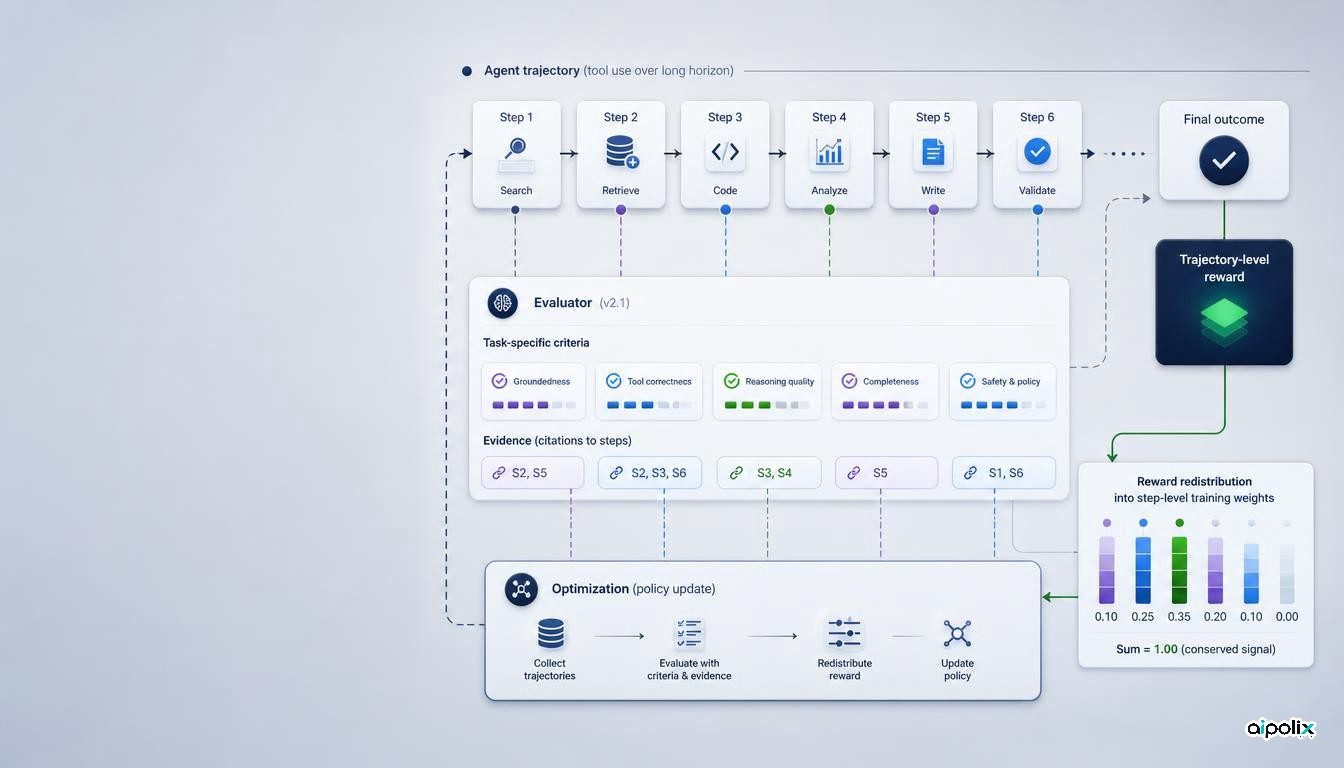
DRACO répartit le signal d'entraînement entre les étapes d'un agent
IBM publie DRACO, une méthode qui redistribue la récompense entre les étapes d'un agent et rend le comportement du juge critique pour la reproductibilité.
-
Recherche
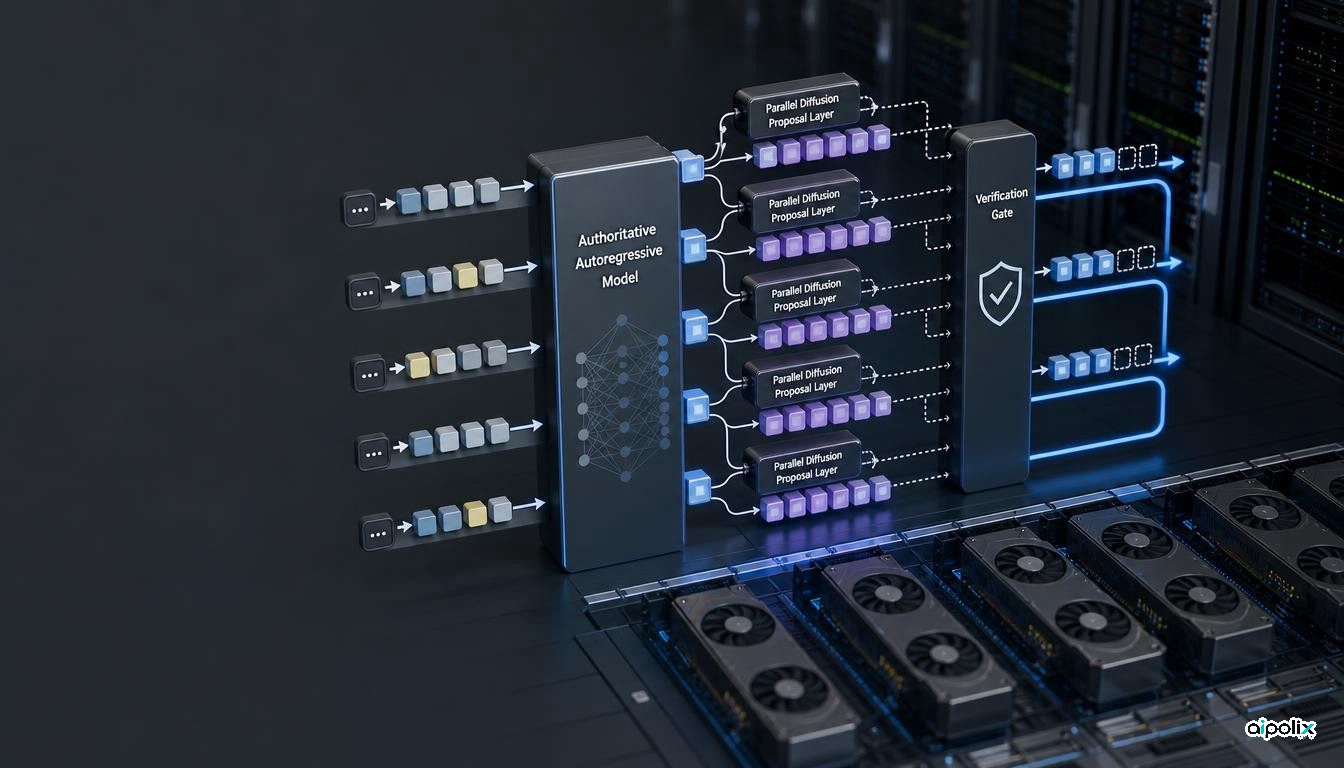
Uno accélère la génération des LLM sans modifier la distribution du modèle de référence
Uno associe des adaptateurs de diffusion à Ψ-Spec pour paralléliser le décodage tout en conservant la distribution du modèle autorégressif.
-
Recherche
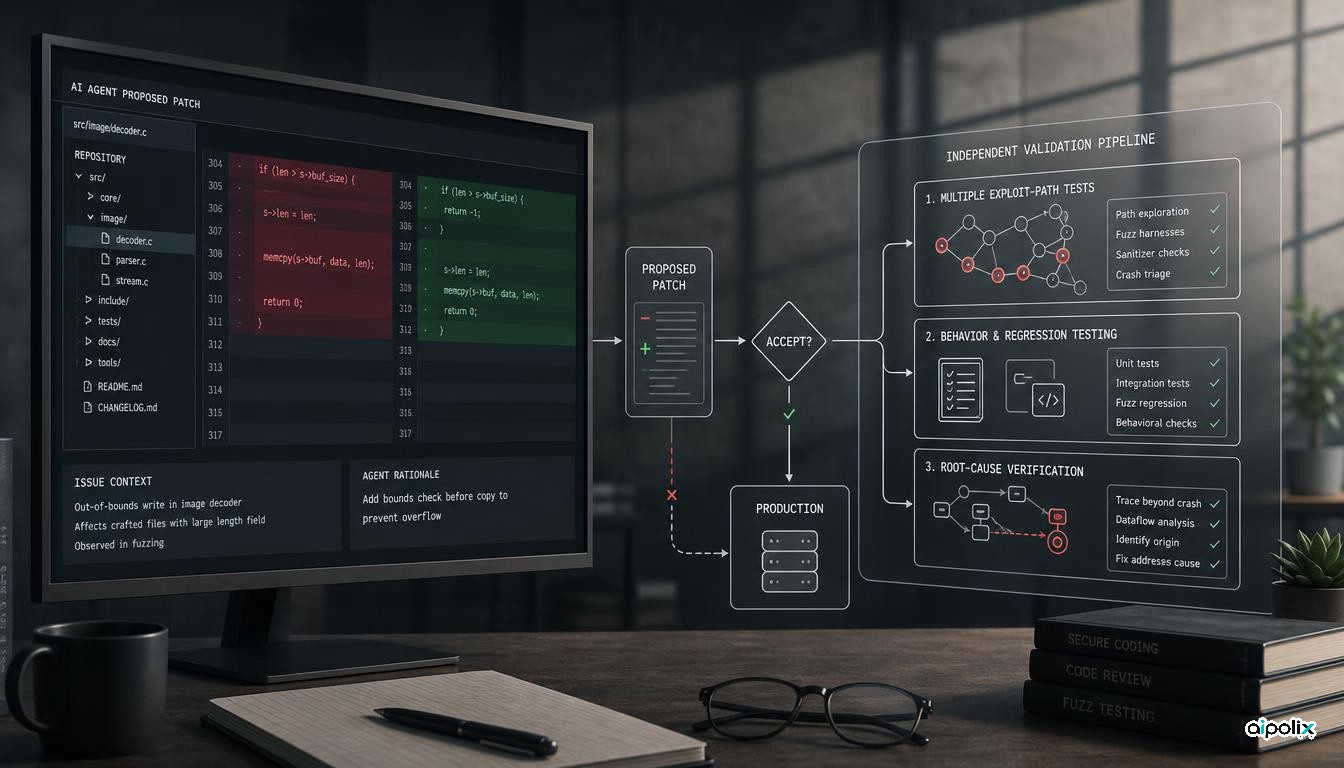
PatchBench révèle l'écart entre un crash évité et une faille réellement corrigée
PatchBench montre qu'un test limité à une preuve de concept peut surestimer les correctifs produits par des agents d'IA et plaide pour une validation indépendante.
-
Recherche
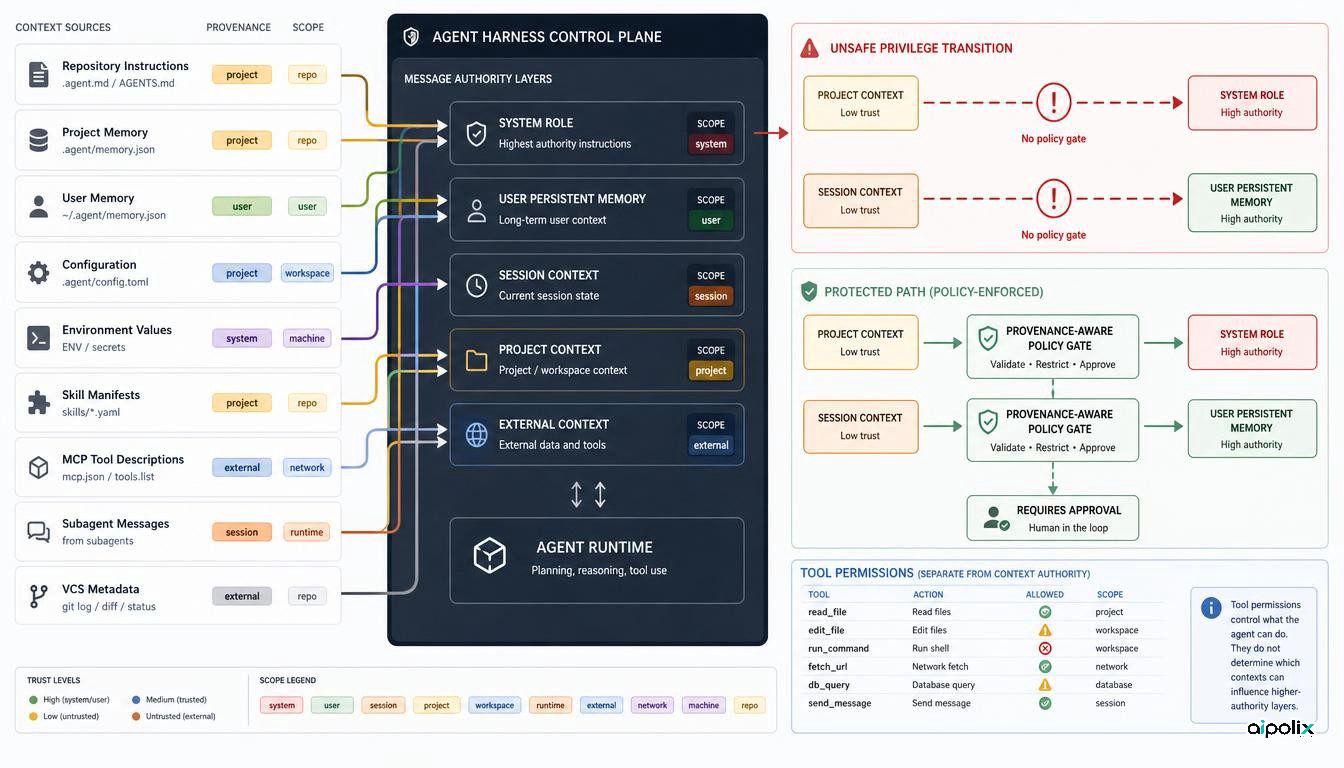
L’élévation de privilège du contexte révèle une nouvelle frontière de sécurité des agents
Une étude sur 12 environnements d’agents montre comment le contexte peut gagner de l’autorité et pourquoi la provenance doit être contrôlée à l’exécution.
-
Recherche
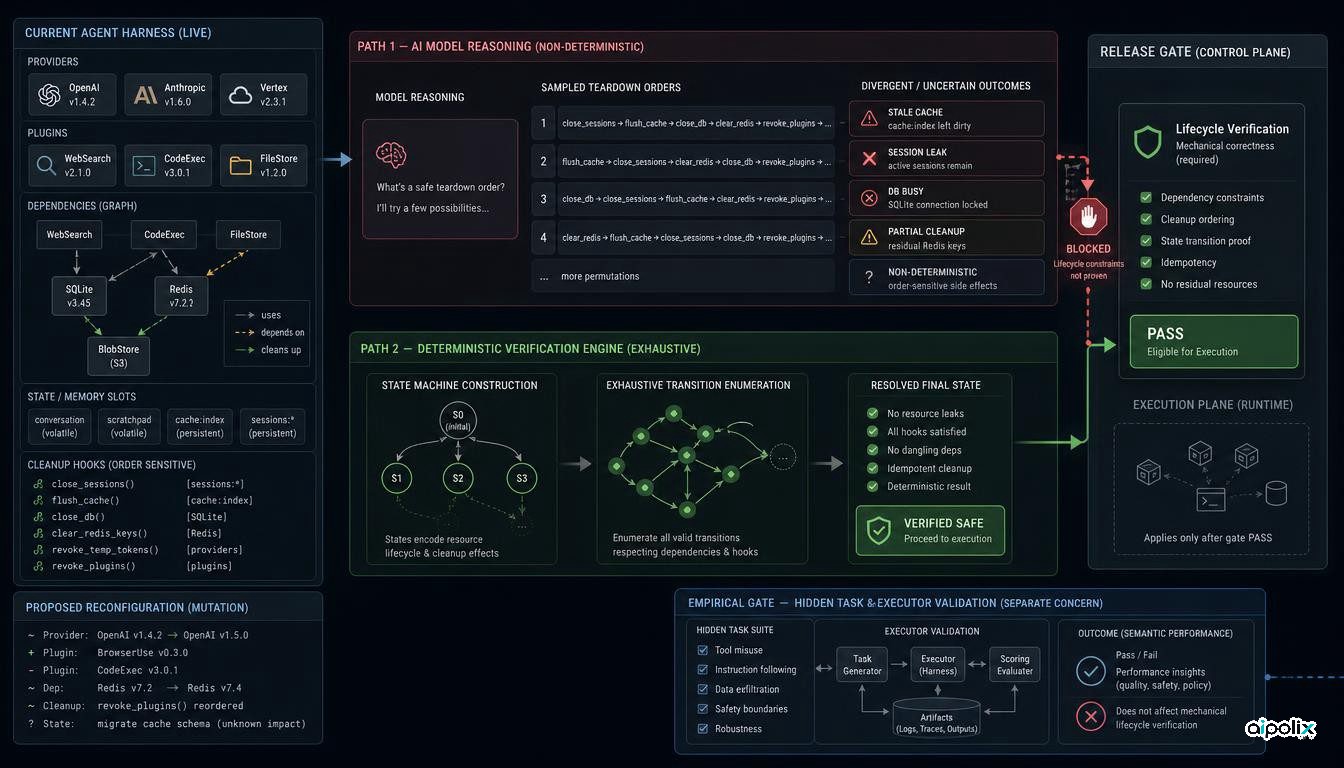
CordisBench montre où la vérification doit remplacer le raisonnement des agents
CordisBench montre que le raisonnement sur le cycle de vie se dégrade avec la complexité alors que les conséquences testées peuvent être calculées exactement.
-
Recherche
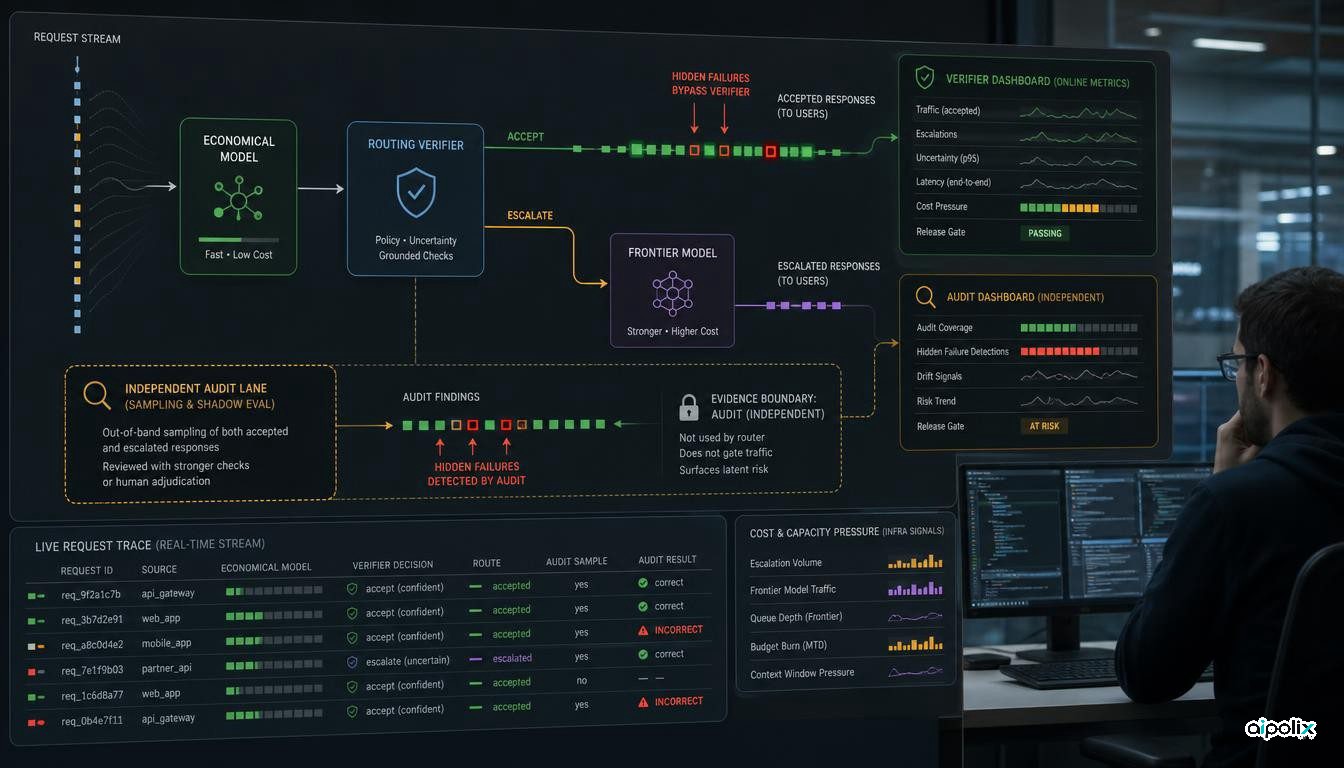
Des vérificateurs bon marché peuvent masquer les erreurs des cascades d’IA
Une étude montre pourquoi le routage et la mesure de qualité d’une cascade de modèles ne devraient pas dépendre du même vérificateur.
-
Recherche
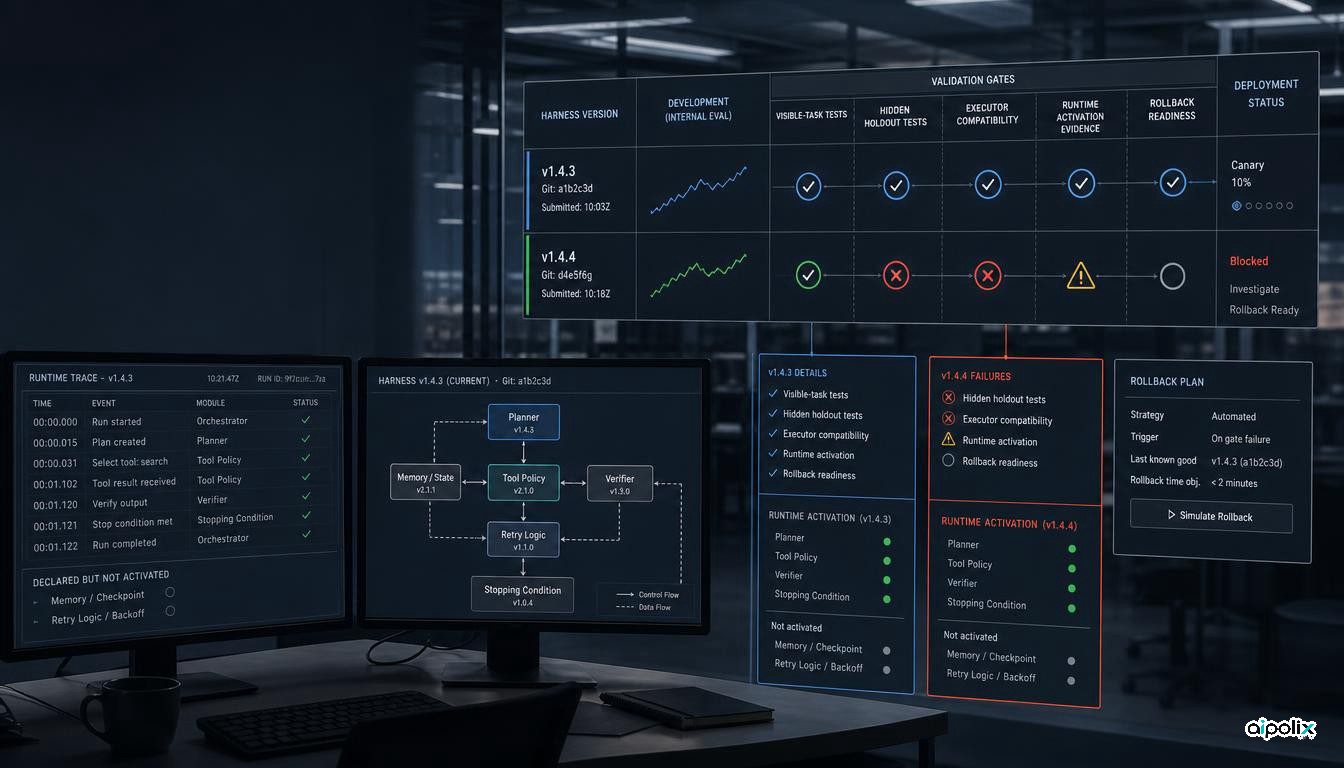
HarnessDev montre pourquoi les agents auto-améliorants ont besoin de garde-fous de livraison
HarnessDev montre pourquoi les harnais d’agents évolutifs exigent validation cachée, tests d’exécuteur, preuves d’exécution et retour arrière.
-
Nouveaux modèles
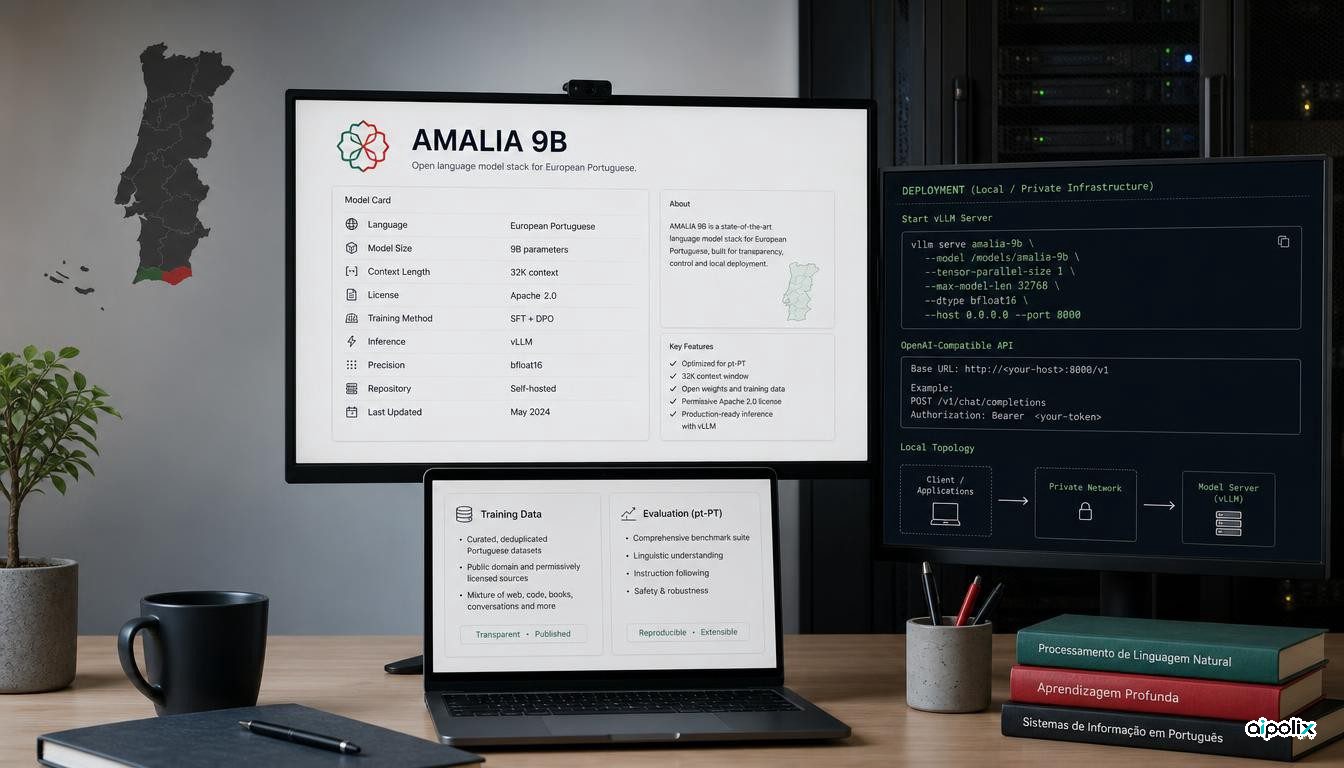
AMALIA publie un modèle de portugais européen à 9 milliards de paramètres, fenêtre 32K et voie locale
Le projet AMALIA publie un modèle ouvert de portugais européen de 9 milliards de paramètres, avec fenêtre 32K, entraînement SFT et DPO, ressources d’évaluation publiques et mise à disposition locale via vLLM.
-
Recherche
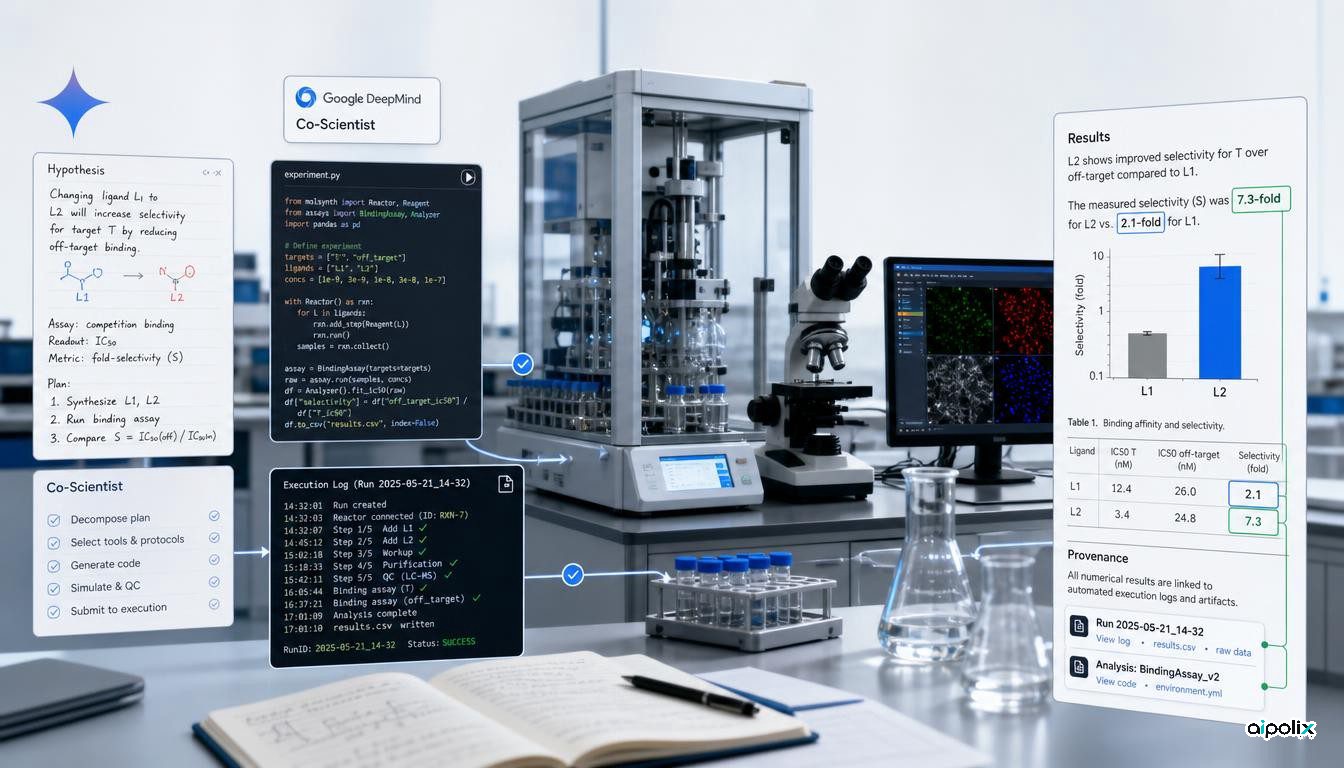
Gemini Co-Scientist referme la boucle de l’hypothèse à l’expérience et aux affirmations vérifiées
Google DeepMind étend Co-Scientist de la génération d’hypothèses à une recherche fondée sur l’exécution : planification d’expériences, code autonome, matériel de laboratoire et vérification des affirmations.