
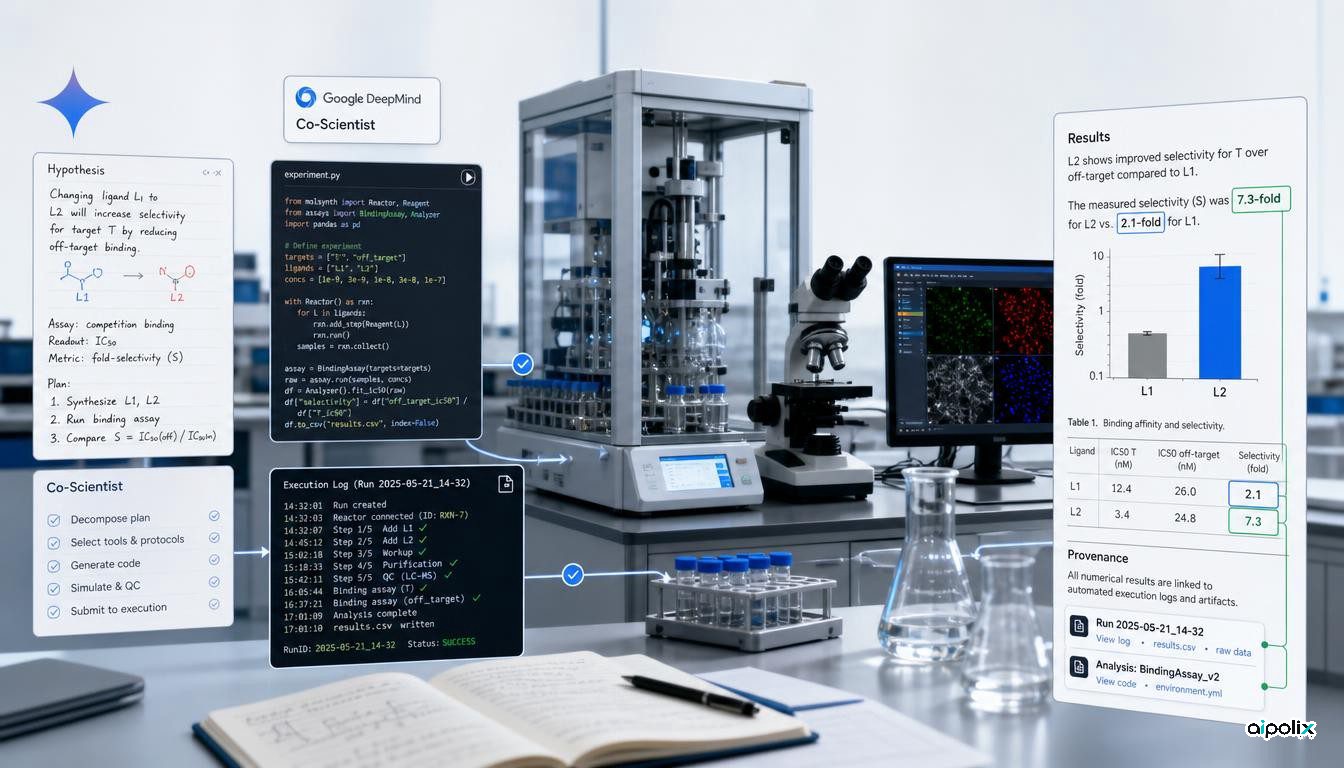
پژوهشگران Google DeepMind، سامانهٔ Co-Scientist را از ابزاری که عمدتاً فرضیههای علمی را تولید و ارزیابی میکرد به چارچوبی برای پژوهش مبتنی بر اجرا گسترش دادهاند؛ چارچوبی که میتواند آزمایش را برنامهریزی کند، کد بنویسد و اجرا کند، با تجهیزات آزمایشگاهی تعامل داشته باشد، نتایج را تحلیل کند و پیشنویس مقاله تولید کند. کار تازه علم مواد، زیستشناسی مصنوعی و علوم رایانه را پوشش میدهد و میزان دخالت انسان در هر حوزه متفاوت است.
تغییر اصلی این نیست که یک سامانهٔ هوش مصنوعی بتواند ایدهٔ علمی دیگری پیشنهاد کند. تغییر این است که حلقهٔ پژوهش اکنون پیوندی صریح میان ادعاهای تولیدشده و آنچه واقعاً اجرا شده برقرار میکند. همین، کار را علاوه بر «هوش مصنوعی برای علم»، به معماری عامل، تبار داده و راستیآزمایی نیز مرتبط میکند.
از تولید فرضیه تا پژوهش مبتنی بر اجرا
کار اولیهٔ Co-Scientist عمدتاً بر تولید فرضیه و استدلال علمی متمرکز بود. اعلامیهٔ Gemini for Science گوگل در اوایل امسال، Co-Scientist را سامانهای چندعاملی معرفی کرد که فرضیهها را تولید، به بحث میگذارد و ارزیابی میکند.
پیشچاپ تازه در arXiv، که در 27 اوت 2026 ارسال شده، این حلقه را به آزمایشگری میکشاند. نویسندگان جریان سهمرحلهای ایدهپردازی، آزمایش و تولید مقاله را توصیف میکنند. بسته به وظیفه، مرحلهٔ آزمایش میتواند کد، رویههای آزمایشگاهی خوانا برای ماشین یا دیگر مصنوعات اجرایی تولید کند و سپس مشاهدات حاصل را بهعنوان شاهد برای تحلیل بعدی بهکار گیرد.
این بهمعنای دانشمند آزمایشگاهی کاملاً خودمختار بودن Co-Scientist نیست. خودمختاری در آزمایشها بهطور چشمگیری فرق میکند. در کار مواد، انسانها هنوز نمونهها و پیشمادهها را بارگذاری میکنند، بخشی از کار فیزیکی را پیش میبرند و مشخصهیابی را انجام میدهند. در علوم رایانه، در مقابل، یک آزمایش پس از تعیین هدف اولیهٔ پژوهش بهصورت خودمختار پیش میرود.
همین تمایز برای تفسیر نتایج محوری است. خودمختاری یک ویژگی واحد سامانه نیست؛ در هر حوزه سطح دخالت انسان فرق میکند و نتایج را باید در همان حد خواند.
کار واقعی آزمایشگاه، با انسان در حلقه
در علم مواد، سامانه به جریان نیمهخودکار رسوبدهی شیمیایی از بخار متصل شد. مسیر پیشمادهای ایمنتری برای سنتز پایینبهبالای MXene پیشنهاد کرد و به پالایش مکرر آزمایش کمک کرد.
پژوهشگران تولید مادهای لایهای دوبعدی با شباهت ساختاری به شبکهٔ Ti3C2Tx MXene را گزارش میکنند. با این حال صریحاً میگویند برای تأیید ساختار اتمی آزمایشهای بیشتری لازم است. نتیجه جالب است، اما کشف تأییدشدهٔ مادهٔ هدف نیست.
تیم همچنین از Gemini 3 Deep Think برای تطبیق دستورهای رشد نیمهرسانا با محدودیتهای یک آرایش آزمایشگاهی مشخص استفاده کرد. طبق مقاله، این کار رشد تکلایهٔ MoS2، MoSe2 و WS2 را در یک تلاش ممکن کرد. بارگذاری پیشماده همچنان انسانی بود؛ بنابراین جریان، کنترل تولیدشدهٔ ماشین را با مداخلهٔ فیزیکی انسان ترکیب کرد، نه اینکه اپراتور آزمایشگاه را بهکلی جایگزین کند.
در زیستشناسی مصنوعی، Co-Scientist یک خط لولهٔ پیشبینی مبتنی بر تصویر برای کلونیهای E. coli مهندسیشده در غلظتهای مختلف IPTG ساخت. پیشبینیها در سه مورد از چهار بُعد ریختشناختی گزارششده با اندازهگیریهای منتشرنشدهٔ آزمایشگاهی تطابق داشت. نویسندگان همچنین یادآور میشوند که آزمایش به درونیابی در رژیمی شناختهشده نزدیکتر است تا پیشبینی یک سامانهٔ زیستی کاملاً تازه.
Agent_H محدودیت بهینهسازی معیارها را نشان میدهد
آزمایش علوم رایانه از آن رو مفید است که هم توان جستوجوی خودمختار را نشان میدهد و هم جایی را که ارزیابی خودکار میتواند گمراهکننده باشد.
با یک هدف پژوهشی و محیط توسعهٔ محدود، Co-Scientist معماری زمان استنتاجی بهنام Agent_H برای پاسخ به پرسشهای پزشکی طراحی کرد. سامانهٔ حاصل مراحل متعددی برای غربال، تجزیه، تولید موازی نامزدها، انتخاب، نقد، راستیآزمایی و بهینهسازی پاسخ دارد.
مقاله گزارش میدهد که در HealthBench Hard و HealthBench Professional، پس از تصحیح اثر طول پاسخ، Agent_H از شش خطپایهٔ مدل مرزی بهتر عمل کرد.
اما ارزیابی کور پزشکان نتیجهٔ بسیار محتاطانهتری داد. سه پزشک دارای گواهی بورد، Agent_H را با Gemini 3.1 Pro در نه بُعد بالینی مقایسه کردند. Agent_H فقط در یک بُعد برتری معنادار آماری نشان داد: احتمال کمتر آسیب بالینی.
این فاصله اهمیت دارد. یک سامانه میتواند معیاری خودکار را بهینه کند بدون آنکه بهبودی به همان اندازه در قضاوت متخصص انسانی ایجاد کند. مقاله بنابراین خودش نمونهای بهدست میدهد از اینکه چرا ارزیابی عامل را نمیتوان به عملکرد جدول ردهبندی فروکاست.
لایهٔ قابلیت اعتماد شاید بازاستفادهپذیرترین ایدهٔ مقاله باشد
قویترین سهم معماری، تلاش برای وصلکردن ادعاهای پیشنویس مقاله به شواهد اجراست.
عاملهای پژوهش خودمختار یک شکست آشکار دارند: سامانهای که برای تولید نتیجهٔ موفق پاداش میگیرد میتواند ادعاهایی باورپذیر دربارهٔ آزمایشهایی بسازد که واقعاً رخ ندادهاند. Co-Scientist ماژولهای قابلیت اعتمادی میافزاید که جعل و سرقت ادبی نزدیک را جریمه میکنند، در حالی که راستیآزماگر جداگانهای ادعاهای عددی را با دفتر ثبت اجرا و مصنوعات آزمایشی تولیدشده مقابله میکند.
در مطالعهای دوسوکور، 30 متخصص حوزهای 450 بازبینی از 150 مقالهٔ تولیدشدهٔ خودمختار تهیه کردند. نویسندگان گزارش میدهند که نتایج کلیدی جعلی در 4% مقالات با ماژولهای قابلیت اعتماد فعال دیده شد، در برابر 46% وقتی آن ماژولها حذف شدند و 90% برای خطپایهٔ مقایسه. دادهٔ کاملاً جعلی در پیکربندی حفاظتشدهٔ Co-Scientist 0% و در سامانهٔ مقایسه 44% گزارش شد. محتوای نزدیک به سرقت ادبی از 60% به 16% رسید.
این تفاوتها بزرگاند، اما همچنان نتایج آرایش ارزیابی خود نویسندگاناند و هنوز بهطور مستقل تکرار نشدهاند. مقاله همچنین پیشچاپ تازهٔ arXiv است، نه انتشار داوریشدهٔ مستقل همین گسترش مشخص.
نویسندگان هنوز مسائل باقیمانده را شناسایی میکنند. پیشنویسهای تولیدشده میتوانند نتایج مطلوب را گزینشی گزارش کنند و توصیفهای روش باورپذیر میتوانند از کدی که واقعاً اجرا شده فاصله بگیرند. بهعبارت دیگر، راستیآزمایی مسئله را بهطور چشمگیری کاهش میدهد اما نیاز به قابلیت ردیابی و بازبینی انسانی را از بین نمیبرد.
ایمنی بخشی از حلقهٔ پژوهش تلقی میشود
سامانه همچنین کنترلهای ایمنی برای مسیرهای پژوهشی بالقوه زیانبار میافزاید. نویسندگان گزارش میکنند که معماری ایمنی یکپارچه در ارزیابیشان 98.7% مسیرهای ناامن را رد کرد.
این عدد باید بهعنوان نتیجهٔ گزارششدهٔ نویسندگان در آرایش آزمونی تعریفشده تفسیر شود، نه تضمینی عمومی برای ایمنی آزمایشگاه. پیام معماری مهمتر این است که دروازهٔ ایمنی پیش از اجرا قرار میگیرد، نه فقط بهعنوان پالایش پیشنویس نهایی. برای عاملی که میتواند تجهیزات را به حرکت درآورد، کنترل متن پس از واقعه دیر است.
برای عاملهای علمی که میتوانند کد بنویسند یا تجهیزات را کنترل کنند، همین جایگذاری اهمیت فزاینده پیدا میکند. مرز ریسک خودِ کنش است، نه فقط متنی که آن را توصیف میکند.
چرا این موضوع فراتر از هوش مصنوعی برای علم اهمیت دارد
درس وسیعتر به سامانههای عامل بیرون از پژوهش نیز مربوط است.
Co-Scientist به الگویی نزدیک میشود که در آن ادعاهای نهایی عامل فقط بهایندلیل که مدل توضیحی قانعکننده تولید کرده پذیرفته نمیشوند. ادعاها در برابر ردپای اجرا، مصنوعات آزمایشی و نتایج مشاهدهشده بررسی میشوند.
همین اصل طراحی را عاملهای تولیدی بیشازپیش در مهندسی نرمافزار، عملیات، مالیه و جریانهای قانونگذاریشده نیاز دارند: تولید را از شواهد جدا کنید، تبار را حفظ کنید و خروجیهای مهم را به کنشهایی قابلردیابی سازید که واقعاً رخ دادهاند.
مقاله دانشمند کاملاً خودمختار را نشان نمیدهد و چند نتیجهٔ برجسته مقدماتی یا بسیار وابسته به وظیفه باقی میمانند. آنچه نشان میدهد معماری پختهتری از عامل است که در آن استدلال علمی، اجرا و راستیآزمایی در یک حلقهٔ بازخورد به هم میپیوندند.
این جابهجایی در معماری عامل ممکن است از هر آزمایش منفرد گزارششده در مقاله مهمتر باشد؛ خود نویسندگان نیز چند نتیجه را مقدماتی میدانند.