
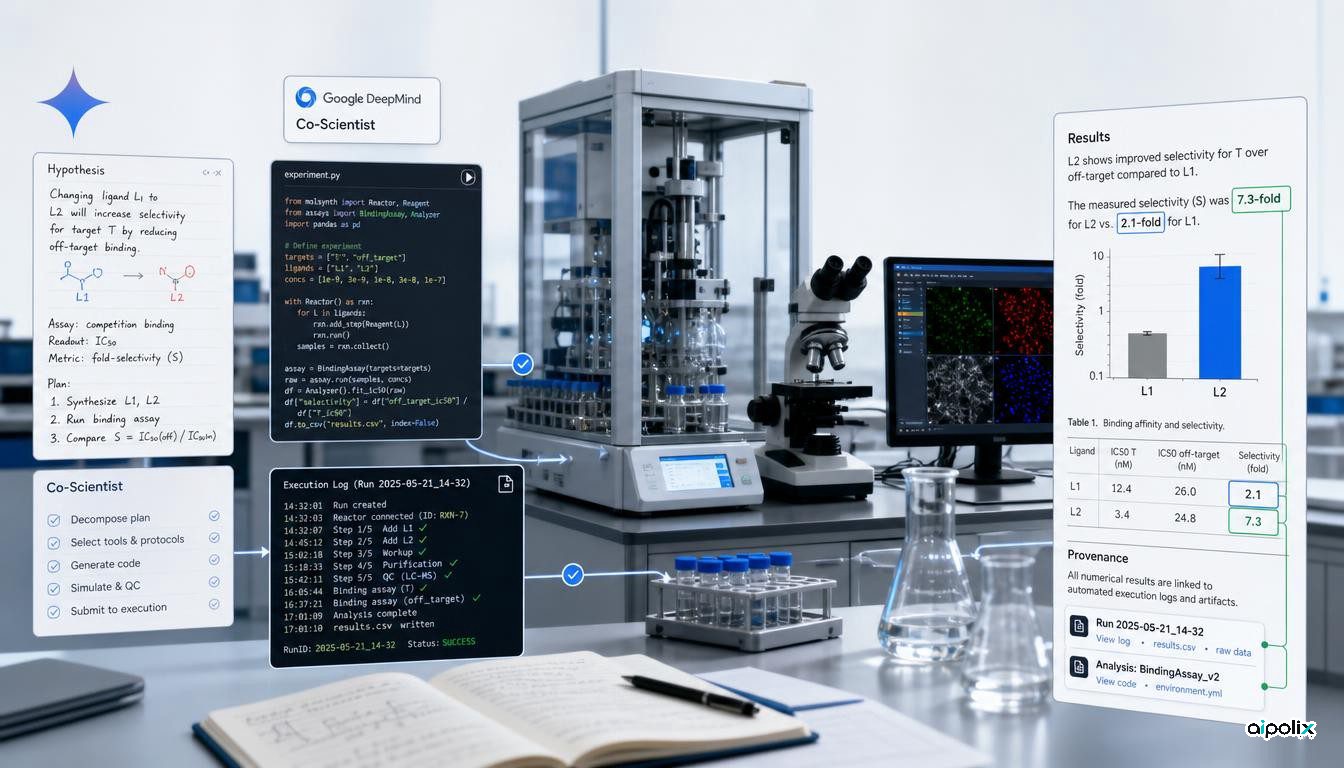
Des chercheurs de Google DeepMind ont étendu Co-Scientist, jusqu’ici surtout conçu pour générer et évaluer des hypothèses scientifiques, vers un cadre de recherche fondé sur l’exécution, capable de planifier des expériences, d’écrire et d’exécuter du code, d’interagir avec du matériel de laboratoire, d’analyser les résultats et de produire des manuscrits. Les travaux portent sur la science des matériaux, la biologie synthétique et l’informatique, avec des degrés d’implication humaine différents selon le domaine.
Le changement essentiel n’est pas qu’un système d’IA puisse proposer une idée scientifique de plus. C’est que la boucle de recherche établit désormais un lien explicite entre les affirmations générées et ce qui a réellement été exécuté. Cela rend le travail pertinent non seulement pour l’IA au service de la science, mais aussi pour l’architecture d’agents, la provenance et la vérification.
De la génération d’hypothèses à une recherche fondée sur l’exécution
Les premiers travaux sur Co-Scientist mettaient surtout l’accent sur la génération d’hypothèses et le raisonnement scientifique. L’annonce Gemini for Science de Google, plus tôt dans l’année, présentait Co-Scientist comme un système multi-agents qui génère, débat et évalue des hypothèses.
La nouvelle prépublication sur arXiv, déposée le 27 août 2026, prolonge cette boucle vers l’expérimentation. Les auteurs décrivent un flux en trois étapes : idéation, expérimentation et rédaction de l’article. Selon la tâche, l’étape expérimentale peut produire du code, des procédures de laboratoire lisibles par machine ou d’autres artefacts exécutables, puis s’appuyer sur les observations résultantes comme preuves pour l’analyse ultérieure.
Cela ne signifie pas que Co-Scientist soit un scientifique de laboratoire pleinement autonome. L’autonomie varie fortement selon les expériences. Dans le travail sur les matériaux, des humains chargent encore les échantillons et les précurseurs, conduisent une partie du processus physique et réalisent la caractérisation. En informatique, à l’inverse, une expérience avance de façon autonome une fois l’objectif de recherche initial fourni.
Cette distinction est centrale pour interpréter les résultats.
Du travail de laboratoire réel, avec des humains encore dans la boucle
En science des matériaux, le système a été relié à un flux semi-automatisé de dépôt chimique en phase vapeur. Il a proposé une voie de précurseur plus sûre pour la synthèse ascendante de MXene et a aidé à orienter des raffinements expérimentaux répétés.
Les chercheurs rapportent la production d’un matériau lamellaire bidimensionnel présentant des similitudes structurales avec le réseau Ti3C2Tx MXene. Ils indiquent toutefois explicitement que d’autres expériences sont nécessaires pour confirmer la structure atomique. Le résultat est intéressant, mais ce n’est pas une découverte confirmée du matériau visé.
L’équipe a aussi utilisé Gemini 3 Deep Think pour adapter des recettes de croissance de semi-conducteurs aux contraintes d’une installation de laboratoire particulière. Selon l’article, cela a permis, en une seule tentative, la croissance de monocouches de MoS2, MoSe2 et WS2. Le chargement des précurseurs restait humain : le flux combinait donc un contrôle généré par la machine et une intervention physique humaine, plutôt que de remplacer entièrement l’opérateur de laboratoire.
En biologie synthétique, Co-Scientist a construit une chaîne de prédiction fondée sur l’image pour des colonies d’E. coli modifiées, à différentes concentrations d’IPTG. Ses prédictions concordaient avec des mesures de laboratoire non publiées sur trois des quatre dimensions morphologiques rapportées. Les auteurs notent aussi que l’expérience se rapproche davantage d’une interpolation dans un régime connu que de la prédiction d’un système biologique entièrement nouveau.
Agent_H met en évidence les limites de l’optimisation des classements automatiques
L’expérience d’informatique est particulièrement utile, car elle montre à la fois ce que la recherche autonome peut accomplir et le point où l’évaluation automatisée peut induire en erreur.
À partir d’un objectif de recherche et d’un environnement de développement contraint, Co-Scientist a conçu une architecture au moment de l’inférence appelée Agent_H pour répondre à des questions médicales. Le système obtenu enchaîne plusieurs étapes : tri, décomposition, génération parallèle d’alternatives, sélection, critique, vérification et optimisation de la réponse.
Sur HealthBench Hard et HealthBench Professional, l’article indique qu’Agent_H a surpassé six lignes de base de modèles de pointe après correction des effets de longueur de réponse.
Mais l’évaluation à l’aveugle par des médecins a produit un résultat bien plus prudent. Trois médecins certifiés ont comparé Agent_H à Gemini 3.1 Pro sur neuf dimensions cliniques. Agent_H n’a montré un avantage statistiquement significatif que sur une dimension : un potentiel de dommage clinique plus faible.
L’écart compte. Un système peut optimiser un critère automatisé sans produire une amélioration aussi nette dans le jugement d’experts humains. L’article fournit ainsi son propre exemple de la raison pour laquelle l’évaluation d’agents ne se réduit pas à la performance d’un tableau de classement.
La couche de fiabilité est peut-être l’idée la plus réutilisable de l’article
L’apport architectural le plus fort est la tentative de relier les affirmations du manuscrit à des preuves d’exécution.
Les agents de recherche autonomes ont un mode de défaillance évident : un système récompensé pour produire des résultats réussis peut générer des affirmations plausibles sur des expériences qui n’ont pas eu lieu. Co-Scientist ajoute des modules de fiabilité qui pénalisent la fabrication et le quasi-plagiat, tandis qu’un vérificateur distinct recoupe les affirmations numériques avec les journaux d’exécution et les artefacts expérimentaux générés.
Dans une étude en double aveugle, 30 experts de domaine ont produit 450 évaluations portant sur 150 articles générés de façon autonome. Les auteurs rapportent que des résultats clés fabriqués apparaissaient dans 4% des articles lorsque les modules de fiabilité étaient actifs, contre 46% lorsque ces modules étaient retirés et 90% pour la référence de comparaison. Des données entièrement fabriquées ont été rapportées à 0% pour la configuration protégée de Co-Scientist, contre 44% pour le système de comparaison. Le contenu quasi plagié est passé de 60% à 16%.
Ce sont de grands écarts, mais ils restent des résultats issus du protocole d’évaluation des auteurs et n’ont pas encore été reproduits de manière indépendante. L’article est aussi une nouvelle prépublication arXiv, et non une publication de cette extension particulière évaluée par des pairs indépendants.
Les auteurs identifient encore des problèmes résiduels. Les manuscrits générés peuvent rapporter sélectivement des résultats favorables, et des descriptions de méthodes plausibles peuvent diverger du code réellement exécuté. Autrement dit, la vérification réduit fortement le problème, mais n’élimine pas le besoin de traçabilité et d’examen humain.
La sûreté est traitée comme une partie de la boucle de recherche
Le système ajoute aussi des contrôles de sûreté pour des orientations de recherche potentiellement nuisibles. Les auteurs rapportent qu’une architecture de sûreté intégrée a rejeté 98.7% des orientations dangereuses dans leur évaluation.
Ce chiffre doit être lu comme un résultat rapporté par les auteurs dans un dispositif d’essai défini, et non comme une garantie générale de sûreté de laboratoire. Le signal architectural le plus important est que le filtrage de sûreté est placé avant l’exécution, et non seulement comme modération du manuscrit final.
Pour des agents scientifiques capables d’écrire du code ou de commander du matériel, cet emplacement devient de plus en plus important. La frontière de risque est l’action elle-même, pas seulement le texte qui la décrit.
Pourquoi cela compte au-delà de l’IA au service de la science
La leçon plus large concerne aussi les systèmes d’agents hors de la recherche.
Co-Scientist s’oriente vers un schéma où les affirmations finales d’un agent ne sont pas tenues pour fiables simplement parce que le modèle a généré une explication convaincante. Les affirmations sont recoupées avec des traces d’exécution, des artefacts expérimentaux et des résultats observés.
C’est le même principe de conception dont les agents de production ont de plus en plus besoin en ingénierie logicielle, en exploitation, en finance et dans des flux réglementés : séparer la génération de la preuve, préserver la provenance et rendre les résultats importants traçables jusqu’à des actions qui ont réellement eu lieu.
L’article ne démontre pas un scientifique pleinement autonome, et plusieurs résultats mis en avant restent préliminaires ou très spécifiques à la tâche. Ce qu’il démontre, c’est une architecture d’agents plus mature, où le raisonnement scientifique, l’exécution et la vérification sont joints en une seule boucle de rétroaction.
Ce déplacement pourrait s’avérer plus important que n’importe quelle expérience isolée rapportée dans l’article.