
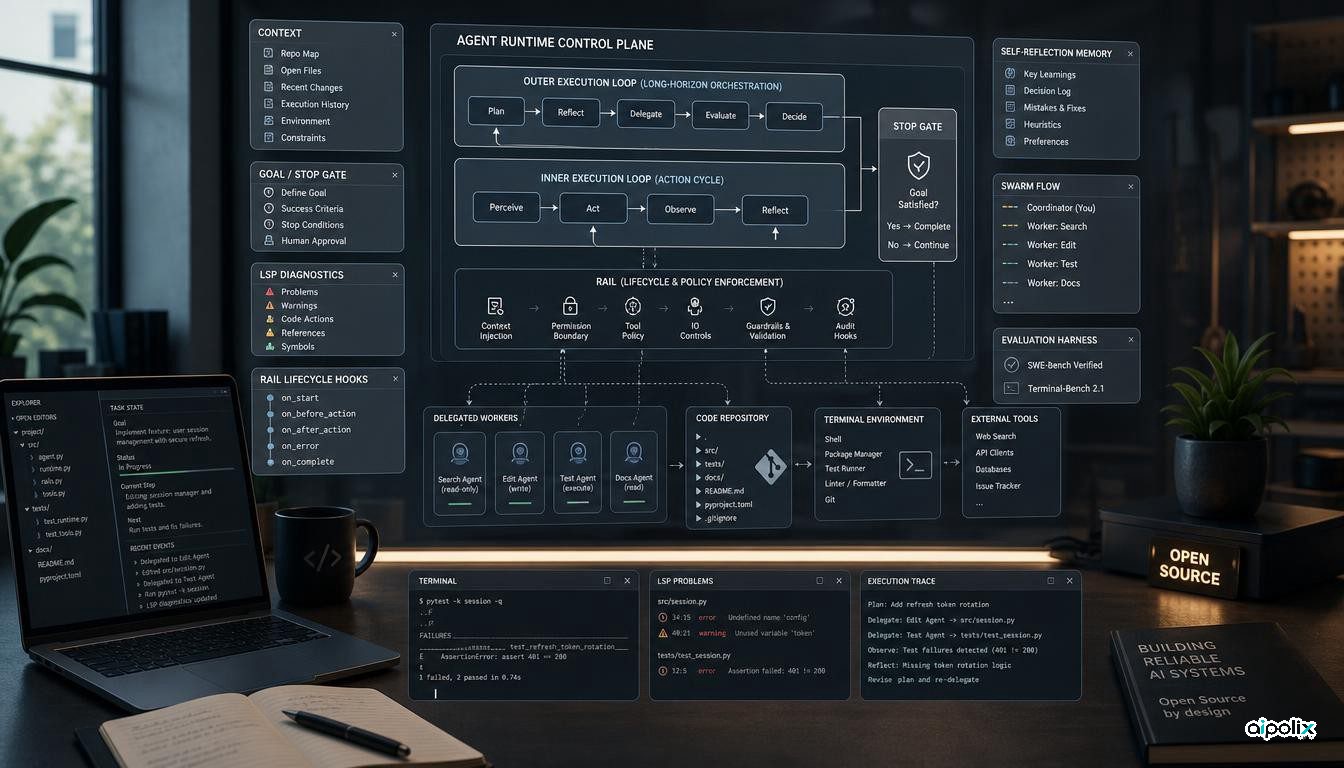
openJiuwen مقالهٔ پژوهشی تازهای منتشر کرده که مهار عامل کدنویسی را بهجای پوششی نازک دور یک مدل، بهعنوان لایهٔ سامانهای درجهٔ اول میبیند. کار از آن جهت اهمیت دارد که عملکرد کدنویسی افقبلند بیش از پیش به این بستگی دارد که مهار چگونه بافت، ابزارها، ادامهٔ وظیفه، تشخیص، واگذاری و توقف را مدیریت میکند، نه فقط به این که کدام مدل زیر آن نشسته است. مقاله یک بستر اجرای مشترک برای عامل تکی، زیرعاملهای واگذارشده و جریانهای چندعاملی توصیف میکند، در حالی که مخزن عمومی JiuwenSwarm مسیر پیادهسازی قابلبازرسی فراهم میکند.
نویسندگان 82.6% روی SWE-bench Verified و 87.19% روی Terminal-Bench 2.1 گزارش میکنند. این ارقام چشمگیرند، اما پرسش مهندسی مفیدتر این است که واقعاً چه چیزی را تثبیت میکنند. خود مقاله هشدار میدهد که سامانههای جدول ردهبندی در مدل، دستور، ابزار و پیادهسازی فرق دارند. این قید مرکزی است: قویترین برداشت عملی این نیست که یک مهار قطعاً دیگری را شکست داده، بلکه این است که هماهنگی به بخش قابلاندازهگیری سامانهٔ عامل تبدیل شده و به ارزیابی کنترلشدهٔ خودش نیاز دارد.
مهار به صفحهٔ کنترل تبدیل میشود
openJiuwen اجرا را به حلقهٔ درونی برای تعامل مدل و ابزار و حلقهٔ بیرونی برای ادامه در سطح وظیفه جدا میکند. قابلیتهای عرضی از طریق سازوکاری به نام Rail متصل میشوند که از قلابهای چرخهٔ حیات و ترتیب صریح استفاده میکند، نه از نشاندن هر قابلیت در یک مسیر اجرای جداگانه. همان معنای اجرایی در عاملهای مستقل، زیرعاملهای واگذارشده و Swarm Flow بازاستفاده میشود.
این طراحی مسئلهٔ واقعی مهندسی را هدف میگیرد. عاملهای کدنویسی اکنون برنامهریزی، حافظه، مدیریت بافت، بررسیهای امنیتی، دخالت انسانی، تلاش مجدد و واگذاری را انباشته میکنند. اگر هر قابلیت تازه حلقهٔ اصلی اجرا را عوض کند، استدلال دربارهٔ مهار و آزمودنش دشوارتر میشود. یک بستر مشترک میتواند ترکیب این رفتارها را آسانتر کند، اما پیکربندی مهار را نیز به سطح کنترلی بدل میکند که سزاوار نسخهبندی، مشاهدهپذیری و آزمون پسرفت است.
مخزن نشان میدهد پروژه فقط یک مقالهٔ مفهومی نیست. JiuwenSwarm همکاری چندعاملی، گردشکارهای قطعی Swarmflow، مجوزهای ابزار، اجرای توزیعشده و سازوکار Auto Harness را در معرض میگذارد که هدفش بهینهسازی مهار بدون تغییر وزنهای مدل است. مخزن با مجوز Apache-2.0 و قابل نصب است، که بازتولید را نسبت به مقالهای که فقط نتایج معیار گزارش میکند بهبود میدهد.
سازگاری زمان اجرا وضعیت چارچوب را عوض میکند، نه وزنهای مدل را
ایدهٔ دوم مقاله سازگاری زمان اجرا است. بهجای آموزش مجدد مدل، openJiuwen وضعیت تحت کنترل چارچوب را همزمان با پیشروی وظیفه تغییر میدهد. مدیریت بافت اطلاعات قدیمیتر را فشرده، کاهش یا برونسپاری میکند؛ Goal Mode پذیرش و توقف را کنترل میکند؛ بازخورد مبتنی بر LSP تشخیص معنایی تزریق میکند؛ خودبازتاب تجربهٔ قابلاستفاده را از مسیرهای تکمیلشده ذخیره میکند.
این تمایز برای تیمهایی که عامل را روی مدلهای شخص ثالث میسازند اهمیت دارد. نشان میدهد برخی بهبودهای افقبلند میتواند از صفحهٔ کنترل پیرامون یک مدل ثابت بیاید، که از نظر عملیاتی سریعتر از تنظیم دقیق قابل تکرار است. سطح شکست جداگانهای نیز میسازد. مدیر بافت میتواند شواهد نادرست را پنهان کند، قاعدهٔ توقف میتواند خیلی زود خاتمه دهد، و حلقهٔ تشخیص میتواند به سیگنالهای ایستایی بیشواکنش نشان دهد که درستی معماری یا کسبوکار را ثبت نمیکنند.
برای ارزیابی تولیدی، بنابراین مهار نباید زیرساخت نامرئی تلقی شود. تیمها به آزمونهایی برای حفظ بافت، شرایط توقف، مجوزهای ابزار، رفتار تلاش مجدد و تزریق تشخیص نیاز دارند، افزون بر آزمودن خود مدل.
شکاف تیترگونهٔ معیار به حسابرسی ادعا نیاز دارد
مقاله گزارش میکند که openJiuwen با GPT-5.6 Sol به 87.19% روی Terminal-Bench 2.1 میرسد، در مقایسه با نتیجهٔ منتخب جدول ردهبندی Claude Code برابر 83.8%. اگر تنها خوانده شود، شبیه برتری 3.39 واحد درصدی مهار به نظر میرسد. برآورد کنترلشدهٔ اثر مهار نیست، چون دو سامانه از مدلهای ستون فقرات متفاوت استفاده میکنند و میتوانند در دستور، ابزار و پیادهسازی نیز فرق داشته باشند.
مقاله مقایسهٔ آگاهیدهندهتری با مدل همتراز با استفاده از Fable 5 دارد. در آن تنظیم، openJiuwen 84.04% گزارش میکند در حالی که Claude Code 83.8% گزارش میکند؛ اختلاف فقط 0.24 واحد درصد. نویسندگان صریحاً میگویند همتراز کردن مدل یکی از عوامل مخدوش را کم میکند اما تفاوت در دستور، ابزار یا پیادهسازی عامل را از بین نمیبرد.
SWE-bench Verified تا حدی تمیزتر است چون openJiuwen و قویترین مقایسهٔ منتخب هر دو از Claude 4.5 Opus استفاده میکنند و openJiuwen 82.6% در برابر 79.2% گزارش میکند. حتی آنجا نیز مقایسه در سطح سامانه است، نه حذف کنترلشدهٔ مهار. مقاله میپذیرد که مطالعات گستردهتر و حذفهای جزئیتر برای جدا کردن سهم سازوکارهای منفرد لازم است.
این موضوع نحوهٔ استفاده از نتایج را تغییر میدهد. شواهد معیار از این ادعا پشتیبانی میکند که openJiuwen بهعنوان سامانهٔ کامل عامل رقابتی است. هنوز تثبیت نمیکند که Rail، Goal Mode، سازگاری بافت یا هر سازوکار منفرد دیگر علت بهرهٔ گزارششده باشد. خود مقاله این محدودیت را برجسته میکند: فاصلهٔ جدول ردهبندی را نباید با اثر خالص مهار یکی گرفت، بهویژه وقتی مدل ستون فقرات، دستور و مجموعهٔ ابزار همتراز نشدهاند.
تیمهای مهندسی چه چیزی را باید معیار کنند
یک ارزیابی مفید باید مدل، تلاش استدلال، مجموعهٔ ابزار، بودجهٔ توکن و محیط را تا حد ممکن ثابت نگه دارد، سپس اجزای مهار را یکییکی تغییر دهد. این نشان میدهد آیا سازگاری بافت، بازخورد LSP، منطق توقف، بازتاب یا هماهنگی چندعاملی واقعاً به نرخ تکمیل، تأخیر، هزینه یا قابلیت اطمینان کمک میکند.
تیمها همچنین باید رفتار شکست را بسنجند، نه فقط نرخهای عبور تجمیعی. عاملهای افقبلند میتوانند با حلقه زدن، فراموش کردن قیود، تمام کردن بودجه، استفادهٔ بیش از حد از ابزار، توقف پیش از برآورده شدن معیارهای پذیرش، یا حمل بافت کهنه به جلو شکست بخورند. این حالتهای شکست مستقیماً به سازوکارهای کنترلیای نگاشت میشوند که openJiuwen میکوشد صورتبندی کند.
پیامد عملی از این پروژه فراتر میرود. ارزیابی عامل به سوی انضباط پشتهٔ کامل حرکت میکند. امتیاز مدل بهتنهایی ناکافی است وقتی مهار کنترل میکند مدل چه میبیند، کدام ابزار را میتواند به کار ببرد، کی تلاش مجدد کند و کی توقف کند. مهندسی قابلبازتولید عامل بیش از پیش به مقایسههای همتراز با مدل و حذف مهار نیاز خواهد داشت، بهویژه وقتی ادعاهای پروژه بهره را به هماهنگی نسبت میدهند.
چرا مقاله ارزش دنبال کردن دارد
openJiuwen هنوز پیشچاپ است و ارزیابی فعلی به SWE-bench Verified و Terminal-Bench 2.1 محدود است. خود نویسندگان خواستار مطالعات کنترلشدهٔ گستردهتر روی معیارها، مدلها و پیکربندیهای بیشترند. هنوز مبنایی برای تلقی سامانه بهعنوان برتر همگانی یا اثباتشده در تولید وجود ندارد.
آنچه کار را قابل انتشار میکند ترکیب پیادهسازی متنباز قابلبازرسی، معماری مشخص مهار و شواهد معیاری است که میتوان حسابرسی کرد، نه اینکه به ارزش ظاهری تکرار شود. قویترین سهم، صورتبندی کنترل زمان اجرا بهعنوان لایهٔ مهندسیای است که میتوان مستقل از وزنهای مدل تغییرش داد.
برای توسعهدهندگان و معماران، این پرسش ارزیابی دقیقتری میسازد: نه «کدام مدل کدنویسی بهترین است؟»، بلکه «کدام پیکربندی مدل بهعلاوهٔ مهار، نتایج قابلاطمینانی زیر بودجه و مرز کنترل ثابت تولید میکند؟» اجرای این معیار دشوارتر است، اما بسیار نزدیکتر به رفتار واقعی سامانههای عامل تولیدی است.
منابع
- https://arxiv.org/abs/2608.27969
- https://github.com/openJiuwen-ai/jiuwenswarm